>>>> gd2md-html alerte : lien d'image intégré dans la source générée et stockage des images sur votre serveur. REMARQUE : Les images dans le fichier zip exporté de Google Docs peuvent ne pas apparaître dans le même ordre que dans votre document. Veuillez vérifier les images !
----->
Une équipe de chercheurs vient de créer une version plus petite et moins chère d'un grand modèle d'IA. La version plus petite s'est avérée plus intelligente que la version dont elle était issue.
Cela ne devrait pas arriver.
C'est comme perdre du muscle et devenir plus fort en même temps. Mais un groupe de Multiverse Computing affirme l'avoir fait, et la raison en dit long sur la façon dont nous avons mal réduit l'IA jusqu'à présent.
« Pour les praticiens, le message pratique est que dans un pipeline de guérison basé sur la distillation, l'étape de quantification n'est pas un coût à minimiser, mais une opportunité supplémentaire de supervision par un "enseignant", produisant un modèle qui est simultanément moins cher à déployer, plus léger en mémoire et au moins aussi précis que son homologue à pleine précision », ont écrit les chercheurs dans un article publié vendredi.
Imaginez les paramètres d'un modèle d'IA comme un immense mur de boutons – des nombres qui contiennent tout ce qu'il a appris. Plus de boutons, modèle plus intelligent, mais plus lourd à exécuter. Le GPT-OSS 120B d'OpenAI possède 120 milliards de ces boutons. Chacun d'eux coûte de la mémoire et de l'électricité.
Pour déployer l'IA à moindre coût, les entreprises suppriment des boutons et réduisent les survivants. C'est comme compresser une photo : un fichier plus petit, mais trop de compression et l'image devient floue (comme passer du 4K au 720p). Trop réduire un modèle et il devient moins performant. Tout le monde acceptait ce compromis.
Ces chercheurs sont allés plus loin. Ils ont réduit GPT-OSS à 60 milliards de paramètres et ont compressé chacun d'eux dans un minuscule emplacement de 4 bits – l'équivalent numérique d'une compression extrême. Normalement, cela viderait le modèle de sa substance, mais ces chercheurs ont trouvé un moyen de l'améliorer réellement.
Dans presque tous les benchmarks utilisés pour la comparaison, le modèle plus petit a surpassé un modèle qui avait été construit avec une précision complète.
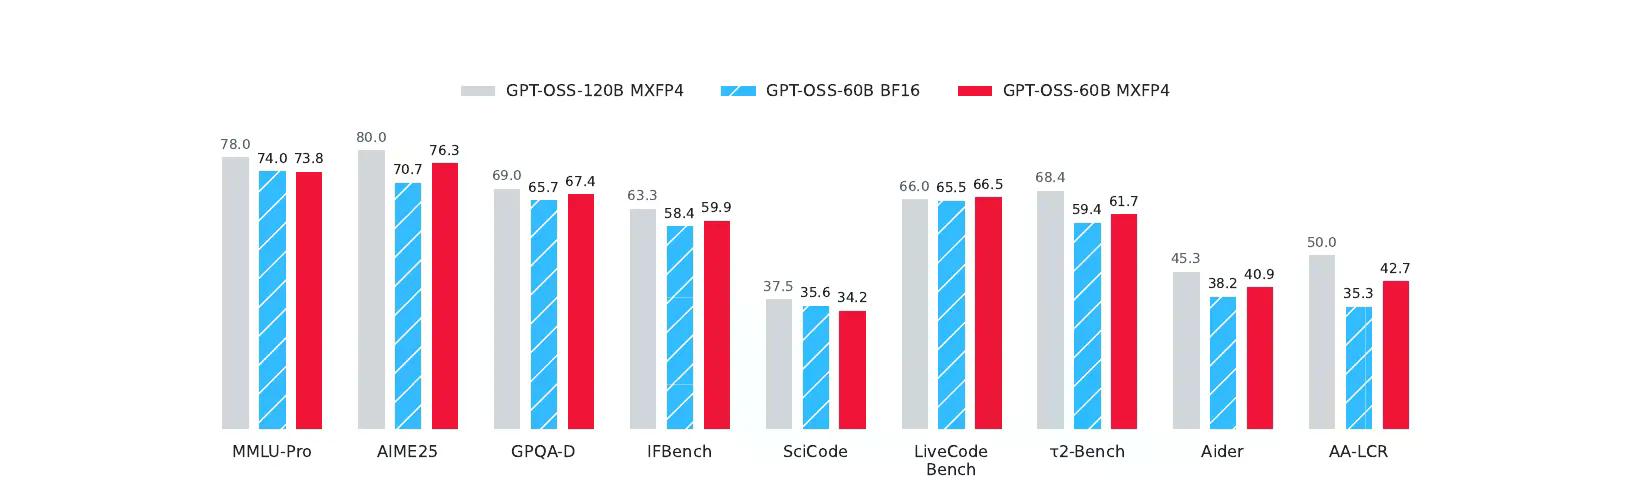
Lorsque vous réduisez un modèle, vous corrigez généralement ses erreurs en le comparant à la version « à moitié réduite » – celle avec 60 milliards de boutons et une précision plus élevée. Le problème est que le modèle intermédiaire est déjà une copie floue de l'original. Vous enseignez donc au petit modèle à imiter un jumeau imparfait. Il ne pourra jamais surpasser ce jumeau.
Ce que ces chercheurs appellent le « Quantization-Aware Healing » (Guérison Sensible à la Quantisation) modifie la cible. Il renvoie le petit modèle vers l'original grand et non compressé et dit : copie les réponses de celui-ci. Le petit modèle apprend du maître, et non de l'intermédiaire confus. Sur 7 des 9 tests, le modèle de 4 bits et 60 milliards de paramètres a battu le jumeau de 60 milliards censé être sa meilleure moitié. Le véritable modèle de 120 milliards de paramètres gagne toujours la plupart des rounds – la taille n'a pas été abolie – mais la version « allégée » a franchi une étape que personne ne croyait possible.
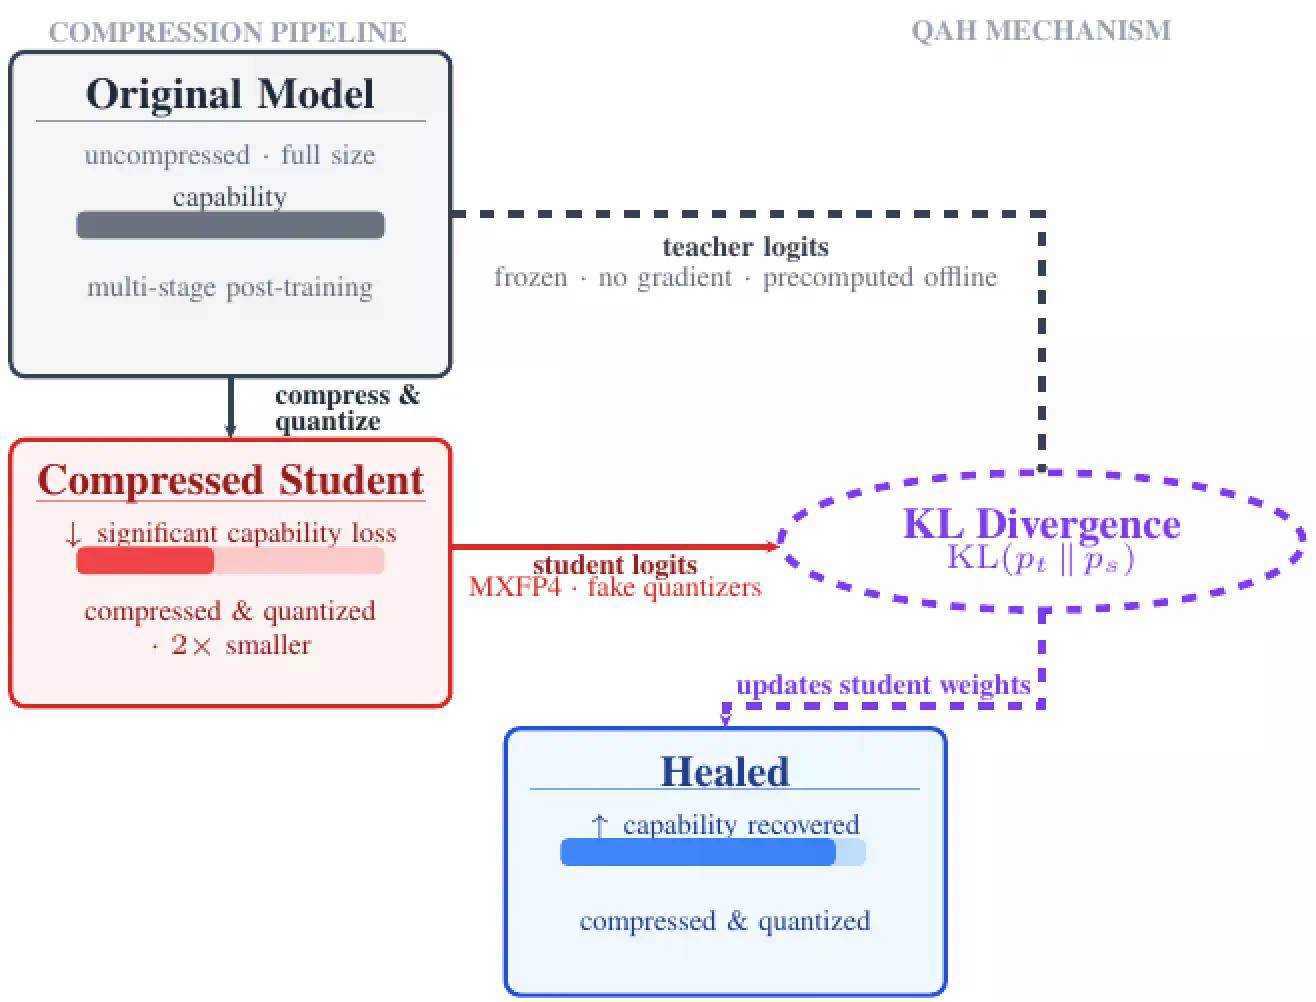
Plus petit et plus intelligent est une avancée majeure car l'IA est gourmande en matériel. Le modèle « guéri » nécessite environ un quart de la mémoire et la moitié des paramètres de l'original. C'est la différence entre une IA qui réside dans un centre de données et une qui tient sur un bon ordinateur de bureau – ou, à terme, sur votre téléphone.
Ainsi, un modèle capable de produire de meilleurs résultats tout en consommant moitié moins d'énergie représente beaucoup pour les petits laboratoires et les développeurs locaux.
C'est aussi gratuit. L'équipe a publié le modèle « guéri » Hypernova-60B en tant que poids ouverts sur Hugging Face, afin que tout le monde puisse le télécharger et l'exécuter. Cela s'inscrit dans une série de modèles ouverts qui franchissent des seuils surprenants : un mystérieux modèle gratuit, Ox Alpha, a récemment battu un système Claude sans développeur connu derrière lui, le battage médiatique autour de Qwen 3.8 Flash Next d'Alibaba, et la vague de finetunes qui améliorent les petits modèles en utilisant les traces de raisonnement de grands LLM comme Fable ou Claude Opus.
Cependant, ne vous emballez pas trop vite. L'outil de réduction qui fabrique l'« élève » de 60 milliards de paramètres est propriétaire, donc la recette n'est pas encore entièrement ouverte, et l'équipe n'a testé que GPT-OSS – et non les familles Llama, Qwen ou Mistral.