Anthropic a lancé Claude Opus 5.5 mardi, le premier modèle de ce que l’entreprise appelle sa famille Claude 5.5. Anthropic affirme que ce nouveau modèle atteint le niveau de Claude Fable 5.1, son flagship le plus onéreux, sur la plupart des tâches.
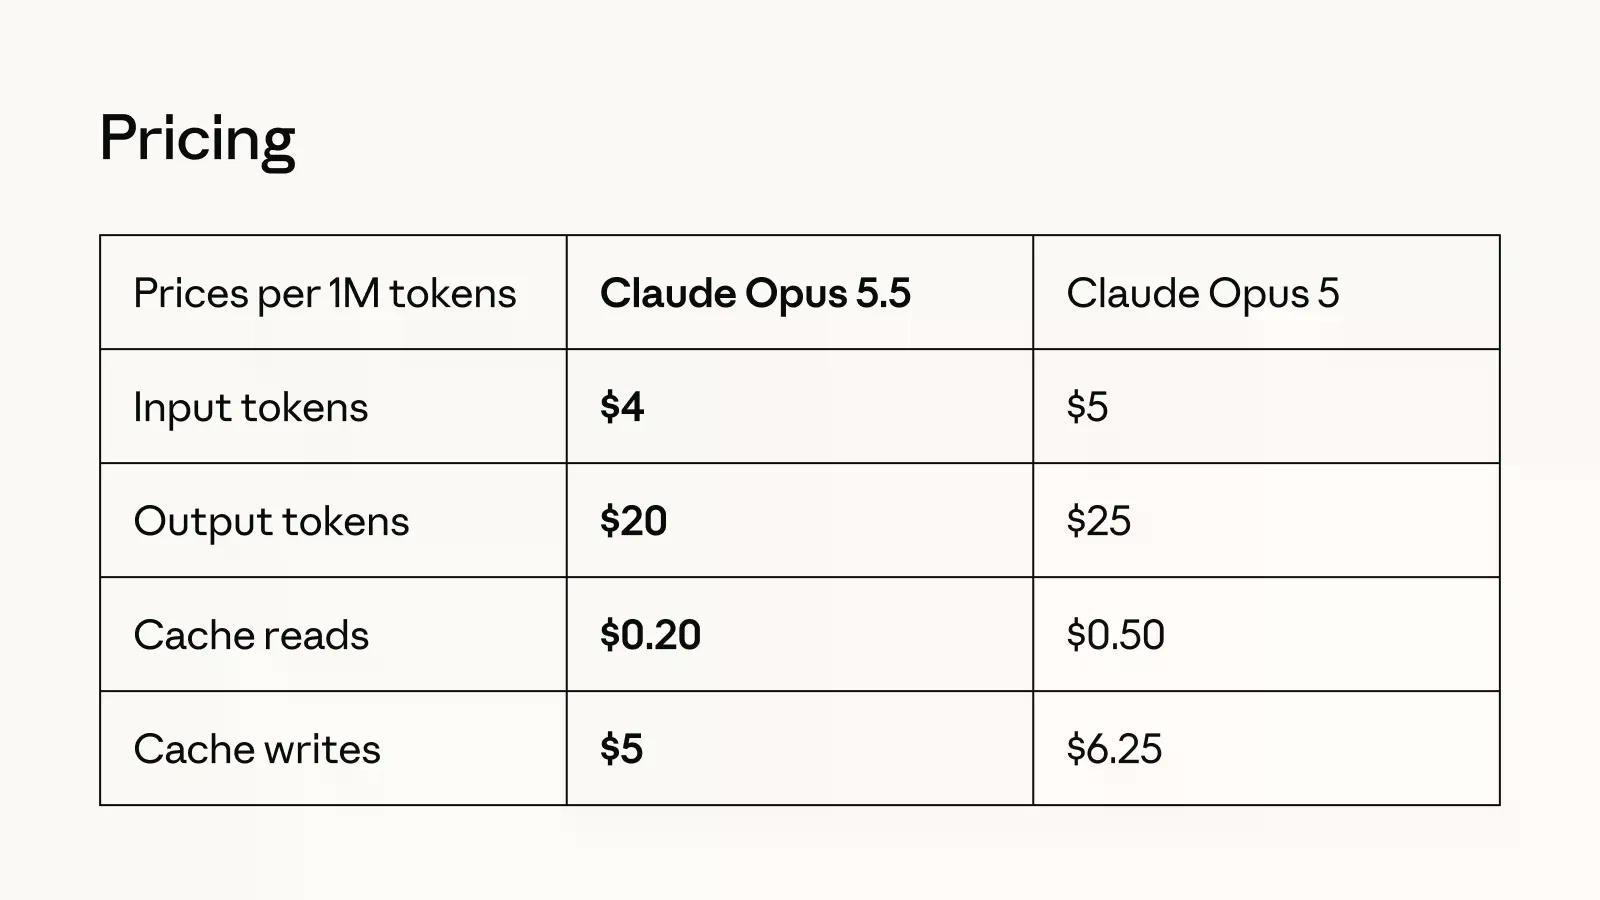
Le point notable, c’est que ce modèle coûte 20 % de moins à exploiter qu’Opus 5, qu’il remplace, et qu’il est 60 % moins cher que Fable 5.1, l’offre la plus avancée de l’entreprise.
Le modèle semble, à l’évidence, très performant. C’est le modèle le plus avancé à la fois en version (5.5 contre 5.1 pour Fable) et en famille (Opus est le plus grand modèle disponible publiquement, suivi de Sonnet, Haiku étant le plus petit).
Anthropic reconnaît que l’écart entre Fable et Opus est plus étroit que ne le suggèrent les scores de benchmark, mais le fait qu’il soit publiquement disponible dans les forfaits, et moins cher par token, en fait le choix évident pour la plupart des utilisateurs de Claude.
Opus 5 a été lancé en juillet avec un prix inférieur et de meilleurs scores que Fable 5 sur la plupart des benchmarks, puis Fable 5.1 est arrivé début septembre et a inversé la tendance, surpassant Opus 5 sur tous les benchmarks publiés par Anthropic.
Opus 5.5 réduit de nouveau l’écart, cette fois sur le prix plutôt que sur les scores bruts. Lovable, une plateforme pour développeurs qui avait soumis Opus 5 à ses propres tests de codage en juillet, a déclaré dans un communiqué partagé par Anthropic que le modèle précédent était « plus stable, avec bien moins de variance d’une exécution à l’autre » que ce qui existait auparavant — le même argument d’efficacité qu’Anthropic remet aujourd’hui en avant.
Opus 5.5 est aussi le premier modèle lancé par Anthropic depuis que le CEO Dario Amodei a publié un essai appelant l’industrie à ralentir, estimant que les gains de capacités de l’IA dépassent les tests de sécurité censés les contenir. « Nous devons ralentir le rythme auquel nous améliorons les capacités des modèles d’IA », a écrit Amodei plus tôt ce mois-ci.
Anthropic mesure l’essentiel de ces progrès via le codage agentique — un travail réalisé par un agent d’IA, c’est-à-dire un modèle qui entreprend de lui-même des actions en plusieurs étapes au lieu de simplement répondre à un prompt unique.
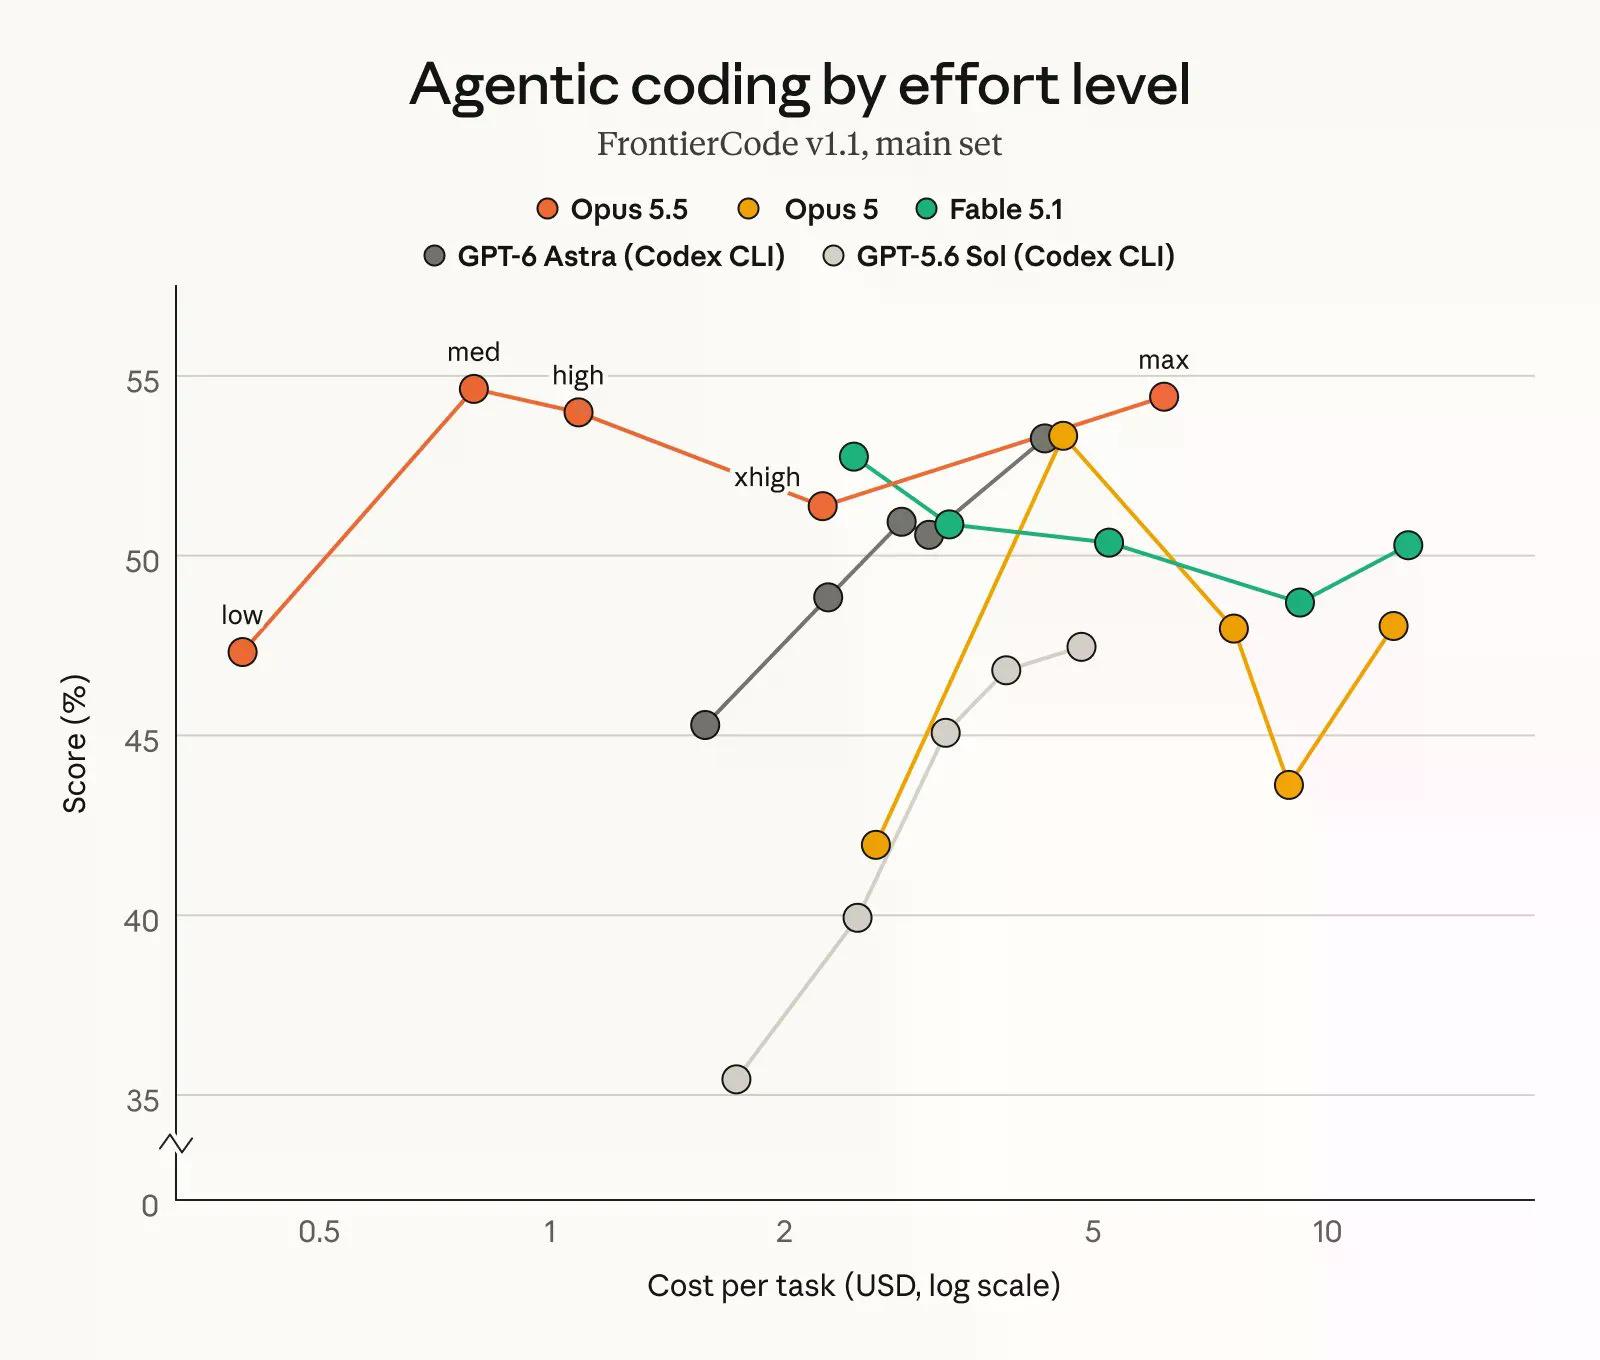
Sur Terminal-Bench 4.0, qui teste la capacité d’un agent à accomplir des tâches professionnelles complexes dans une interface en ligne de commande et note le résultat en pourcentage de tâches terminées, Opus 5.5 a atteint 66,4 %, devant les 55,8 % de Fable 5.1 et les 57,9 % de GPT-6 Astra. FrontierCode, qui vérifie si les modifications de code d’un agent seraient effectivement fusionnées dans un véritable pipeline d’ingénierie en utilisant le même scoring par taux de réussite, a attribué 54,4 % à Opus 5.5 contre 50,3 % à Fable 5.1.
Sur GDPval-AA v2.1, qui évalue le travail professionnel réel dans 44 métiers à l’aide d’Elo — le même système de classement de type échecs utilisé pour mesurer une compétence relative plutôt qu’un simple pourcentage — Opus 5.5 a obtenu 1846, contre 1735 pour Fable 5.1 et 1708 pour Opus 5.
Opus 5.5 n’est toutefois pas en tête partout. Sur AutomationBench, un benchmark conçu par Zapier qui mesure si un agent peut exécuter un workflow métier complet du début à la fin sans aide humaine, GPT-6 Astra, avec 41,4 %, devance légèrement les 40,0 % d’Opus 5.5.
Sur Terminal-Bench-Science 0.1, qui teste la recherche scientifique agentique réalisée dans un environnement en ligne de commande avec la même méthode de taux de réussite, les 64,6 % d’Astra surpassent plus nettement les 58,7 % d’Opus 5.5.
L’argument commercial majeur reste le coût. Les tokens d’entrée — les segments de texte qu’un modèle lit et écrit, facturés par million — passent désormais à 4 $ pour Opus 5.5 contre 5 $ pour Opus 5, tandis que les tokens de sortie tombent à 20 $ contre 25 $. Les lectures de cache, qui consistent à réutiliser un contexte qu’un modèle a déjà traité au lieu de le retraiter depuis zéro et qui représentent l’essentiel des coûts lors de longues sessions de codage agentique, chutent de 60 % à 0,20 $ par million de tokens.
Parce qu’Opus 5.5 atteint le niveau des modèles de classe Mythos d’Anthropic — le niveau le plus restreint de l’entreprise, réservé aux chercheurs accrédités en cybersécurité et en biologie — sur ces deux capacités, il est lancé avec les mêmes garde-fous que Fable 5.1.
La plupart des tâches de cybersécurité sont automatiquement redirigées vers l’ancien Opus 4.8, un point dont de nombreux développeurs et utilisateurs s’étaient déjà plaints.
Opus 5.5 est désormais disponible sur l’ensemble des plateformes d’Anthropic, notamment Amazon Web Services, Google Cloud et Microsoft Azure. Sonnet 5.5 et Haiku 5.5 suivront dans les prochaines semaines, précise Anthropic, avec les mêmes baisses de prix appliquées au reste de la gamme.