OpenDesign, l'entreprise derrière le site de référence OpenDesign Arena, a soumis cette semaine 13 modèles d'IA à la même série de tâches de conception. Le meilleur score a été obtenu par GPT-6 Astra d'OpenAI. Mais le tout nouveau modèle de DeepSeek, V4.1 Flash, a atteint 98 % de ce score maximal tout en facturant environ 1,4 % du prix le plus élevé.
OpenDesign Arena évalue les modèles sur des tâches de conception courantes—création d'applications web, de tableaux de bord, d'écrans mobiles et de pages de destination—sur 100 points. Trente de ces points vérifient si le résultat correspond réellement au cahier des charges ; les 70 autres évaluent la qualité de la conception en termes de mise en page, de hiérarchie, de couleur et d'adéquation stylistique.
Il est conçu pour répondre à une question plus précise que la plupart des classements d'IA : Quel modèle un web designer professionnel devrait-il réellement utiliser demain ?
Sur cette échelle, GPT-6 Astra a obtenu en moyenne 82,7 points, prenant 11,1 minutes et coûtant 1,61 $ par conception finalisée. DeepSeek V4.1 Flash a marqué 81,2 points, a terminé la tâche en 5,3 minutes et a coûté 0,023 $. Claude Fable 5.1 a obtenu 80,3 points, a pris 12,8 minutes et a coûté 3,66 $.
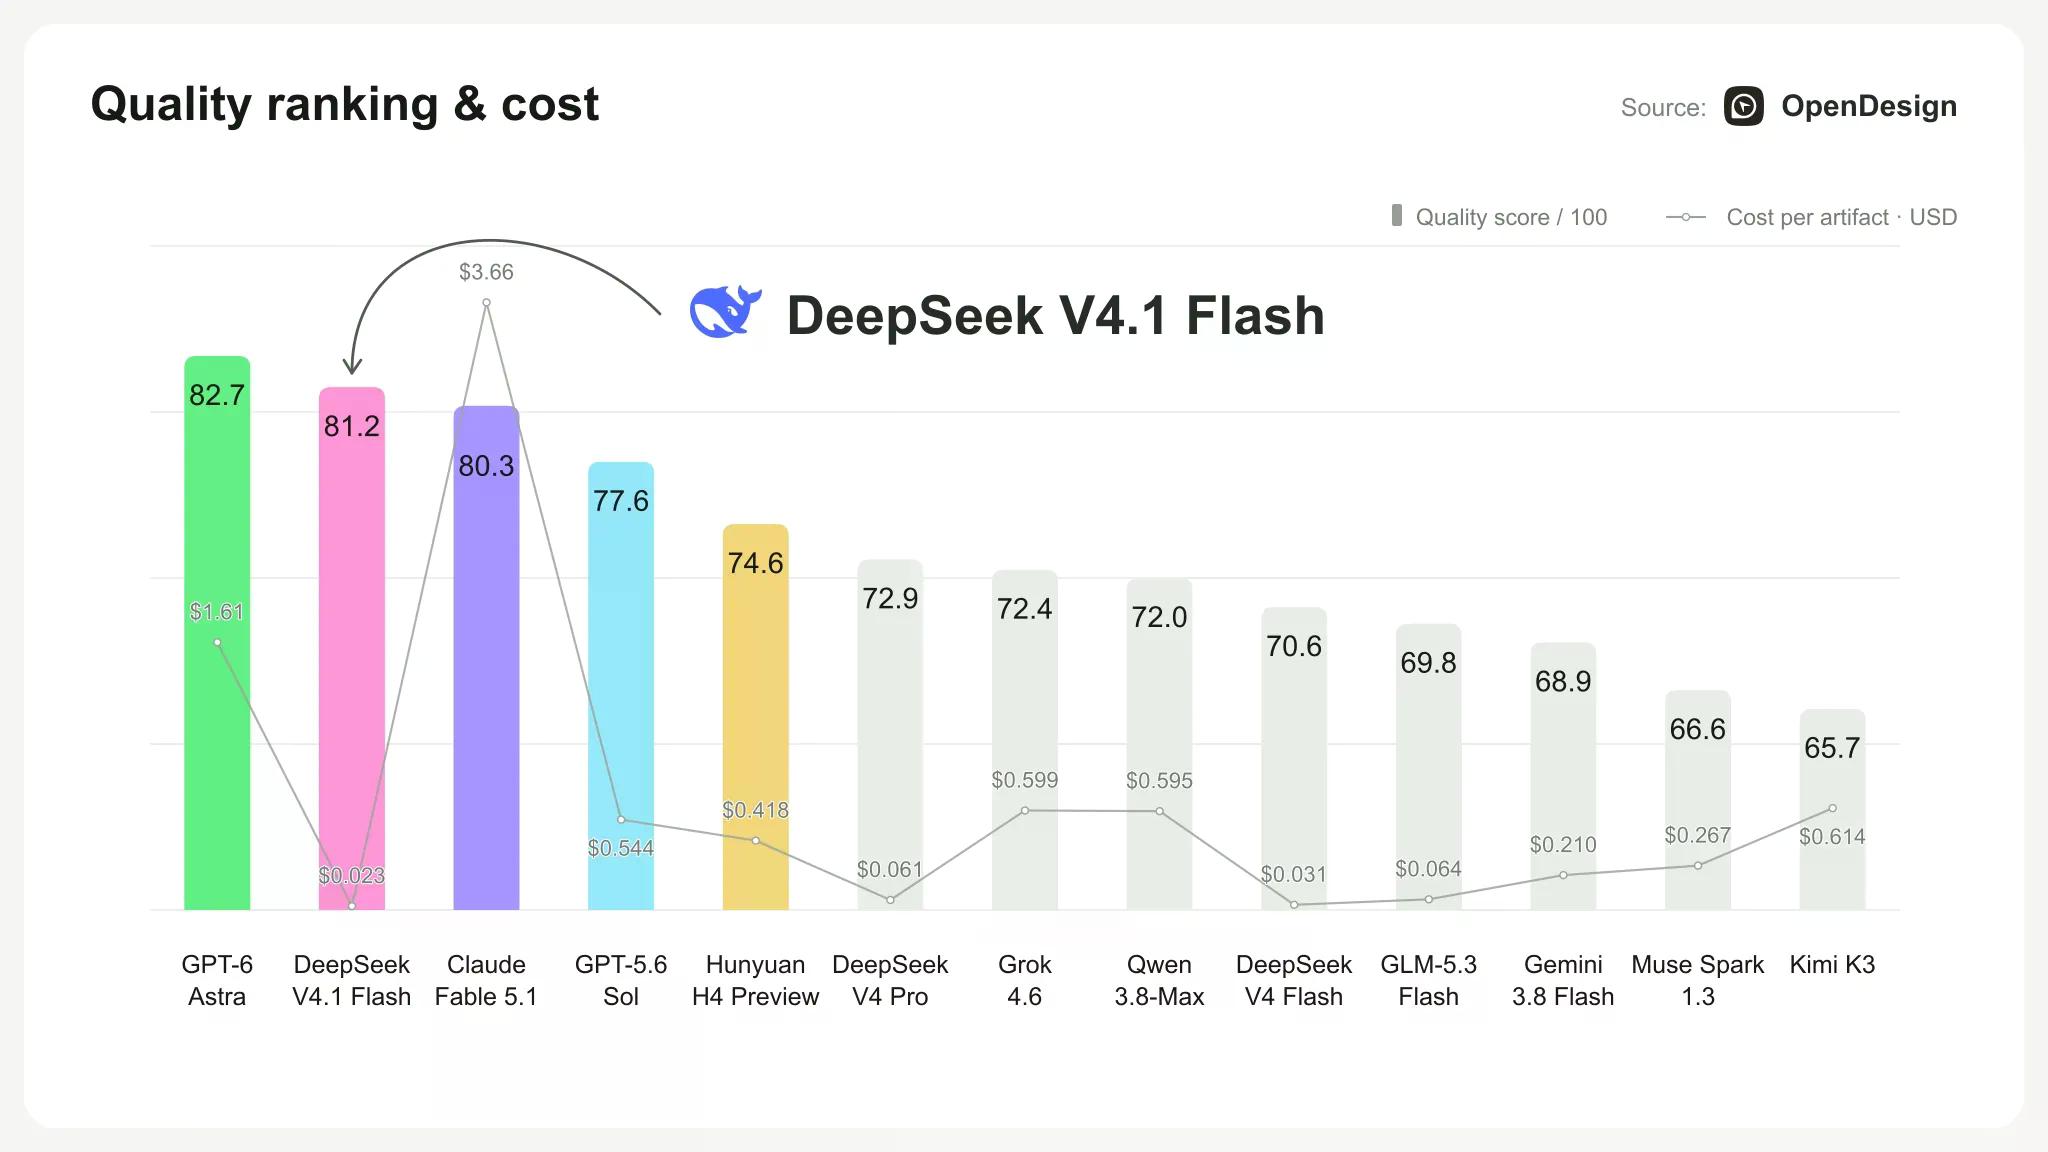
Tous les autres modèles testés par OpenDesign—Grok 4.6, Qwen 3.8-Max, Kimi K3, GLM-5.3 Flash et Gemini 3.8 Flash parmi eux—ont obtenu un score inférieur à celui de DeepSeek V4.1 Flash et ont coûté plus cher à exécuter. Cela représente 11 des 13 modèles testés. Seul GPT-6 Astra l'a surpassé, et ce, d'un point et demi seulement.
Le rapport technique de DeepSeek pour le V4.1 Flash explique d'où proviennent les économies. Le modèle contient un total de 552 milliards de paramètres—les réglages internes qu'un modèle ajuste pendant l'apprentissage pour stocker ce qu'il a appris—mais n'en active que 8 milliards pour lire une instruction entrante et 16 milliards pour écrire la réponse. DeepSeek appelle cela une conception de type Causal Encoder-Decoder, et c'est le même stratagème qui explique les temps d'achèvement rapides du modèle.
Ce n'est pas la première tentative de DeepSeek de combler un écart de capacité à moindre coût. Quelques semaines plus tôt, le modèle V4 Pro de l'entreprise s'était classé à moins de 5 % de Claude Fable 5 lors d'une comparaison de référence distincte, tout en facturant une fraction du tarif de Fable. DeepSeek a également recruté des ingénieurs à Pékin pour construire son propre Code Harness, dans le but de posséder l'intégralité de la pile agentique plutôt que de se contenter de fournir le modèle sous-jacent.
Le protocole de test d'OpenDesign restreint ce que ces chiffres peuvent prouver. Le résultat d'un modèle n'est noté que s'il est rendu comme une page web fonctionnelle en premier lieu ; tout élément vide, cassé ou tronqué obtient un score de zéro et n'est pas retesté. Cela signifie que le benchmark mesure la production de conception fiable et quotidienne, et non la capacité de raisonnement général ou la compétence en codage.
GPT-6 Astra, qu'OpenAI a lancé le 3 septembre, a déjà la réputation de faire un peu de tout—concevoir une carte de circuit imprimé, rédiger une déclaration fiscale, construire une scène 3D—mais les premiers testeurs l'ont signalé comme un rédacteur moins performant que le modèle qu'il a remplacé. Son prix et sa rapidité sur le graphique d'OpenDesign correspondent à cette même conception généraliste : plus lent et plus cher que l'offre moins chère de DeepSeek, mais toujours le meilleur score du domaine.
Le taux de livraison de DeepSeek V4.1 Flash—la proportion de productions qu'OpenDesign a jugées prêtes à être livrées sans révision—s'élevait à 57,7%. Le taux de livraison de GPT-6 Astra était de 60%. Celui de Claude Fable 5.1 était de 56,7%.