

Anthropic a lancé Claude Fable 5.1 et Claude Mythos 5.1 mardi, sa première mise à jour de la gamme de modèles de classe Mythos depuis le lancement de Fable 5 le 9 juin.
L'entreprise affirme que ces nouveaux modèles d'IA sont les « plus avancés au monde pour le codage et le travail de la connaissance », et ce lancement intervient trois mois après un cycle qui a déjà vu un arrêt des contrôles d'exportation de 18 jours, une dispute estivale sur les prix d'accès aux abonnements, et une sortie en juillet de Claude Opus 5 qui a sapé le prix de Fable 5.
Fable 5.1 et Mythos 5.1 sont, selon Anthropic, le même modèle sous-jacent avec des filtres de sécurité différents. Fable 5.1 est généralement disponible pour toute personne possédant un compte Claude. Mythos 5.1 reste réservé aux professionnels de la cybersécurité et des sciences de la vie vérifiés via les programmes de vérification Cyber et Sciences de la Vie d'Anthropic, successeurs de la filière d'accès Project Glasswing qui régulait Mythos 5.
Ce que mesurent réellement les benchmarks
Le chiffre phare d'Anthropic provient de Terminal-Bench-Science 0.1, un benchmark qui teste la capacité d'un agent IA à effectuer des tâches de recherche scientifique dans un environnement de ligne de commande, évalué par un taux de réussite.
Fable 5.1 a atteint 52,6 % contre 24,7 % pour Fable 5 et 29,0 % pour Opus 5, soit plus du double de son prédécesseur.
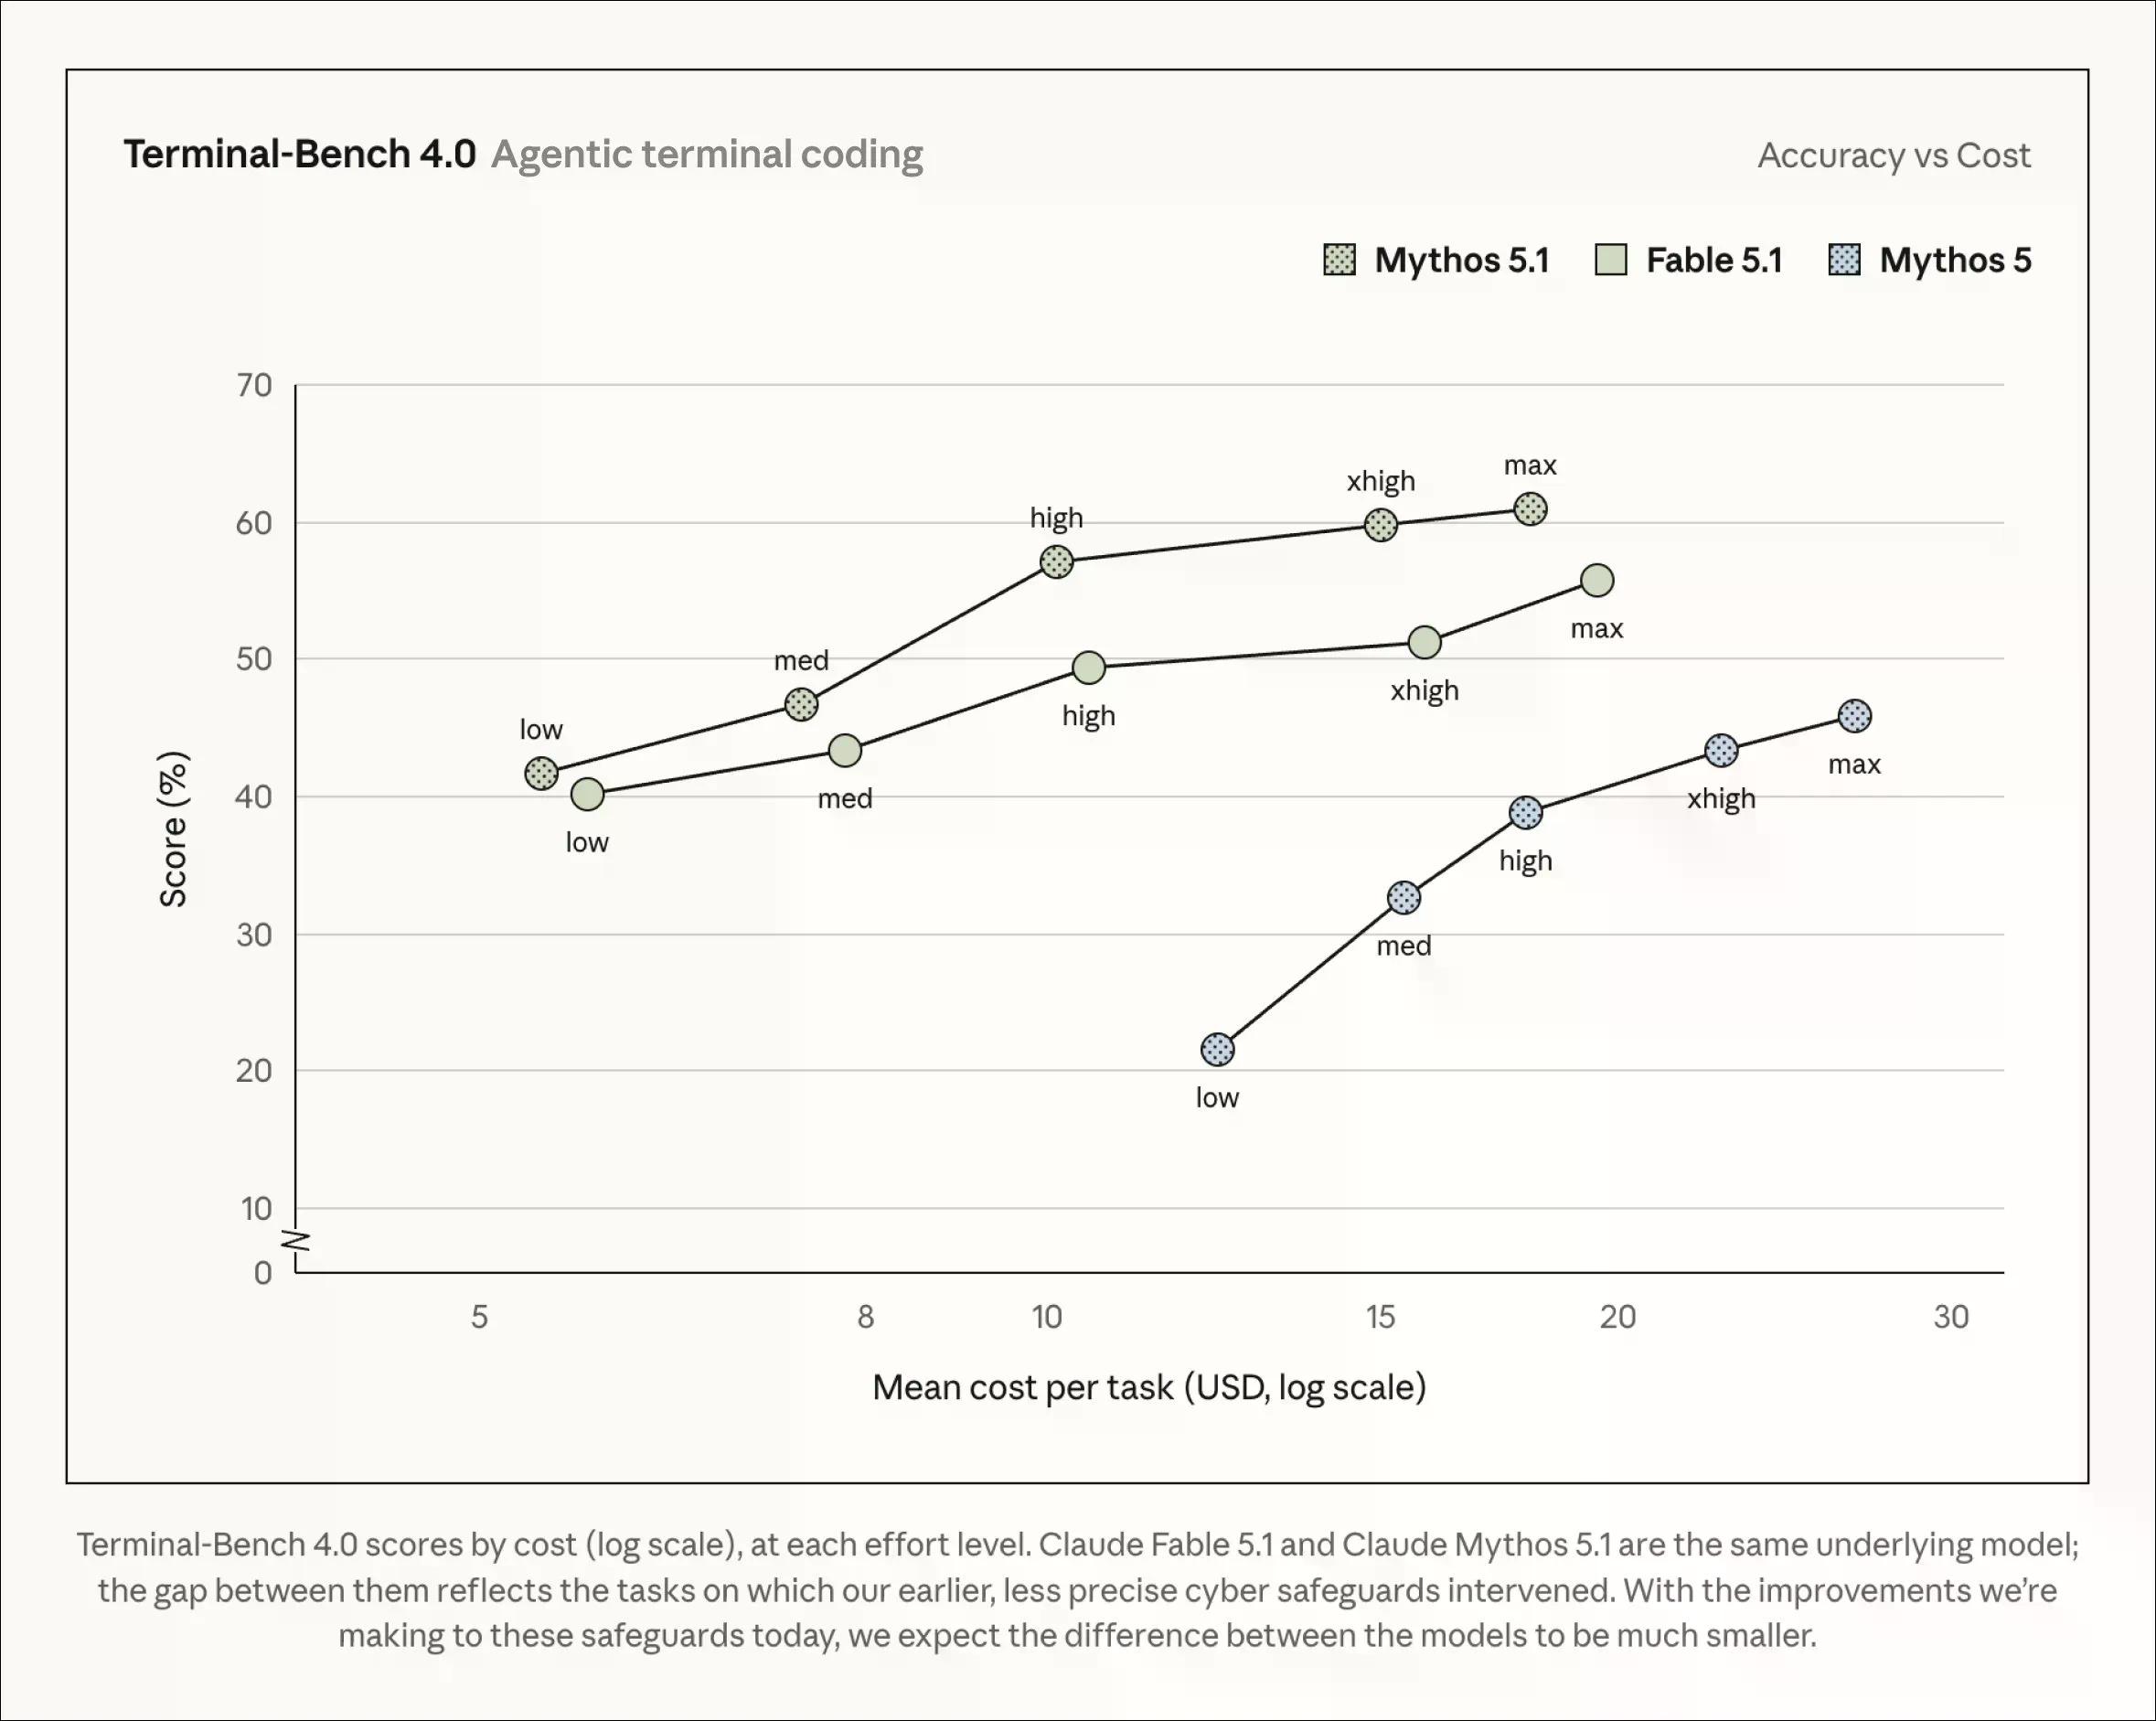
Terminal-Bench 4.0 teste le codage autonome effectué via un terminal – écriture, exécution et débogage de code à travers des sessions de ligne de commande multi-étapes, évalué comme un pourcentage de tâches correctement accomplies. Fable 5.1 a obtenu 55,8 %, en hausse par rapport aux 42,0 % de Fable 5 et devant les 52,3 % d'Opus 5.
Mythos 5.1, fonctionnant avec des filtres de cybersécurité plus légers, a obtenu 60,9 % au même test ; Anthropic affirme que l'écart reflète les tâches que ses garde-fous ont interceptées et redirigées vers Opus 4.8.
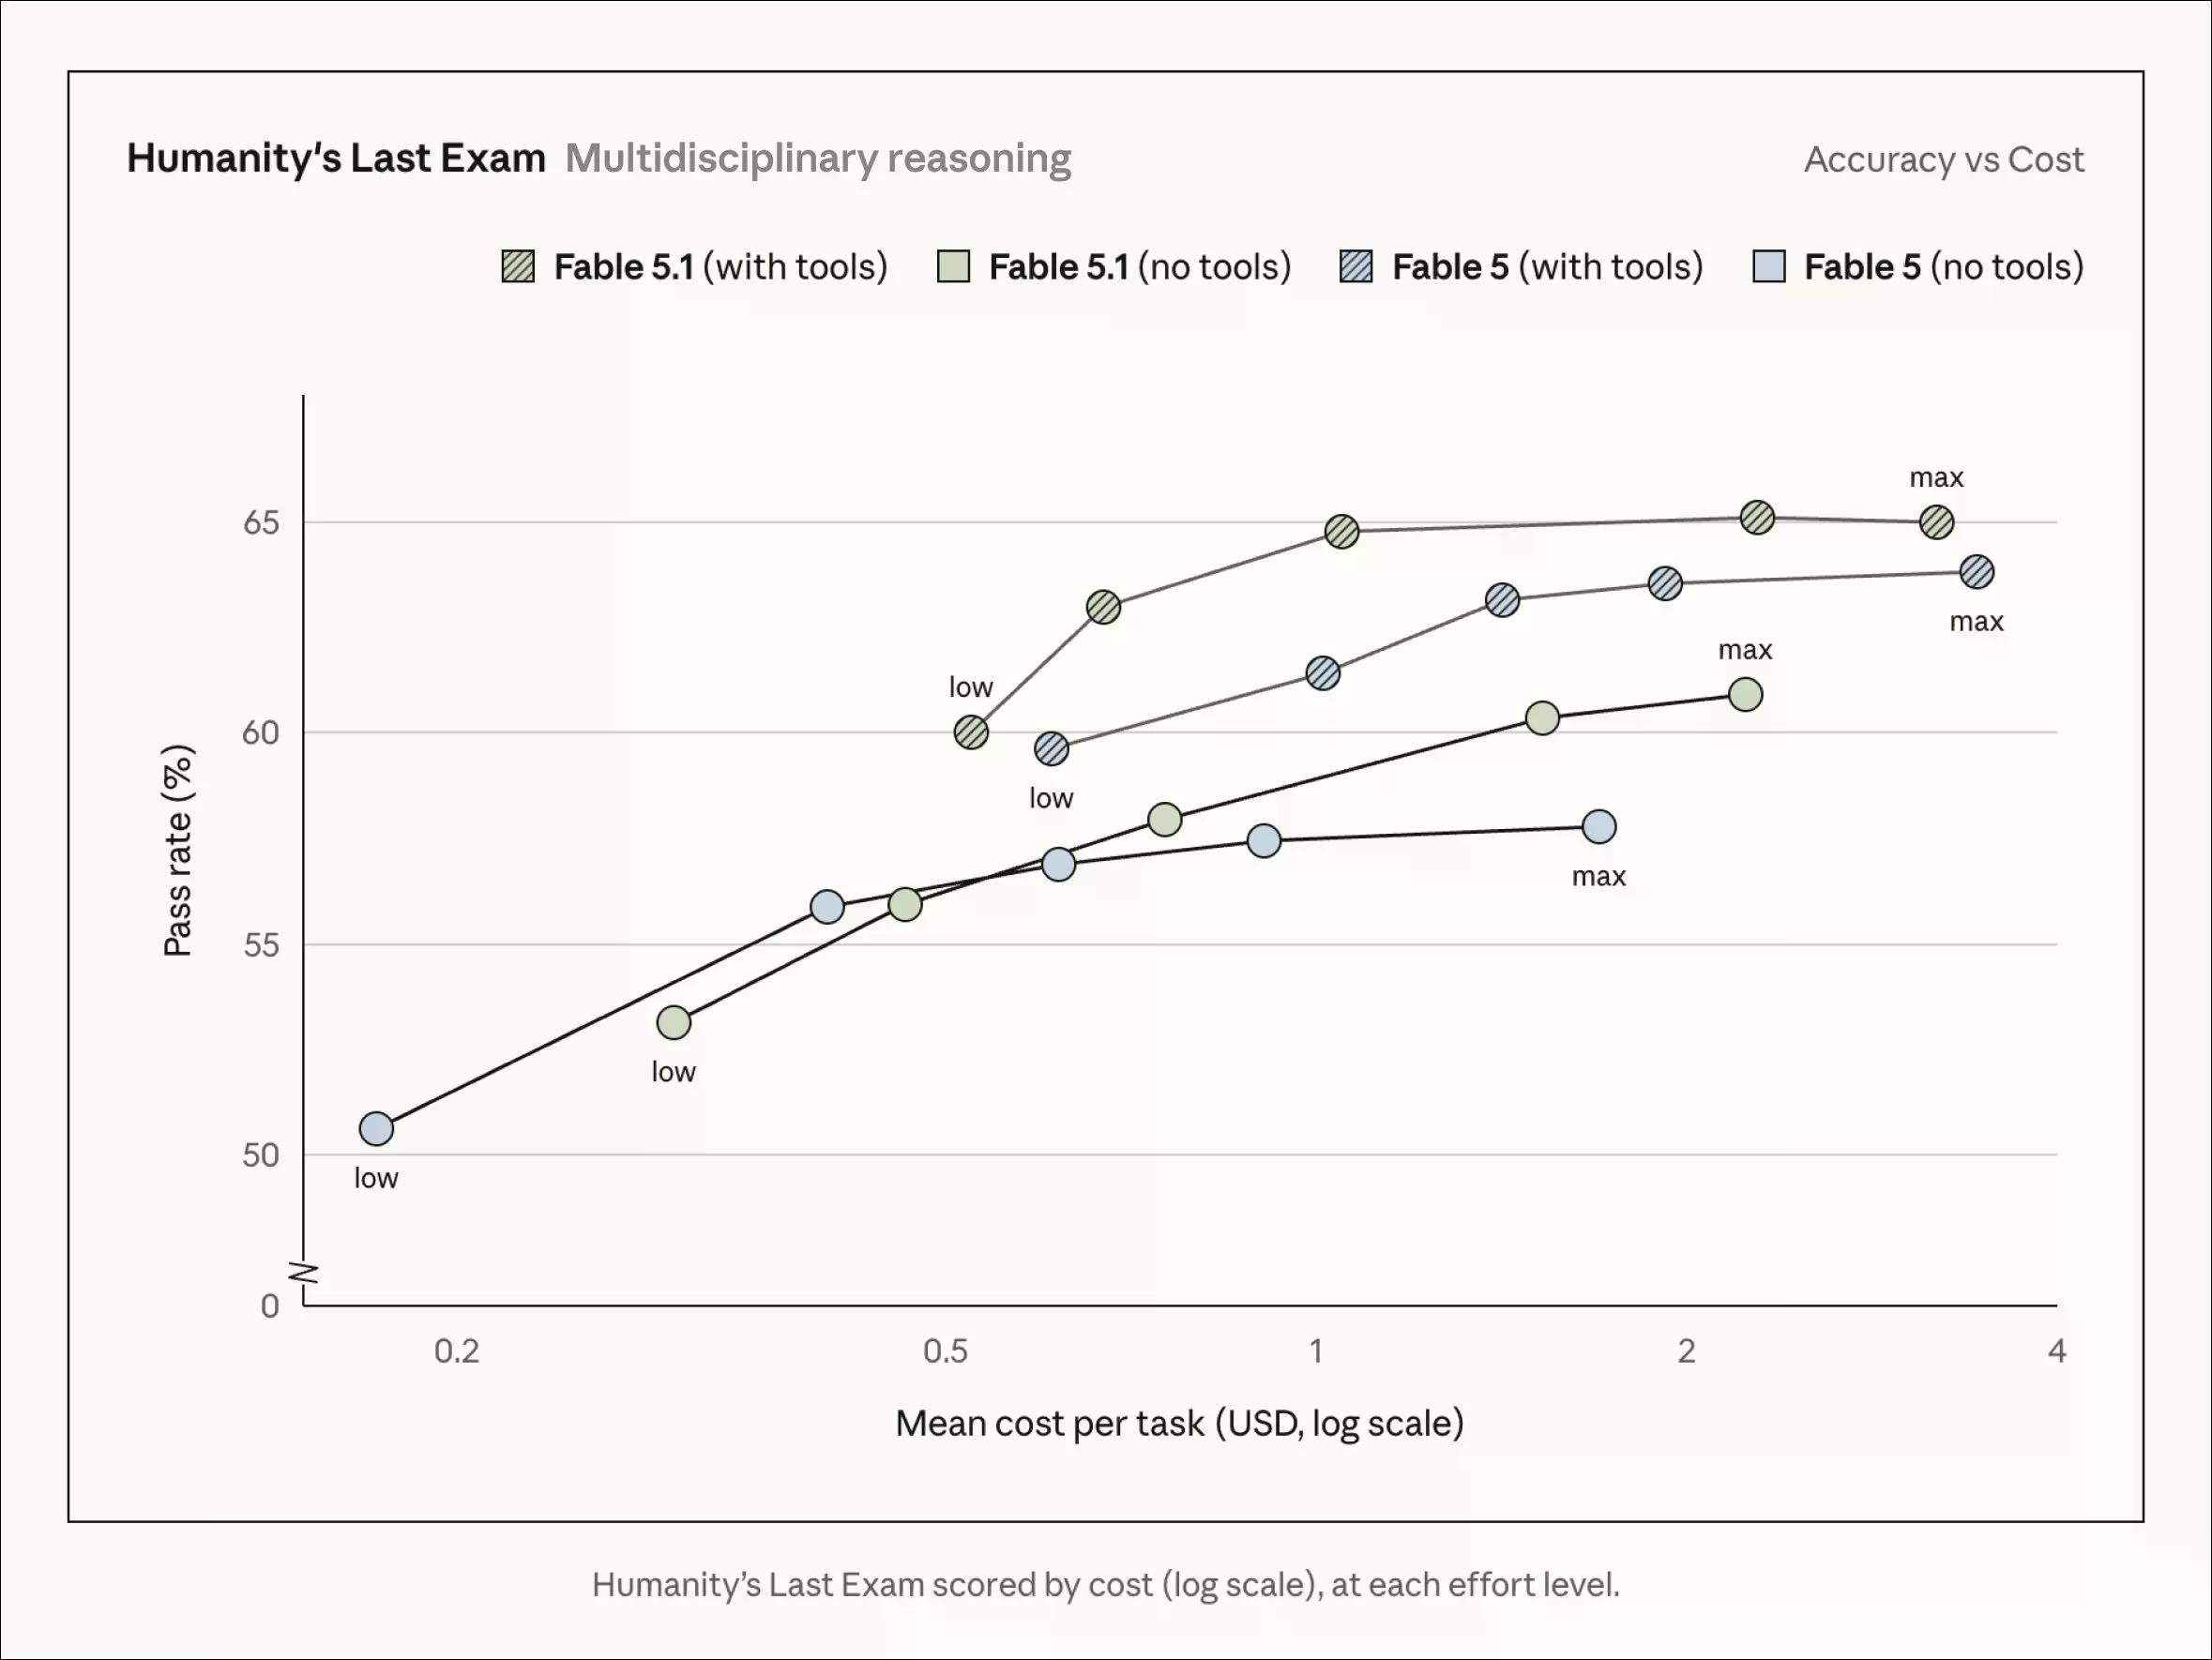
Lors du Humanity's Last Exam, un test de raisonnement multidisciplinaire composé de questions de niveau expert couvrant des dizaines de domaines académiques et évalué par un taux de réussite, Fable 5.1 a atteint 60,9 % sans outils externes et 65,0 % avec, devançant Opus 5 dans les deux cas, démontrant qu'il s'agit du modèle le plus avancé d'Anthropic à des fins académiques.
Où il surpasse Opus 5, et où les calculs se compliquent
Opus 5, lancé en juillet, coûtait la moitié du prix par token de Fable 5 tout en surpassant Fable 5 sur la plupart des benchmarks majeurs, rendant de fait le modèle phare redondant pour la majorité des utilisateurs payants.
Fable 5.1 inverse cette tendance : il surpasse désormais Opus 5 sur tous les benchmarks publiés par Anthropic, y compris ceux où Opus 5 avait auparavant battu Fable 5.
Mais Fable 5.1 coûte toujours deux fois plus cher par token qu'Opus 5 — 10 $ en entrée et 50 $ en sortie contre 5 $ et 25 $ pour Opus 5. Les tokens représentent la quantité de base d'informations qu'un modèle peut traiter (généralement environ les deux tiers d'un mot anglais moyen), et les entreprises paient pour leur utilisation car les flux de travail intensifs épuisent généralement très rapidement les quotas définis dans les abonnements.
La propre argumentation d'Anthropic pour ce modèle s'appuie sur les niveaux d'effort plutôt que sur les scores bruts : elle affirme que l'exécution de Fable 5.1 avec un effort de raisonnement faible ou moyen égale ou surpasse les anciens résultats de Fable 5 à un coût bien moindre, tout en réservant les niveaux d'effort supérieurs aux problèmes qui bloquent tout le reste.
Pour le travail de routine, cet argument en faveur de l'abandon complet d'Opus 5 s'affaiblit à mesure que le niveau d'effort diminue.
L'accès suit la même répartition que celle appliquée à Fable 5 après des mois d'ajustements des conditions par Anthropic. Sur les forfaits Pro et les sièges d'équipe ou d'entreprise standard, Fable 5.1 utilise entièrement les crédits d'utilisation à la consommation facturés au tarif API, car il ne fait pas partie des limites hebdomadaires de ces forfaits. Sur les forfaits Max et les sièges d'équipe ou d'entreprise premium, il est inclus en tant que partie standard de l'abonnement, jusqu'à 50 % de l'utilisation hebdomadaire.
Claude Fable 5.1 est désormais disponible sur l'API Claude, Amazon Bedrock, Google Cloud et Microsoft Foundry, sous l'ID de modèle "claude-fable-5-1".








