


xAI của Elon Musk đã phát hành Grok 4.7 vào chiều thứ Hai, gọi đây là mô hình tốt nhất của hãng từ trước đến nay, đồng thời mô tả nó là "một bước cải thiện đáng kể so với Grok 4.6 ở cùng mức giá và tốc độ."
Đợt phát hành này diễn ra sau một loạt lần trì hoãn rõ ràng. Kể từ cuối tháng 7, Musk đã lùi mốc thời gian ít nhất năm lần: "còn bốn tuần nữa", rồi "vài tuần nữa", rồi "3 đến 4 tuần", rồi "10 ngày" vào ngày 1 tháng 9, sau đó là "cần thêm vài ngày nữa để hoàn thiện" vào ngày 11 tháng 9.
xAI cho biết mô hình này dành nhiều thời gian hơn để xử lý các bài toán khó và tự kiểm tra lại câu trả lời của mình thường xuyên hơn so với Grok 4.6, đồng thời đi kèm với những hàng rào an toàn mạnh nhất từ trước đến nay theo cách công ty mô tả.
Musk tiếp tục đăng trên X, gọi Grok 4.7 là "sự kết hợp mạnh mẽ giữa trí tuệ, tốc độ và chi phí thấp". Lần này không có danh sách chờ — mô hình đã hoạt động ngay trên ứng dụng Grok, Cursor, Grok Build và API của xAI.
Grok 4.7 đã ra mắt.
Đây là một bước cải thiện đáng kể so với Grok 4.6 ở cùng mức giá và tốc độ. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) ngày 21 tháng 9 năm 2026
Grok 4.7 sở hữu 2,1 nghìn tỷ tham số, tăng 40% so với mức 1,5 nghìn tỷ của Grok 4.6, vốn là phiên bản tinh chỉnh từ Grok 4.5. Chi phí là 2 USD cho mỗi một triệu input token và 6 USD cho mỗi một triệu output token. Tham số là các núm điều chỉnh nội bộ mà mô hình tinh chỉnh trong quá trình huấn luyện; số lượng tham số lớn hơn thường đồng nghĩa với năng lực học các mẫu tốt hơn, trong khi token là đơn vị thông tin cơ bản mà mô hình AI có thể tiếp nhận hoặc tạo ra.
xAI cũng tích hợp thêm dữ liệu huấn luyện bổ sung lấy từ SpaceX, công ty tên lửa của Musk: dữ liệu telemetry từ vệ tinh Starlink, hồ sơ sản xuất và nhật ký lỗi kỹ thuật. Thông điệp mà hãng đưa ra là đây là một mô hình có khả năng suy luận tốt hơn về phần cứng và các hệ thống vật lý so với bất kỳ mô hình nào chỉ được huấn luyện thuần túy trên văn bản Internet.
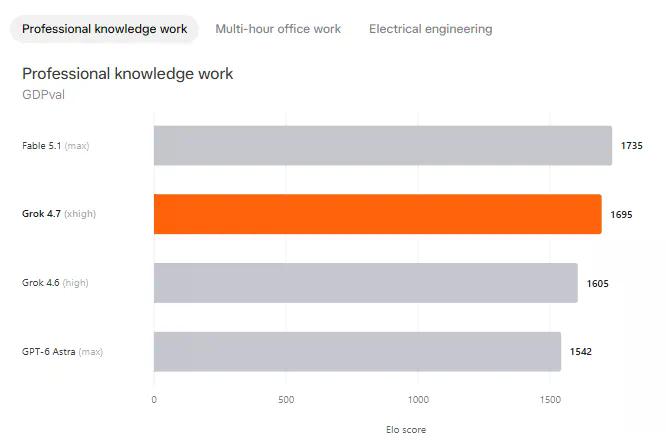
Dù vậy, điểm benchmark kể lại một câu chuyện quen thuộc. GDPval đo lường cách một mô hình xử lý các công việc tri thức thực tế có giá trị kinh tế — ghi chú pháp lý, bảng tính, bộ slide — bằng các tác vụ được thẩm định bởi những chuyên gia đang làm việc trong từng lĩnh vực, và chấm điểm theo hệ Elo, tức cùng hệ thống xếp hạng đối đầu mà cờ vua sử dụng.
Grok 4.7 đạt 1695 điểm trên GDPval. Claude Fable 5.1 dẫn đầu bảng với 1735 điểm.
AA-Briefcase, do Artificial Analysis xây dựng, kiểm tra các tác vụ văn phòng kéo dài nhiều giờ, kết hợp nghiên cứu, phân tích và tạo tài liệu thành một nhiệm vụ dài duy nhất, cũng được chấm theo thang Elo. Grok 4.7 đạt 1657 điểm, so với 1678 điểm của Fable 5.1. Cùng một kết quả, chỉ khác bài test.
CursorBench 4.0, benchmark của Cursor dành cho các tác vụ lập trình thực tế bên trong trình soạn thảo của mình, biểu diễn độ chính xác so với chi phí và số token mà mỗi tác vụ tiêu tốn. Grok 4.7 nằm ở nhóm giữa: chi phí cho mỗi tác vụ cao hơn GPT-6 Astra, phiên bản kế nhiệm GPT-5.6 Sol, và Claude Sonnet 5, nhưng vẫn kém Fable 5.1, mô hình chiến thắng ở mọi mức giá trên biểu đồ.
Đây không phải mô típ mới đối với xAI. Grok 4.5 ra mắt vào tháng 7 với cụm huấn luyện lớn nhất ngành và xếp thứ ba sau Claude và các mô hình của OpenAI. Trước đó, Grok 4.20 đánh đổi độ tin cậy để lấy tốc độ và cá tính. Grok 4.6 cũng tụt lại phía sau nhóm dẫn đầu về khả năng tự chủ trong lập trình.
Tất cả những điều này không khiến Grok 4.7 trở thành một sản phẩm tệ đối với hàng triệu người đang trò chuyện với nó qua X, ứng dụng độc lập, hoặc bảng điều khiển Tesla của họ. Điều đó có nghĩa là mô hình nhiều khả năng sẽ trả lời câu hỏi của bạn, hoặc vận hành trợ lý giọng nói trên xe của bạn, đang chạy trên một hệ thống mà chính benchmark của nhà sản xuất xếp thấp hơn một bậc so với đỉnh bảng.
Khoảng cách đó là lý do vì sao mức giá quan trọng hơn vị trí trên bảng xếp hạng đối với phần lớn người dùng. xAI đã liên tục chào giá thấp hơn Anthropic và OpenAI về chi phí trên mỗi token dù vẫn thua họ về năng lực thuần, đặt cược rằng "đủ tốt, rẻ và ở khắp nơi" sẽ thắng "tốt nhất, nhưng đắt hơn" trong phần lớn nhu cầu sử dụng hằng ngày.
Musk đã hạ kỳ vọng từ vài ngày trước khi ra mắt, viết rằng Grok 4.7 sẽ ở mức "xấp xỉ tương đương" Claude Opus 5.0 của Anthropic, chứ không phải bản Opus 5.1 mới hơn, đồng thời hiệu năng đa phương thức vẫn cần được cải thiện.
Trong cùng bài đăng đó, ông phác thảo ba mô hình tiếp theo: Grok 4.8 sẽ là một bước nâng cấp đáng kể, Grok 4.9 sẽ thuộc "đẳng cấp Astra/Fable", và Grok 5 có thể trở thành một mô hình dẫn đầu frontier. Các bản nâng cấp này hiện vẫn chưa có ngày phát hành. "Hãy chờ xem," ông viết.






