A maioria das pessoas conhece a Xiaomi como a marca chinesa de telefones. Aquela que fabrica patinetes elétricos e purificadores de ar baratos. Não é exatamente a empresa que se esperaria quebrar um grande recorde de velocidade de inferência de IA numa segunda-feira de manhã.
E, no entanto. A Xiaomi acaba de lançar o MiMo-V2.5-Pro-UltraSpeed, um modo de serviço para seu modelo carro-chefe de trilhões de parâmetros que atinge mais de 1.000 tokens por segundo — com picos próximos de 1.200 em demonstrações.
Parâmetros são os pesos numéricos internos que definem como um modelo pensa — quanto mais se tem, mais complexos são os padrões que ele pode reconhecer. Tokens são os blocos de texto que o modelo lê e escreve, aproximadamente três quartos de uma palavra em média.
A Xiaomi conseguiu isso em um único nó de commodity de 8 GPUs. Hardware padrão, sem chips personalizados. Isso muda o cálculo para quem pode realmente implementar esse tipo de velocidade em produção.
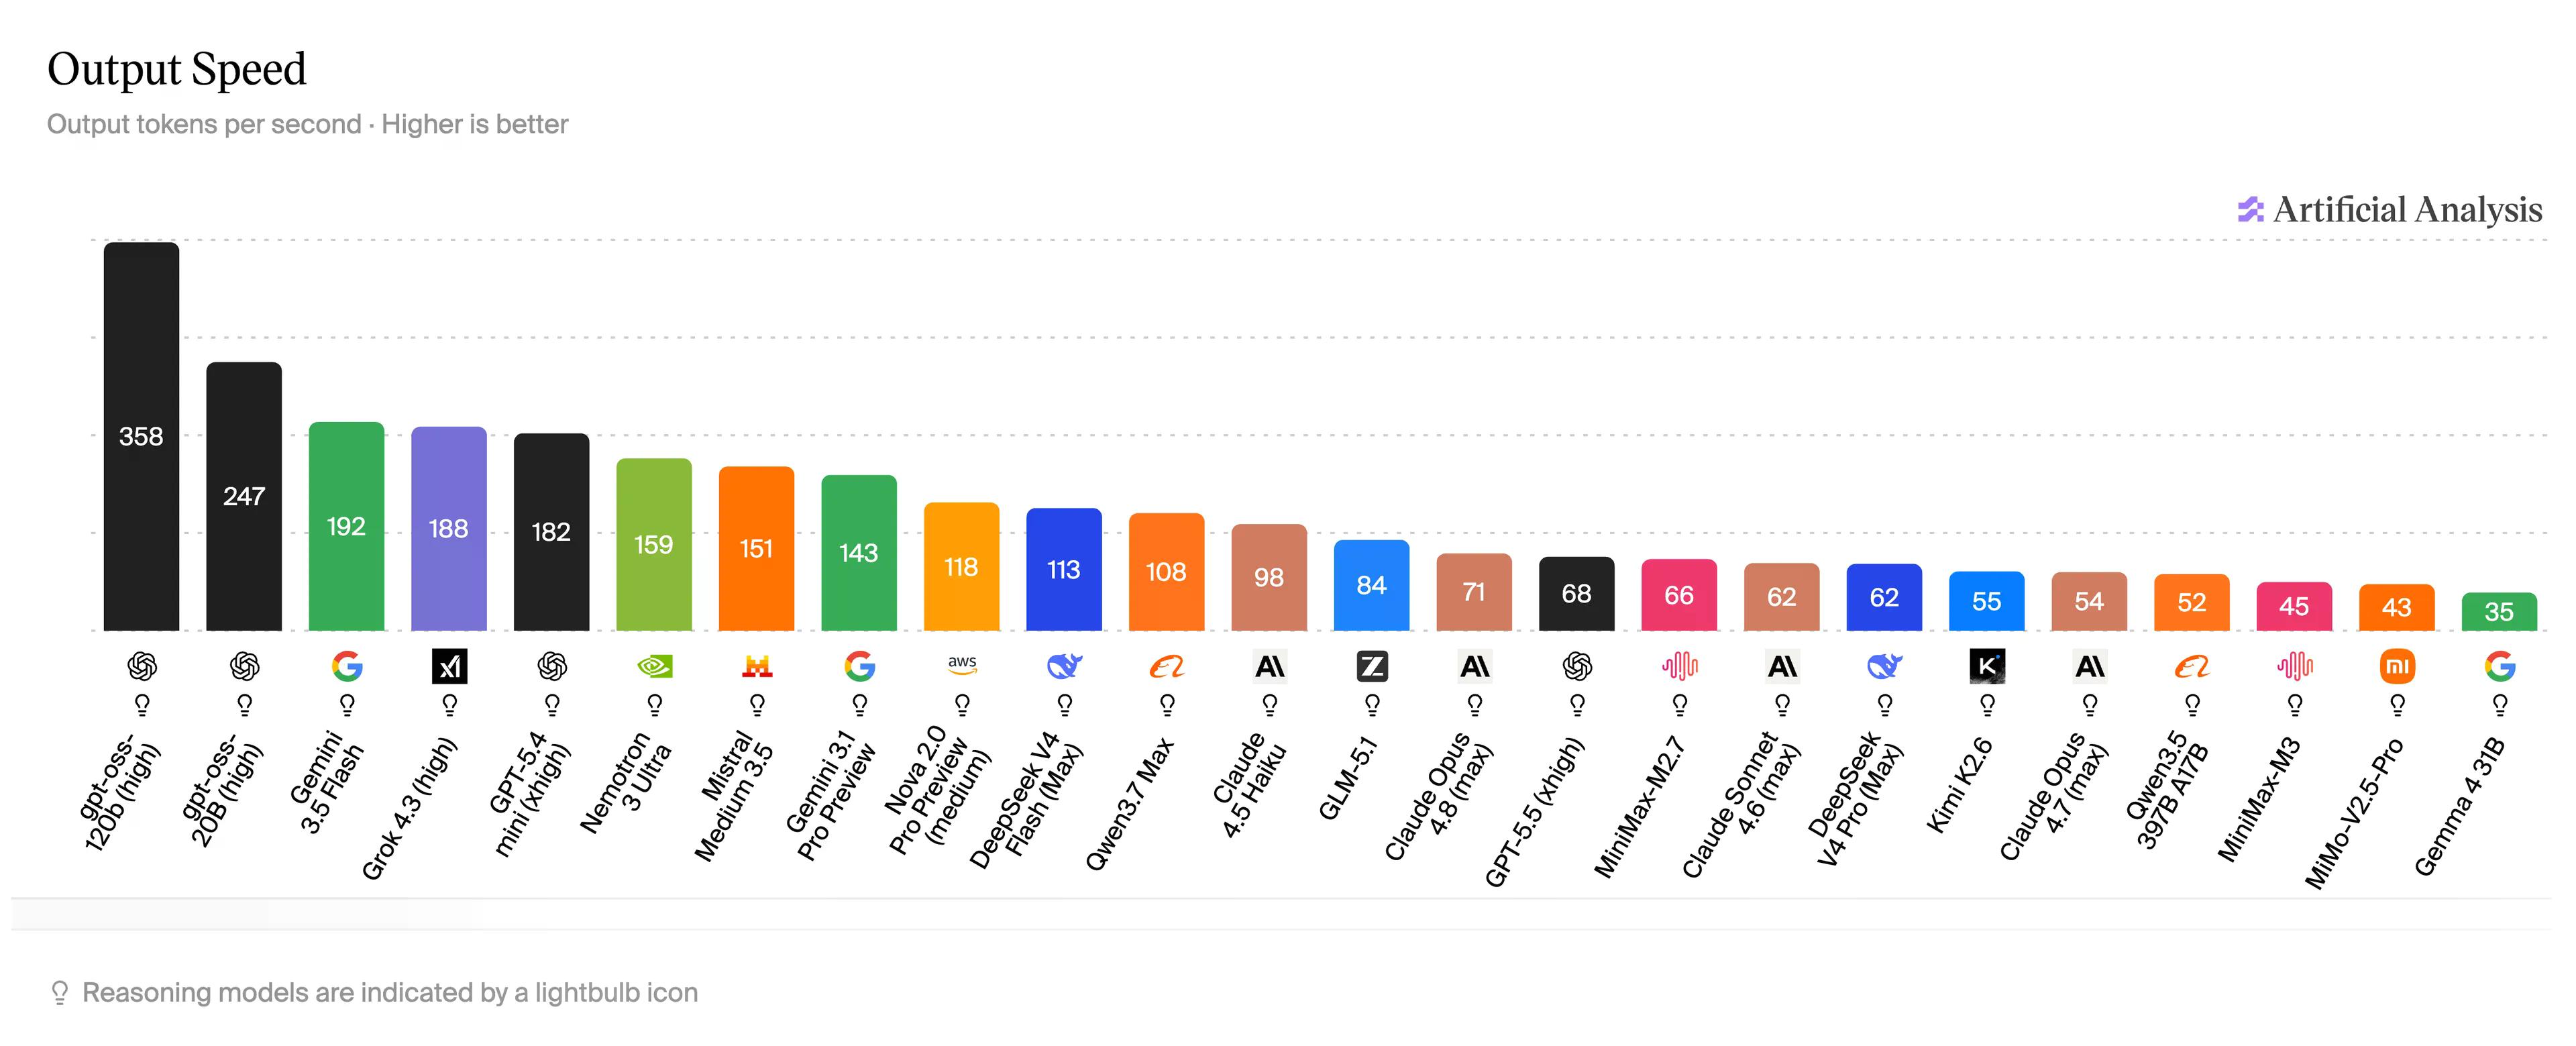
Para colocar esse número em termos humanos: de acordo com a Artificial Analysis, o GPT-5.5 — com o qual a maioria dos usuários do ChatGPT interage — opera a 68. O Claude Opus 4.6 atinge cerca de 71, com o modelo de gama inferior, Haiku, chegando a 98 tokens por segundo. O Gemini Flash alcança 192 tokens por segundo. O MiMo-V2.5-Pro-UltraSpeed faz 1.000, em um modelo que iguala o Opus em benchmarks de codificação.
Cerebras e Groq construíram negócios inteiros em torno desse problema. A Cerebras projetou um chip em escala de wafer do tamanho de um prato de jantar, empacotando 44GB de memória on-chip para eliminar o gargalo de largura de banda que desacelera a inferência de GPU. Atingiu 969 tokens por segundo no Llama 3.1 405B da Meta — impressionante, mas é um modelo de 405 bilhões de parâmetros, menos da metade do tamanho do MiMo-V2.5-Pro. A arquitetura de Unidade de Processamento de Linguagem personalizada da Groq atinge cerca de 300 a 750 tokens por segundo, dependendo do modelo.
Nenhum deles roda em hardware que você pode alugar na AWS hoje à noite.
A Xiaomi conseguiu isso em GPUs de commodity apenas com software — uma combinação de truques no nível do modelo e um motor de inferência especialmente construído chamado TileRT.
Duas técnicas impulsionam a velocidade. A primeira técnica é chamada de Quantização FP4: em vez de executar o modelo com precisão numérica total de 8 ou 16 bits, a Xiaomi reduz as camadas especialistas — que compõem a maior parte do trilhão de parâmetros — para 4 bits. A pegada de memória diminui, a pressão da largura de banda diminui, a velocidade aumenta. O problema geralmente é uma pequena degradação da qualidade. A solução da Xiaomi é cirúrgica: apenas as camadas especialistas são compactadas, todo o resto permanece em precisão total. Com essa abordagem, a perda de qualidade é descrita como próxima de zero.
A segunda é a decodificação especulativa DFlash. A decodificação especulativa normal faz com que um pequeno modelo de rascunho adivinhe os próximos tokens, e então o modelo maior os verifica em paralelo. O DFlash pula completamente a fase de rascunho sequencial — ele preenche um bloco inteiro de posições mascaradas em uma única passagem para frente. Em tarefas de codificação, o modelo grande aceita uma média de 6,3 de 8 tokens propostos por rodada de verificação. Ou seja, seis tokens confirmados em uma única etapa, em vez de um.
O TileRT amarra tudo isso. Ele mantém todo o pipeline de computação continuamente residente dentro da GPU — sem sobrecarga de lançamento por operador, sem lacunas de execução.
A Xiaomi chama essa abordagem de "codesign extremo modelo-sistema", e a frase é precisa: Nenhuma técnica isolada atinge 1.000 tokens por segundo, mas a sinergia entre todas as abordagens o faz.
MiMo-V2.5-Pro é um modelo de nível de fronteira. Cobrimos o lançamento do V2.5 Pro em abril — ele se iguala ao Claude Opus na maioria dos benchmarks de codificação e roda a aproximadamente $0,43 de entrada / $0,87 de saída por milhão de tokens. O Opus custa $5 de entrada / $25 de saída por milhão de tokens.
O UltraSpeed acelera exatamente esse modelo MiMo V2.5 Pro, não uma versão simplificada.
Inferência rápida o suficiente muda como você pode usar um modelo. Você pode executar dezenas de caminhos de raciocínio em paralelo, em vez de esperar por uma única resposta. Detecção de fraude, geração de sinais de trading, loops de agente em tempo real — todos estes têm restrições rígidas de latência que 60 tokens por segundo não conseguem atender. A 1.000 tokens por segundo, eles conseguem.
A Xiaomi está precificando a velocidade em 3 vezes a taxa padrão do MiMo-V2.5-Pro para aproximadamente 10 vezes a saída. O teste da API ocorre de 9 a 23 de junho, baseado em aplicação, com prioridade dada a desenvolvedores corporativos e profissionais. O checkpoint FP4-DFlash já está disponível em código aberto no Hugging Face para testes da comunidade.