

Fazer loginRegistrar-se
Depositar
Conectar
 Transferência


É o fim do anonimato na internet como o conhecemos, segundo uma multidão de usuários em pânico nas redes sociais que descobriram hoje um estudo relacionado à IA.
O artigo científico que voltou a circular hoje no X e no Reddit vem de um estudo de fevereiro, e o cerne das conclusões está aterrorizando os anons da internet em todo lugar: a IA consegue descobrir quem você realmente é a partir de uma conta anônima.
O artigo se chama "Large-scale online deanonymization with LLMs" e foi produzido por pesquisadores da ETH Zurich e do grupo de segurança em IA MATS, em colaboração com Nicholas Carlini, pesquisador da Anthropic, empresa por trás do Claude.
Os pesquisadores afirmam que grandes modelos de linguagem, os sistemas de IA por trás de Claude, ChatGPT e Gemini, conseguem ler as postagens anônimas de alguém e descobrir quem essa pessoa é na vida real. Não hackeando nada, apenas lendo, pesquisando e raciocinando — as mesmas coisas que esses chatbots já fazem em um milhão de tarefas banais todos os dias.
Pesquisadores criaram uma IA que expõe qualquer conta "anônima" do Reddit em menos de um minuto por US$ 2.
ETH Zurich e Anthropic publicaram um artigo assustador provando que o "anonimato prático" na internet está oficialmente morto.
Eles construíram um pipeline de IA totalmente autônomo que pega seu… pic.twitter.com/XMeXifhDf3
— Superman (@thesupermannx) 23 de setembro de 2026
“Nossos resultados mostram que a obscuridade prática que protegia usuários pseudônimos online não se sustenta mais e que os modelos de ameaça para a privacidade online precisam ser reconsiderados”, diz o artigo.
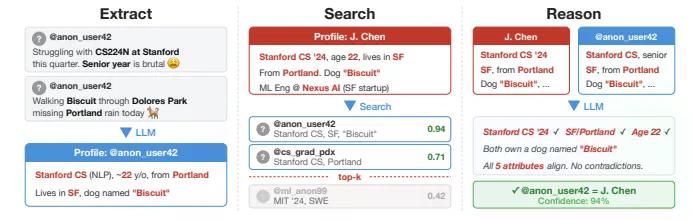
Os pesquisadores dividiram o ataque em quatro etapas, que chamam de Extract, Search, Reason e Calibrate.
“Extract” significa alimentar a IA com as postagens de alguém e fazê-la resumir a pessoa: onde ela pode morar, seu trabalho, seus hobbies, até algum traço peculiar, como grafia britânica ou o nome de um cachorro mencionado de passagem.
“Search” transforma esse resumo em um embedding, uma sequência de números que o computador pode usar para encontrar instantaneamente perfis semelhantes entre milhares de candidatos.
“Reason” é a etapa em que um modelo mais poderoso analisa os melhores resultados e raciocina sobre qual deles realmente se encaixa, cruzando detalhes da forma como um investigador humano faria, só que muito mais rápido.
“Calibrate” faz a IA avaliar o próprio grau de confiança, para que ela só arrisque um palpite quando estiver razoavelmente certa e permaneça em silêncio caso contrário.
Em um teste, a equipe reuniu 338 usuários do fórum Hacker News, em grande parte pseudônimo, que haviam vinculado seu perfil do LinkedIn na bio, removeu qualquer elemento identificador e então pediu a um agente de IA que descobrisse quem eles eram usando apenas busca na web. A IA nomeou corretamente 226 deles, ou 67%, e errou em cerca de uma em cada 10 suposições que de fato fez.
Em um teste separado com transcrições da própria pesquisa de entrevistas da Anthropic com 125 cientistas, a IA identificou corretamente pelo menos 9 pessoas apenas pela forma como descreviam seu trabalho.
O custo de fazer tudo isso é a verdadeira descoberta aqui. Executar uma dessas buscas custa entre US$ 1 e US$ 4 em taxas de assinatura de IA, segundo o artigo.
Também não exige violação de dados, hackeamento nem acesso interno. Usa as mesmas capacidades de busca na web e sumarização já incorporadas aos chatbots comuns. Os pesquisadores argumentam que é exatamente por isso que isso é difícil de bloquear: não existe um único botão “desanonimizar esta pessoa” para desativar, apenas uma cadeia de tarefas que, individualmente, parecem inofensivas.
Não é a primeira vez que um punhado de detalhes expõe alguém. Em 2008, pesquisadores quebraram o suposto anonimato do conjunto de dados de avaliações de filmes da Netflix ao cruzá-lo com reviews públicas no IMDb. A diferença agora é que a IA faz esse cruzamento em textos bagunçados e não estruturados — piadas, comentários, menções casuais — em vez de planilhas organizadas, e faz isso sozinha.
Os números mais assustadores do artigo vêm com uma ressalva importante. Para medir o sucesso, os pesquisadores precisavam de indivíduos cuja identidade real já conheciam, então escolheram contas que já haviam sido vinculadas ao LinkedIn, ou dividiram o histórico de postagens de uma mesma pessoa em duas metades e esconderam a conexão.
Isso é um cenário controlado de melhor caso, não uma prova de que qualquer conta pseudônima aleatória possa ser quebrada hoje.
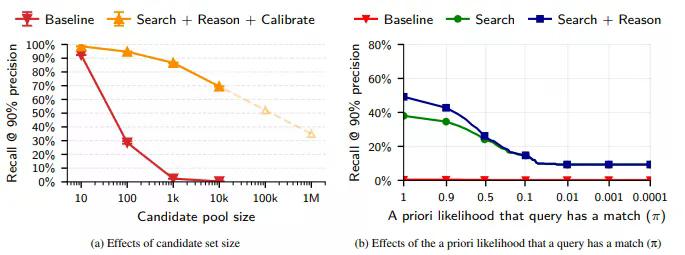
A escala também reduz o impacto dos números mais alarmantes do estudo. Quanto maior o palheiro de candidatos possíveis, mais difícil fica encontrar a agulha. Diante de um universo de 89.000 candidatos, o método de IA mais forte ainda encontrou apenas cerca de metade das correspondências corretas com 90% de precisão. Precisão significa a frequência com que os palpites estavam certos; recall significa quantas correspondências reais ele de fato encontrou.
Os pesquisadores também não publicaram suas ferramentas, prompts nem qualquer um dos nomes reais que descobriram, e o estudo passou por um comitê de revisão ética antes de ser divulgado. Eles não estão entregando a ninguém um kit de doxxing. Estão documentando uma capacidade que, segundo os autores, já existe nos modelos atuais de IA, com ou sem artigo.
Por que isso importa mesmo que você nunca tenha postado no Reddit
Usuários de cripto já conhecem esse medo de perto. Uma onda de doxxing e tentativas de sequestro após o vazamento de dados da Coinbase em 2025, entre muitos outros casos, mostrou com que rapidez uma identidade vazada se transforma em um endereço real na porta de alguém.
A desanonimização impulsionada por IA é a mesma ameaça sem a necessidade de um vazamento: ela funciona a partir do que você já publicou em público, sem exigir leak algum.
Isso também surge poucos meses depois de a Anthropic revelar que hackers apoiados por Estados usaram o Claude para conduzir por conta própria a maior parte de uma campanha de ciberespionagem, um lembrete de que a pesquisa sobre uso indevido de IA continua avançando mais rápido do que as proteções criadas para contê-la.
Para qualquer pessoa que poste sob pseudônimo por causa de ativismo, abuso, sexualidade, status migratório ou um emprego que desaprove opiniões públicas, isso significa que cidades natais, empregadores e até o nome de um animal de estimação, espalhados por anos de comentários antigos, se somam para formar uma impressão digital. Isso sempre foi possível — a IA apenas torna o processo mais rápido e mais barato.
Mas, se esse tipo de doxxing é uma preocupação, a solução não é pânico, e sim hábito: menos detalhes específicos e identificáveis vinculados a qualquer pseudônimo, e, para qualquer coisa realmente sensível, ferramentas feitas para não reter seus dados de forma alguma.







