Se connecterS'inscrire
Déposer
Connecter
 Transférer


C’est la fin de l’anonymat sur Internet tel qu’on le connaît, à en croire les nombreux utilisateurs paniqués des réseaux sociaux qui viennent de découvrir aujourd’hui une étude liée à l’IA.
L’article de recherche qui recommence à circuler aujourd’hui sur X et Reddit provient d’une étude de février, et l’essentiel de ses conclusions terrorise les anonymes du web partout dans le monde : l’IA peut découvrir qui vous êtes réellement à partir d’un compte anonyme.
L’article s’intitule « Large-scale online deanonymization with LLMs » et est signé par des chercheurs de l’ETH Zurich et du groupe de sécurité de l’IA MATS, aux côtés de Nicholas Carlini, chercheur chez Anthropic, l’entreprise à l’origine de Claude.
Les chercheurs affirment que les grands modèles de langage, les systèmes d’IA derrière Claude, ChatGPT et Gemini, peuvent lire les publications anonymes d’une personne et déterminer qui elle est dans la vie réelle. Pas en piratant quoi que ce soit, mais simplement en lisant, en recherchant et en raisonnant, soit exactement ce que ces chatbots font déjà chaque jour pour un million de tâches banales.
Des chercheurs ont créé une IA capable de doxxer n’importe quel compte Reddit « anonyme » en moins d’une minute pour 2 dollars.
L’ETH Zurich et Anthropic ont publié un article terrifiant prouvant que « l’anonymat pratique » sur Internet est officiellement mort.
Ils ont conçu un pipeline d’IA entièrement autonome qui prend votre… pic.twitter.com/XMeXifhDf3
— Superman (@thesupermannx) 23 septembre 2026
« Nos résultats montrent que l’obscurité pratique qui protégeait les utilisateurs pseudonymes en ligne ne tient plus, et que les modèles de menace en matière de vie privée sur Internet doivent être reconsidérés », peut-on lire dans l’étude.
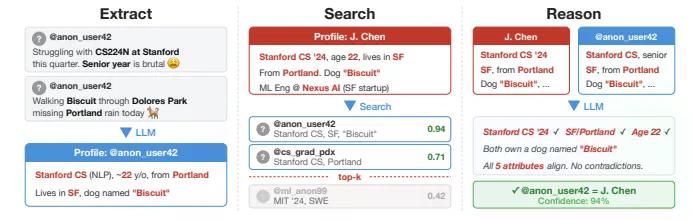
Les chercheurs ont découpé l’attaque en quatre étapes qu’ils appellent Extract, Search, Reason et Calibrate.
« Extract » consiste à fournir à une IA les publications d’une personne afin qu’elle en produise un résumé : où elle pourrait vivre, son métier, ses loisirs, voire un détail distinctif comme l’orthographe britannique ou le nom d’un chien mentionné au passage.
« Search » transforme ce résumé en embedding, une suite de nombres qu’un ordinateur peut utiliser pour retrouver instantanément des profils similaires parmi des milliers de candidats.
« Reason » est l’étape où un modèle plus puissant examine les quelques meilleures correspondances et détermine laquelle colle réellement, en recoupant les détails comme le ferait un enquêteur humain, mais beaucoup plus vite.
« Calibrate » amène l’IA à évaluer son propre niveau de confiance, afin qu’elle ne fasse une supposition que lorsqu’elle est assez sûre d’elle, et qu’elle se taise dans le cas contraire.
Dans un test, l’équipe a rassemblé 338 utilisateurs de Hacker News, un forum largement pseudonyme, qui avaient lié leur profil LinkedIn dans leur bio, a retiré tout élément identifiable, puis a demandé à un agent IA de découvrir qui ils étaient en n’utilisant que la recherche web. Il en a correctement identifié 226, soit 67 %, et s’est trompé sur environ une supposition sur dix parmi celles qu’il a effectivement formulées.
Dans un test distinct portant sur les transcriptions des propres recherches d’Anthropic basées sur des entretiens avec 125 scientifiques, l’IA a correctement identifié au moins 9 personnes uniquement à partir de la façon dont elles décrivaient leur travail.
Le coût réel de l’opération constitue ici la principale découverte. Selon l’étude, lancer l’une de ces recherches coûte entre 1 et 4 dollars en frais d’abonnement à des services d’IA.
Cela ne nécessite pas non plus de fuite de données, de piratage ou d’accès interne. Le procédé exploite les mêmes capacités de recherche web et de synthèse déjà intégrées aux chatbots ordinaires. Les chercheurs soutiennent que c’est précisément pour cela qu’il est difficile à bloquer : il n’existe pas d’interrupteur unique « désanonymiser cette personne » à désactiver, seulement une chaîne de tâches qui, prises individuellement, semblent inoffensives.
Ce n’est pas la première fois qu’une poignée de détails suffit à démasquer quelqu’un. Dès 2008, des chercheurs avaient percé le jeu de données supposément anonyme des notes de films de Netflix en le recoupant avec des critiques publiques sur IMDb. La différence aujourd’hui, c’est que l’IA effectue ce recoupement sur du texte désordonné et non structuré — blagues, commentaires, remarques lancées au détour d’une phrase — plutôt que sur des tableaux bien propres, et qu’elle le fait de manière autonome.
Les chiffres les plus alarmants de l’étude s’accompagnent d’une réserve importante. Pour mesurer le succès, les chercheurs avaient besoin de sujets dont ils connaissaient déjà l’identité réelle. Ils ont donc choisi des comptes déjà liés à LinkedIn, ou bien ont scindé l’historique de publications d’une même personne en deux parties en masquant le lien entre elles.
Il s’agit d’un scénario contrôlé dans les meilleures conditions possibles, et non d’une preuve qu’un compte pseudonyme aléatoire peut être craqué aujourd’hui.
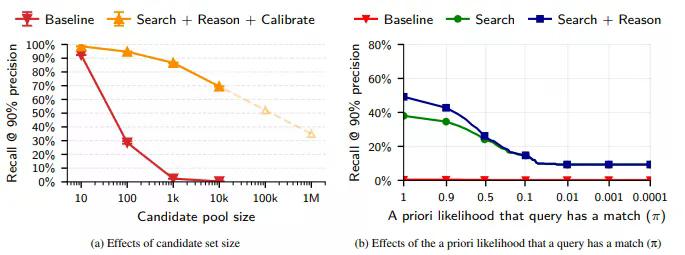
L’échelle joue aussi contre les chiffres les plus inquiétants de l’étude. Plus la botte de foin de candidats potentiels est grande, plus l’aiguille est difficile à trouver. Face à un vivier de 89 000 candidats, la méthode d’IA la plus performante n’a tout de même retrouvé qu’environ la moitié des correspondances correctes avec une précision de 90 %. La précision indique la fréquence à laquelle ses suppositions étaient justes, tandis que le rappel mesure combien de vraies correspondances elle a effectivement détectées.
Les chercheurs n’ont pas non plus publié leurs outils, leurs prompts ni aucun des vrais noms qu’ils ont découverts, et l’étude a été examinée par un comité d’éthique avant sa publication. Ils ne mettent pas à disposition un kit de doxxing. Ils documentent une capacité qui, selon les auteurs, existe déjà dans les modèles d’IA actuels, avec ou sans publication de l’article.
Pourquoi cela compte, même si vous n’avez jamais posté sur Reddit
Les utilisateurs crypto connaissent déjà très bien cette peur. Une vague de doxxings et de tentatives d’enlèvement à la suite de la fuite de données de Coinbase en 2025, entre autres, a montré à quelle vitesse une identité divulguée peut se transformer en adresse réelle au pas de la porte de quelqu’un.
La désanonymisation pilotée par l’IA représente la même menace, mais sans la fuite de données : elle s’appuie sur ce que vous avez déjà publié en public, sans qu’aucune fuite ne soit nécessaire.
L’étude intervient aussi quelques mois après qu’Anthropic a révélé que des hackers soutenus par des États avaient utilisé Claude pour mener seuls l’essentiel d’une campagne de cyberespionnage, rappelant que la recherche sur les usages malveillants de l’IA devance sans cesse les garde-fous censés la contenir.
Pour toute personne qui publie sous pseudonyme en raison de son activisme, de violences subies, de son orientation sexuelle, de son statut migratoire ou d’un emploi peu tolérant vis-à-vis des opinions publiques, cela signifie que les villes d’origine, les employeurs, et même le nom d’un animal de compagnie, éparpillés sur des années de vieux commentaires, finissent par former une empreinte. Cela a toujours été possible — l’IA ne fait que rendre l’opération plus rapide et moins coûteuse.
Mais si ce type de doxxing vous inquiète, la solution n’est pas la panique, mais l’habitude : moins de détails précis et identifiants associés à un même pseudonyme et, pour tout ce qui est réellement sensible, des outils conçus pour ne conserver aucune de vos données.