

Більшість людей знають Xiaomi як китайський бренд телефонів. Той, що виробляє дешеві електросамокати та очищувачі повітря. Не зовсім та компанія, від якої очікуєш побити серйозний рекорд швидкості інференції ШІ у понеділок вранці.
І все ж. Xiaomi щойно випустила MiMo-V2.5-Pro-UltraSpeed, режим обслуговування для свого флагмана з трильйоном параметрів, який досягає понад 1000 токенів за секунду — з піком близько 1200 на демонстраціях.
Параметри — це внутрішні числові ваги, які визначають, як мислить модель; чим більше їх у вас, тим складніші шаблони вона може розпізнавати. Токени — це фрагменти тексту, які модель читає та пише, в середньому близько трьох чвертей слова кожен.
Xiaomi зробила це на одному комерційному вузлі з 8 GPU. Стандартне обладнання, без кастомних чипів. Це змінює розрахунки щодо того, хто насправді може розгорнути таку швидкість у виробництві.
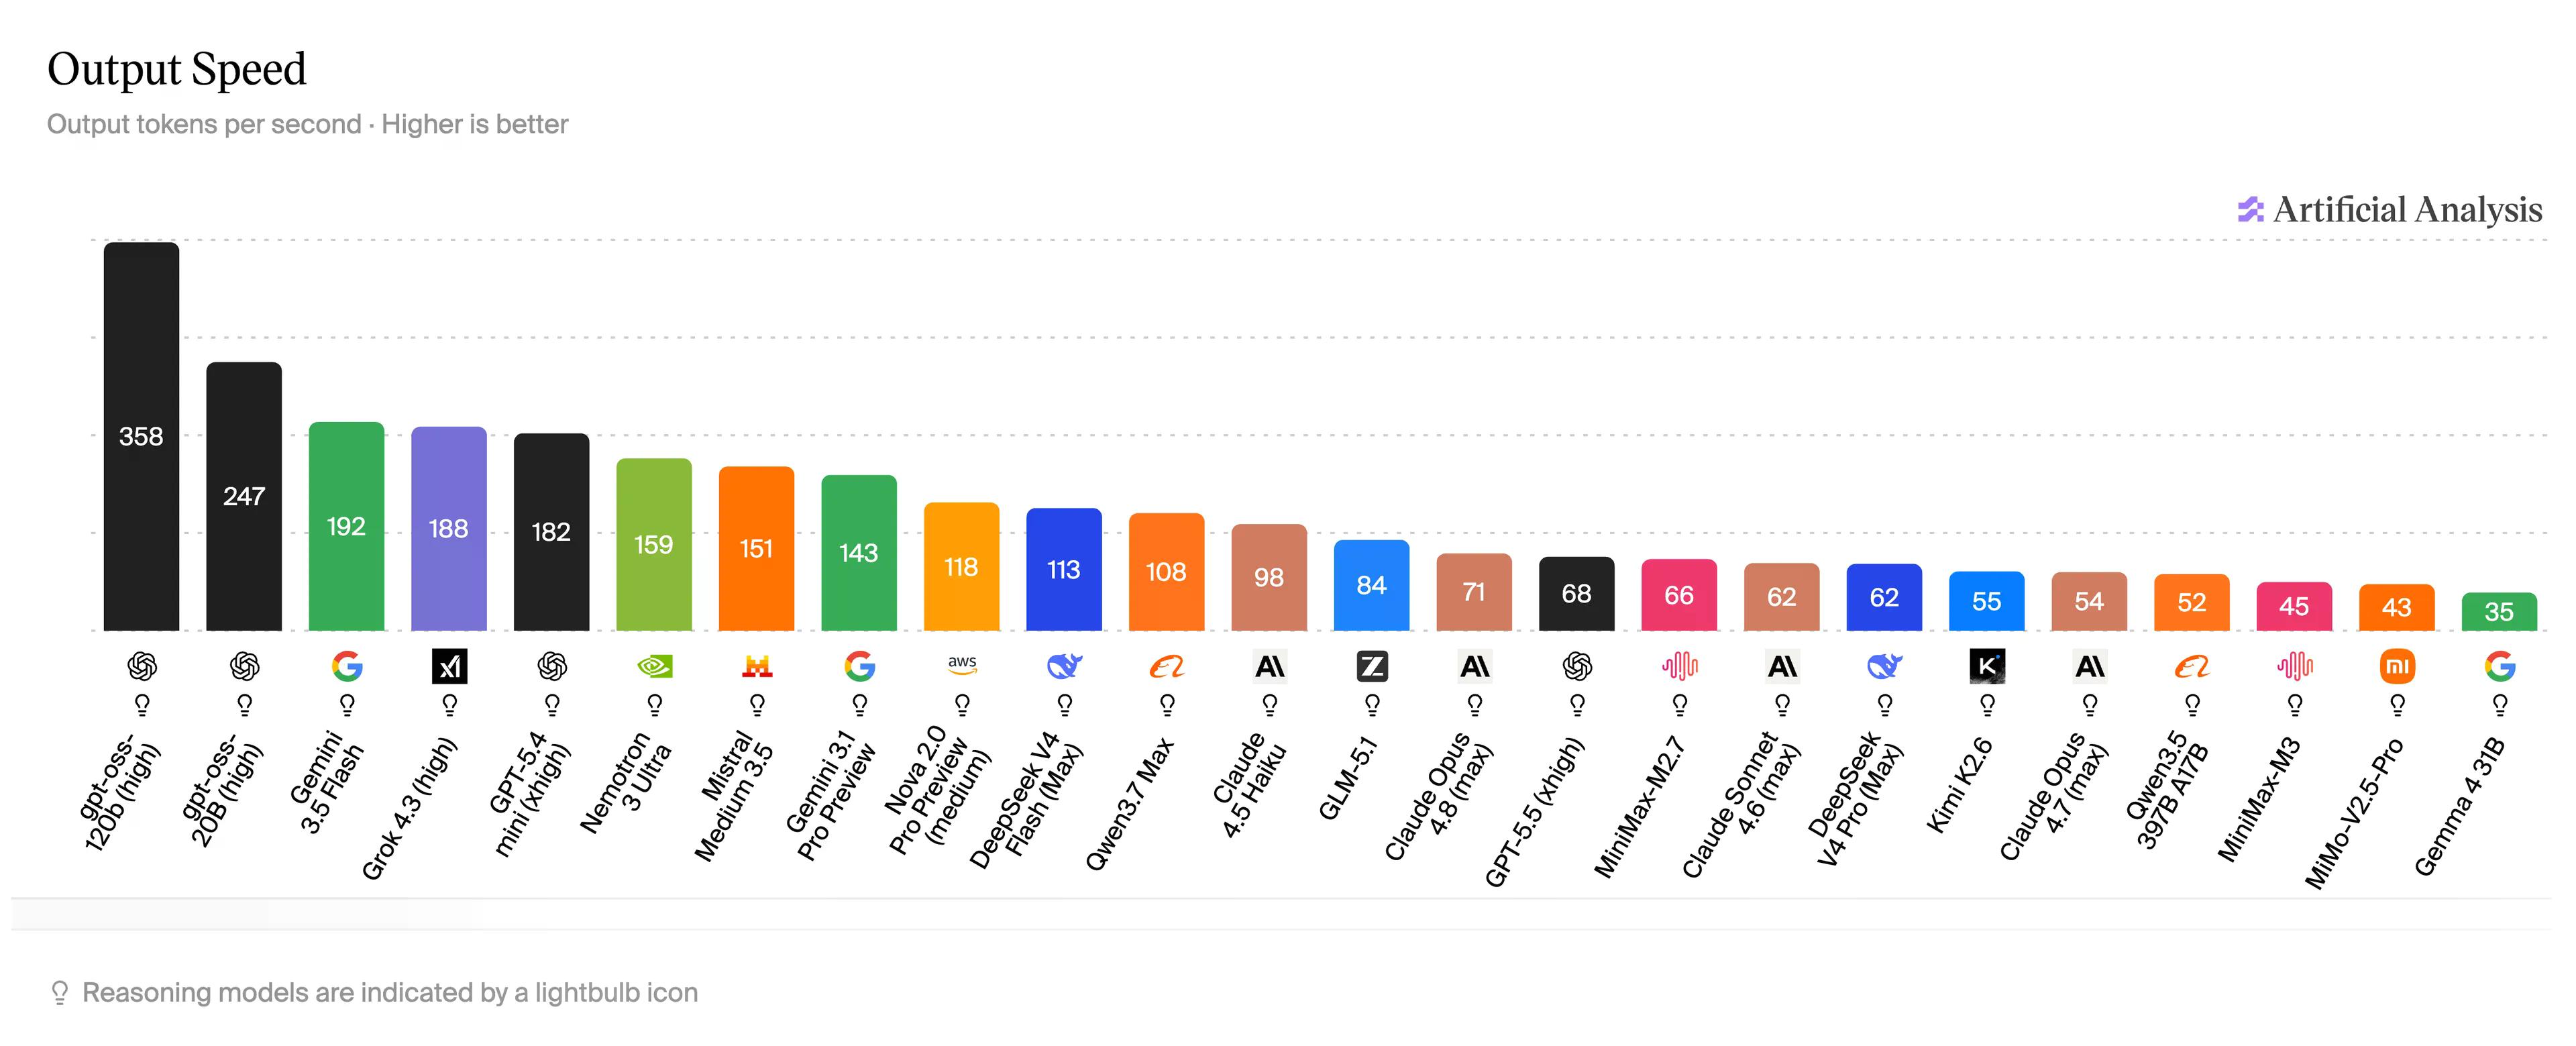
Щоб зрозуміти це число по-людськи: за даними Artificial Analysis, GPT-5.5 — те, з чим більшість користувачів ChatGPT насправді спілкуються — становить 68 токенів за секунду. Claude Opus 4.6 досягає близько 71 токена за секунду, а модель нижнього рівня, Haiku, — 98 токенів за секунду. Gemini Flash досягає 192 токенів за секунду. MiMo-V2.5-Pro-UltraSpeed робить 1000 на моделі, яка відповідає Opus за бенчмарками кодування.
Cerebras і Groq побудували цілі бізнеси навколо цієї проблеми. Cerebras розробила чип розміром з тарілку, що містить 44 ГБ пам'яті на чипі для усунення вузького місця пропускної здатності, яке уповільнює інференцію GPU. Він досяг 969 токенів за секунду на моделі Llama 3.1 405B від Meta — вражаюче, але це модель з 405 мільярдами параметрів, що менше половини розміру MiMo-V2.5-Pro. Архітектура спеціалізованого процесора для обробки мов (LPU) Groq досягає близько 300–750 токенів за секунду залежно від моделі.
Жоден з них не працює на обладнанні, яке можна орендувати в AWS сьогодні ввечері.
Xiaomi зробила це на комерційних GPU лише за допомогою програмного забезпечення — комбінації трюків на рівні моделі та спеціально розробленого рушія інференції під назвою TileRT.
Швидкість забезпечують дві техніки. Перша техніка називається квантуванням FP4: замість запуску моделі з повною 8-бітною або 16-бітною числовою точністю, Xiaomi зменшує експертні шари — які становлять більшу частину з 1 трильйона параметрів — до 4-бітної. Зменшується обсяг пам'яті, зменшується навантаження на пропускну здатність, швидкість збільшується. Зазвичай це призводить до невеликого погіршення якості. Виправлення Xiaomi є хірургічним: лише експертні шари стискаються, все інше залишається на повній точності. За такого підходу втрата якості описується як майже нульова.
Друга — це спекулятивне декодування DFlash. Звичайне спекулятивне декодування передбачає, що невелика чорнова модель вгадує наступні кілька токенів, а потім велика модель перевіряє їх паралельно. DFlash повністю пропускає послідовне чернеткове створення — воно заповнює цілий блок замаскованих позицій за один прямий прохід. У завданнях кодування велика модель приймає в середньому 6,3 з 8 запропонованих токенів за раунд перевірки. Це шість токенів, підтверджених за один крок замість одного.
TileRT поєднує все це. Він утримує весь обчислювальний конвеєр безперервно всередині GPU — без накладних витрат на запуск кожної операції, без прогалин у виконанні.
Xiaomi називає цей підхід "екстремальним співпроектуванням моделі та системи", і ця фраза точна: жодна з технік окремо не досягає 1000 токенів за секунду, але синергія всіх підходів робить це.
MiMo-V2.5-Pro — це модель передового рівня. Ми висвітлювали запуск V2.5 Pro у квітні — вона відповідає Claude Opus за більшістю бенчмарків кодування та працює приблизно за $0,43 за вхід / $0,87 за вихід на мільйон токенів. Opus коштує $5 за вхід / $25 за вихід на мільйон токенів.
UltraSpeed прискорює саме цю модель MiMo V2.5 Pro, а не спрощену версію.
Достатньо швидка інференція змінює спосіб використання моделі. Ви можете запускати десятки шляхів міркувань паралельно замість того, щоб чекати на одну відповідь. Виявлення шахрайства, генерація торгових сигналів, агентні цикли в реальному часі — всі ці задачі мають жорсткі обмеження затримки, які 60 токенів за секунду не можуть задовольнити. При 1000 токенів за секунду — можуть.
Xiaomi оцінює швидкість у 3 рази вище за стандартний тариф MiMo-V2.5-Pro за приблизно 10-кратний обсяг виводу. Пробний період API триватиме з 9 по 23 червня, на основі заявок, з пріоритетом для корпоративних та професійних розробників. Контрольна точка FP4-DFlash вже має відкритий вихідний код на Hugging Face для тестування спільнотою.







