

Компанія xAI Ілона Маска в понеділок після обіду випустила Grok 4.7 — свою найкращу на сьогодні модель, назвавши її «помітним покращенням порівняно з Grok 4.6 за тієї ж ціни та швидкості».
Реліз відбувся після кількох очевидних затримок. Із кінця липня Маск щонайменше п’ять разів відсував дедлайн: спершу «через чотири тижні», потім «за кілька тижнів», далі «через 3–4 тижні», 1 вересня — «через 10 днів», а 11 вересня — «потрібно ще кілька днів, щоб довести до готовності».
У xAI заявляють, що модель довше опрацьовує складні завдання й частіше повторно перевіряє власні відповіді, ніж Grok 4.6, а також має, за словами компанії, найсильніші на сьогодні захисні механізми безпеки.
Пізніше Маск дописав у X, назвавши Grok 4.7 «сильним поєднанням інтелекту, швидкості та низької вартості». Цього разу жодного списку очікування немає — модель уже доступна в застосунку Grok, Cursor, Grok Build і xAI API.
Grok 4.7 is here.
It's a notable improvement over Grok 4.6 at the same price and speed. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) September 21, 2026
Grok 4.7 має 2,1 трлн параметрів — на 40% більше, ніж 1,5 трлн у Grok 4.6, яка сама була вдосконаленою версією Grok 4.5. Вартість становить $2 за мільйон вхідних токенів і $6 за мільйон вихідних токенів. Параметри — це внутрішні налаштування, які модель коригує під час навчання; загалом їх більша кількість означає вищу здатність засвоювати патерни, тоді як токени є базовими одиницями інформації, які ШІ-модель може сприймати або генерувати.
xAI також додала до навчання додаткові дані від SpaceX, ракетної компанії Маска: телеметрію супутників Starlink, виробничі записи та журнали інженерних збоїв. Ідея полягає в тому, що така модель краще міркує про «залізо» та фізичні системи, ніж будь-яка система, натренована виключно на інтернет-текстах.
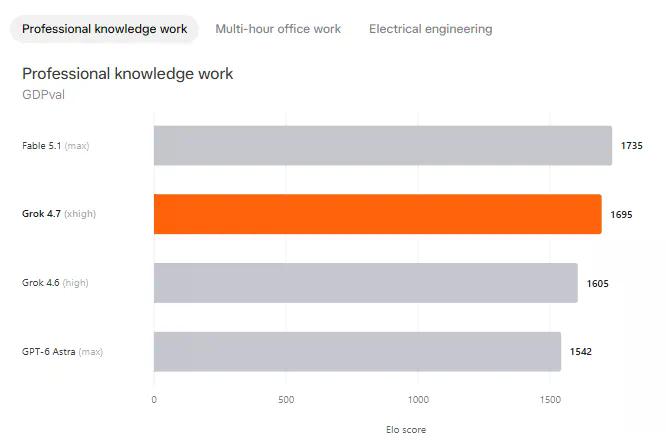
Втім, результати бенчмарків розповідають знайому історію. GDPval вимірює, як модель справляється з реальною, економічно цінною інтелектуальною роботою — юридичними меморандумами, електронними таблицями, презентаціями — використовуючи завдання, перевірені практикуючими фахівцями у відповідних галузях, і оцінює її за рейтингом Elo — тією ж системою очних рейтингів, що застосовується в шахах.
Grok 4.7 набрала 1695 у GDPval. Claude Fable 5.1 очолила рейтинг із показником 1735.
AA-Briefcase, створений Artificial Analysis, тестує багатогодинну офісну роботу, де дослідження, аналіз і підготовка документів поєднані в одне довге завдання; оцінювання також ведеться за шкалою Elo. Grok 4.7 показала 1657 проти 1678 у Fable 5.1. Той самий результат, інший тест.
CursorBench 4.0, бенчмарк Cursor для реальних завдань із програмування всередині його редактора, співставляє точність із вартістю та кількістю токенів, які витрачаються на кожне завдання. Grok 4.7 розташувалася посередині: дорожча за завдання, ніж наступник GPT-5.6 Sol — GPT-6 Astra — і Claude Sonnet 5, але все одно поступається Fable 5.1, яка перемагає в кожній ціновій точці на графіку.
Для xAI це не нова тенденція. Grok 4.5 вийшла в липні з найбільшим у галузі тренувальним кластером і посіла третє місце, поступившись моделям Claude та OpenAI. До неї Grok 4.20 обміняла надійність на швидкість і «характер». Grok 4.6 також відставала від передової групи за автономністю в програмуванні.
Усе це не робить Grok 4.7 поганим продуктом для мільйонів людей, які взаємодіють із нею через X, окремий застосунок або панель приладів Tesla. Це означає, що модель, яка з найбільшою ймовірністю відповідатиме на ваші запитання або працюватиме як голосовий асистент у вашому авто, базується на системі, яку навіть бенчмарки її розробника ставлять на щабель нижче вершини.
Саме тому для більшості людей цінник важливіший за місце в таблиці лідерів. xAI послідовно демпінгувала відносно Anthropic і OpenAI за вартістю токена, навіть відстаючи від них за «сирою» потужністю, роблячи ставку на те, що «достатньо добре, дешево й усюди» переможе «найкраще, але дорожче» в більшості повсякденних сценаріїв використання.
За кілька днів до запуску Маск уже знизив очікування, написавши, що Grok 4.7 має бути «приблизно на рівні» Claude Opus 5.0 від Anthropic, а не новішої Opus 5.1, і що мультимодальну продуктивність ще потрібно допрацьовувати.
У тому ж дописі він окреслив наступні три моделі: Grok 4.8 як суттєвий крок уперед, Grok 4.9 — у «класі Astra/Fable», а Grok 5 — як потенційного лідера переднього краю. Дат релізу цих оновлень поки немає. «Побачимо», — написав він.






