

Моделі ШІ споживають багато пам'яті. Модель штучного інтелекту з 27 мільярдами параметрів, що вважається середньою за галузевими стандартами, потребує приблизно 54 ГБ пам'яті для роботи з половинною точністю. Більшість ноутбуків не можуть цього забезпечити. Деякі настільні ПК також не можуть.
Раніше цього тижня PrismML випустила модель розміром 3,9 ГБ — достатньо малу, щоб поміститися на iPhone.
Параметри — це кількість регуляторів і налаштувань, які може обробляти модель. Чим більше параметрів, тим щільніша і більш функціональна модель.
Bonsai 27B — це перша модель класу 27B, яка подолала обмеження пам'яті споживчого смартфона, працюючи зі швидкістю 11 токенів на секунду на iPhone 17 Pro Max. (Токени — це базова одиниця інформації, яку моделі ШІ можуть обробляти та генерувати.) Трійковий варіант, об'ємом 5,9 ГБ, досягає приблизно 26 токенів на секунду на ноутбуці M5 Pro. Обидва доступні безкоштовно за ліцензією Apache 2.0.
Метод стиснення, розроблений на основі інтелектуальної власності Caltech, зменшує кожну вагу моделі з 16 біт точності з плаваючою комою до одного знака — +1 або -1 у бінарній збірці, одного з трьох значень у трійковій. Кожна група з 128 ваг має спільний 16-бітний коефіцієнт масштабування, що дозволяє бінарному варіанту мати 1,125 біт на вагу: у 14 разів менше, ніж оригінал з повною точністю. Трійкова модель додає нульовий стан для трохи більшої виразності та зупиняється на 1,71 біт.
Простіше кажучи, це означає, що трійкова модель ШІ використовує лише три налаштування для кожного внутрішнього значення — від'ємне, нульове або додатне — тоді як стандартний ШІ може вибирати з близько 65 000 налаштувань.
PrismML зробила це, не втрачаючи значної частини якості вихідних даних.
Чим це відрізняється від звичайних "низькобітних" моделей, так це тим, що ніщо не отримує лазівки для вищої точності: вбудовування, увага та повна головка мовної моделі стиснуті від початку до кінця. Більшість квантованих збірок зберігають певні чутливі шари з повною точністю, що в кінцевому підсумку збільшує їхній розмір як компроміс для кращої якості. Bonsai не грає в такі ігри.
Це другий великий реліз у сімействі. У березні PrismML випустила Bonsai 8B, модель об'ємом 1,15 ГБ, яка довела, що 1-бітна архітектура може вижити з 8 мільярдами параметрів без збою міркувань. Стрибок до 27 мільярдів змінює ставки — саме в цьому масштабі послідовно з'являються стійкі розмірковування за ланцюжком думок, надійне використання інструментів та багатоетапна агентна поведінка — те, з чим менші моделі все ще борються.
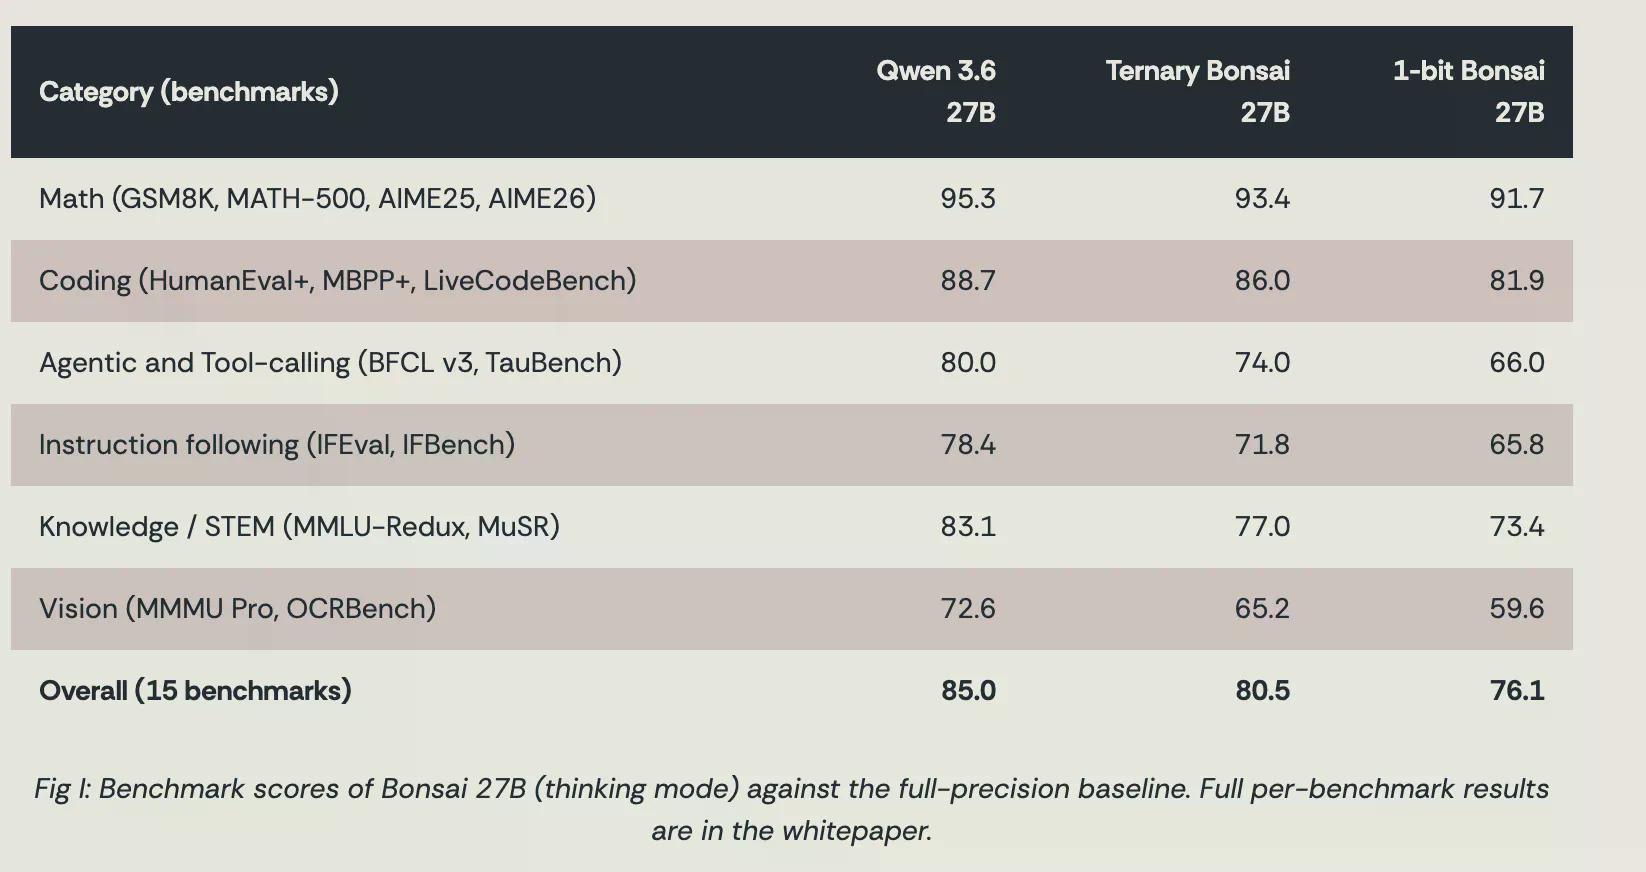
За результатами 15 бенчмарків, оцінених у режимі мислення на графічних процесорах NVIDIA H100 — що охоплюють знання, математику, кодування та використання інструментів — Ternary Bonsai 27B в середньому набирає 80,49, або 94,6% від моделі з повною точністю. 1-бітний варіант досягає 76,11.
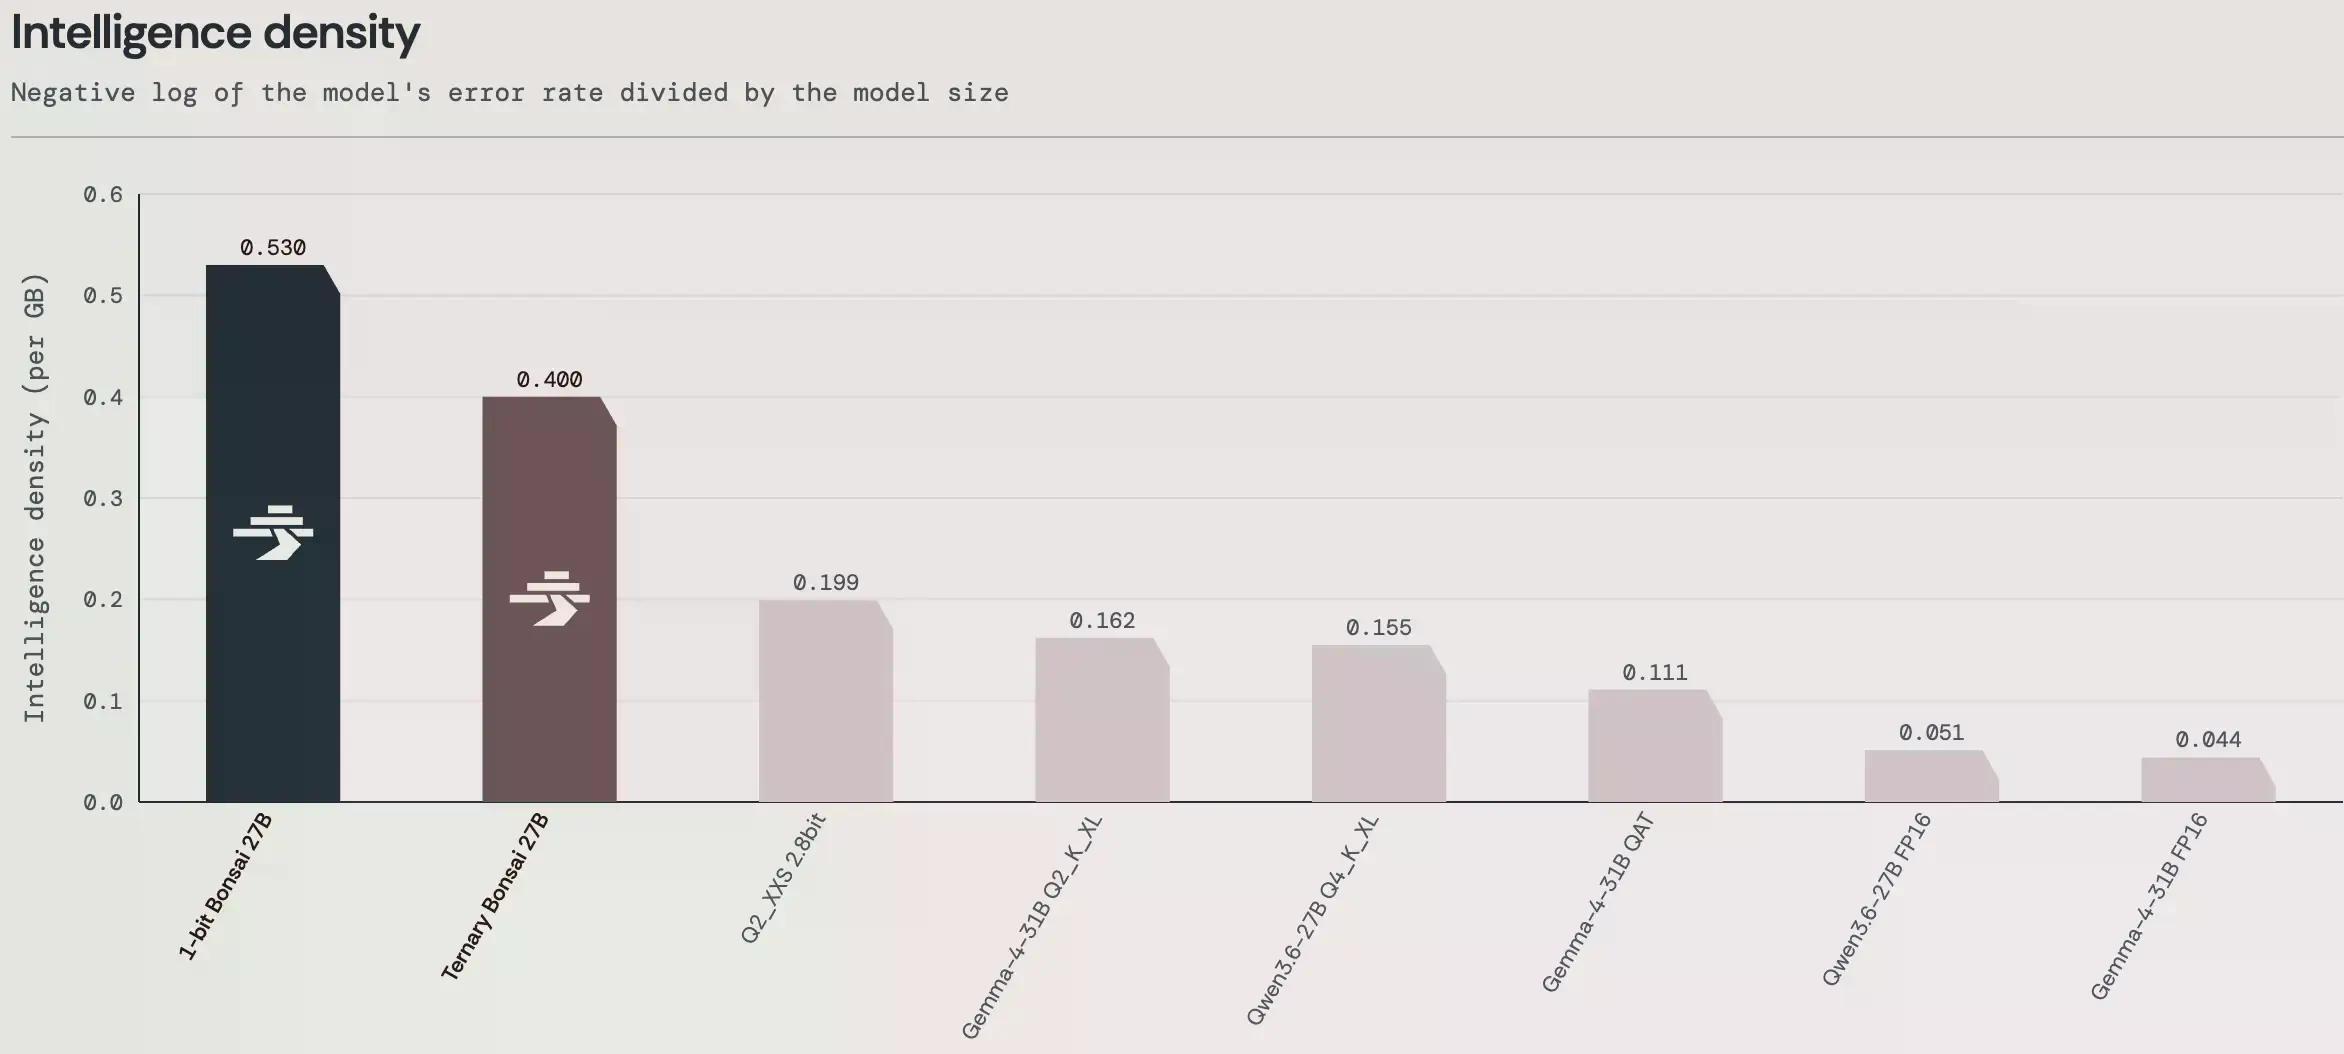
Загалом, за бенчмарками, моделі працюють набагато краще, ніж Gemma 4 або Qwen 3.6, з точки зору потенціалу, який вони пропонують для свого розміру.
Моделі досить хороші для того, що вони пропонують, і враховуючи, як мало ресурсів вони потребують, вони виводять невелике обладнання (смартфони та бюджетні ПК) на новий рівень можливостей. AIME25 та AIME26, змодельовані на основі Американського запрошувального математичного іспиту, показують 93,7% для Ternary Bonsai 27B проти 95,3% для значно більшого Qwen 3.6B. Bonsai набирає 86 балів у кодуванні проти 88 для Qwen 3.6 та 77% із загальних знань проти 83 для Qwen 3.6.
Модель також використовує гібридну архітектуру уваги, де приблизно 75% шарів є лінійними, а не повною квадратичною увагою. Ця архітектура дозволяє практично реалізувати вікно контексту в 262K токенів на пристрої — що стандартний стек уваги зробив би надмірно дорогим на телефонному обладнанні.
Ми самі запустили Bonsai 27B. Кодування потребує ітерацій: одноразові запити не конкуруватимуть з передовими хмарними моделями. Те, що вона працює локально та є безкоштовною, робить це несуттєвим. Для нашої гри Zombie Type — браузерної гри-жахів про набір тексту від першої особи — два раунди кодування в стилі дозволили отримати чисте виявлення зіткнень, правильну логіку підрахунку очок та графіку, яка добре трималася. Модель рано розуміє структуру; другий прохід уточнює, а не перебудовує.
Досить цікаво, що деякі моделі (наприклад, скелети) виглядали більш складними, ніж ті, що були з GPT 5.6 Sol. Це не означає, що вона краща за будь-якими показниками, просто в цьому завданні вона створила милого скелета, тоді як король ШІ зробив бідніший стилістичний вибір.
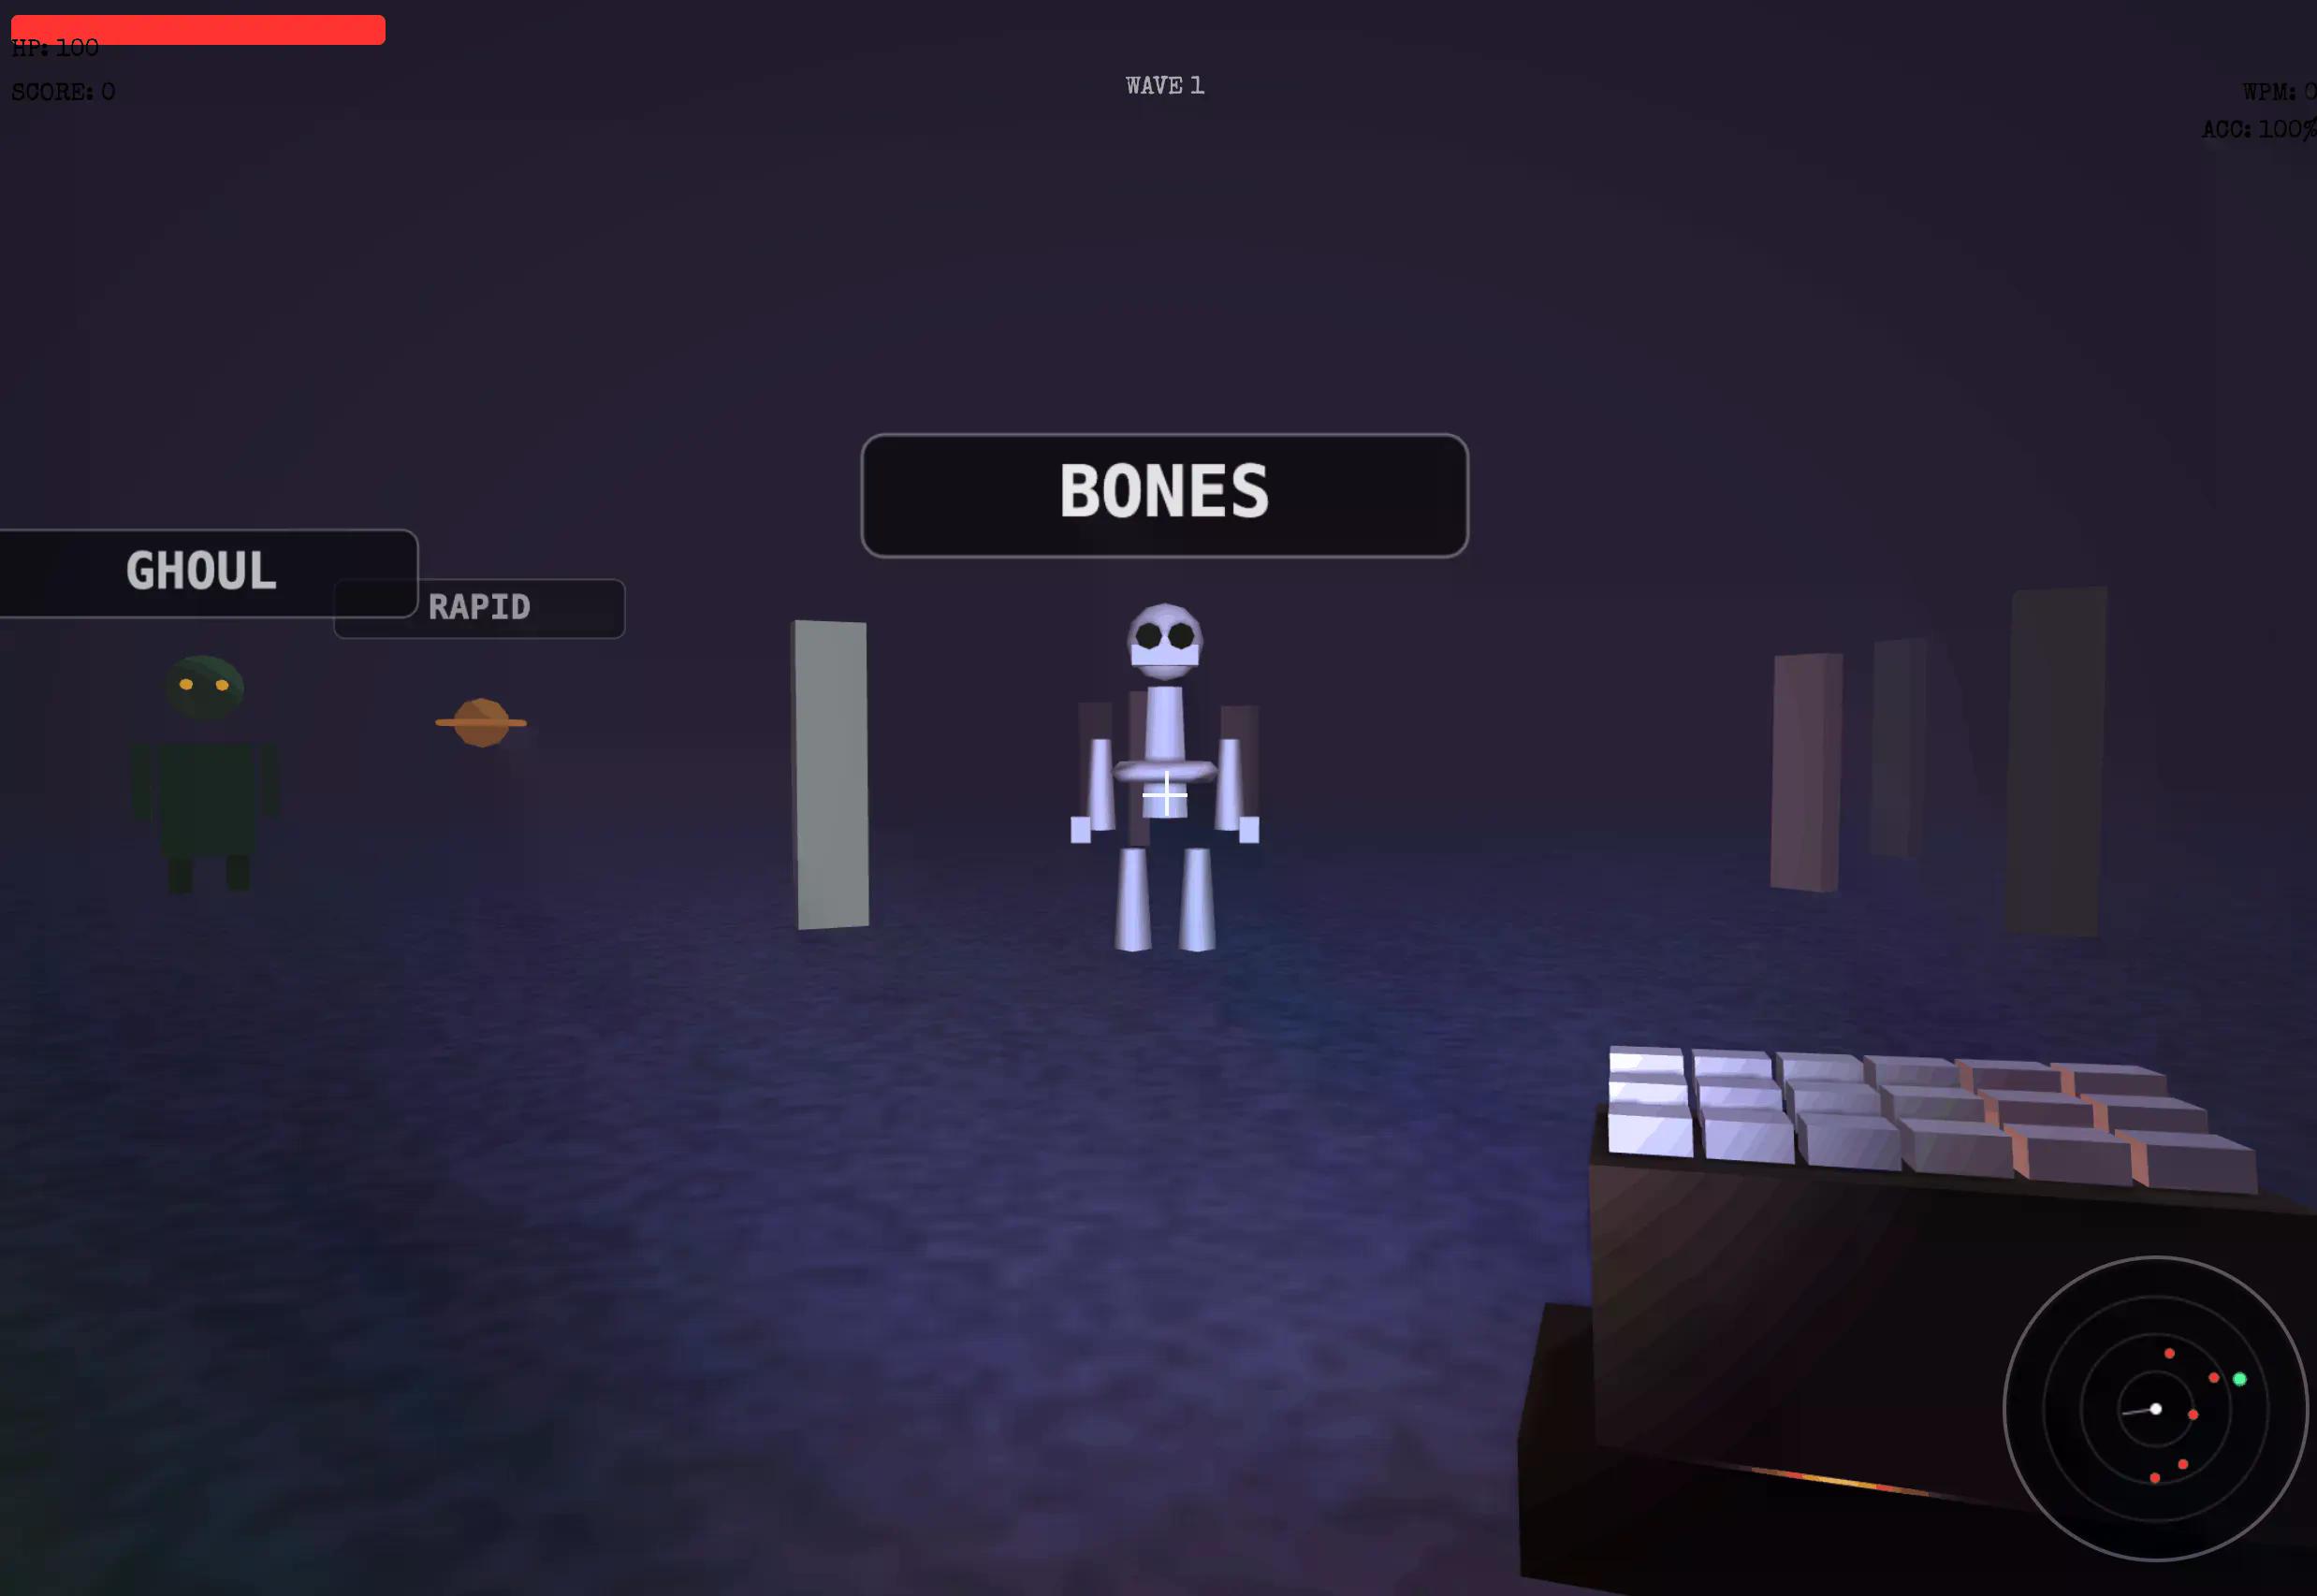
Гру можна протестувати тут.
Креативне письмо — це більш специфічна історія, і критерії тут більш суб'єктивні.
Загалом, результати не є особливо винахідливими, якщо ви маєте на увазі запит без попереднього навчання.
Однак Bonsai створює історії з послідовною внутрішньою логікою, темпом і сюжетною лінією — кращі або на рівні Claude Haiku чи навіть Sonnet з меншими зусиллями на порівнянних запитах. Для моделі, яка працює повністю на вашому власному обладнанні без витрат на API, це багато значить.
Створену нею історію можна знайти в нашому репозиторії Github.
PrismML також постачає шар спекулятивного декодування DSpark разом з моделлю — легкий драфтер, який пропонує блоки токенів-кандидатів, які основна модель перевіряє за один прямий прохід, а не генерує токен за токеном. На H100 це дає збільшення пропускної здатності в 1,37 рази без зміни якості вихідних даних, оскільки перевірка зберігає точний розподіл вихідних даних. На Apple Silicon це ще не ввімкнено за замовчуванням, але для обслуговування на GPU це реальний виграш.
Інтерес Apple додає комерційного виміру. Генеральний директор PrismML Бабак Хассібі підтвердив CNBC, що компанія веде попередні переговори з Apple, яка оцінює технологію стиснення для потенційного використання на пристроях.
Хассібі заявив, що наступною в розробці буде стиснута модель Gemma, а потім більші передові моделі; 1-бітна Bonsai 27B доступна для безкоштовного завантаження за ліцензією Apache 2.0. Якщо вам потрібен посібник з локального запуску таких моделей, перегляньте наш гайд.







