

Генеральний директор Nvidia Дженсен Хуанг минулого тижня виступив у подкасті Лекса Фрідмана і прямо заявив: "Я думаю, ми досягли ШІЗ". Через два дні найсуворіший тест в дослідженнях ШІ представив свій новітній бенчмарк для штучного загального інтелекту — і кожна передова модель набрала менше 1%.
Цього тижня Фонд ARC Prize випустив ARC-AGI-3, і результати є жорстокими. Google Gemini 3.1 Pro очолив список з 0,37%. OpenAI GPT-5.4 набрав 0,26%. Anthropic Claude Opus 4.6 вдалося досягти 0,25%, тоді як xAI Grok-4.20 набрав рівно нуль. Люди ж, тим часом, вирішили 100% завдань.
Це не вікторина, не іспит з кодування, і навіть не надскладні питання рівня доктора філософії. ARC-AGI-3 — це щось абсолютно інше, ніж усе, з чим стикалася індустрія ШІ раніше.
Бенчмарк був створений фондом Франсуа Шолле та Майка Кнупа, який заснував власну ігрову студію та створив з нуля 135 оригінальних інтерактивних середовищ. Ідея полягає в тому, щоб помістити ШІ-агента в незнайомий ігровий світ без інструкцій, без зазначених цілей та без опису правил. Агент має досліджувати, з'ясувати, що він повинен робити, скласти план і виконати його.
Якщо це звучить як щось, що може зробити будь-яка п'ятирічна дитина, ви починаєте розуміти проблему. Якщо ви хочете перевірити, чи ви кращі за ШІ, ви можете зіграти в ті самі ігри, представлені в тесті, перейшовши за цим посиланням. Ми спробували одну; спочатку було дивно, але за кілька секунд ви легко звикнете до неї.
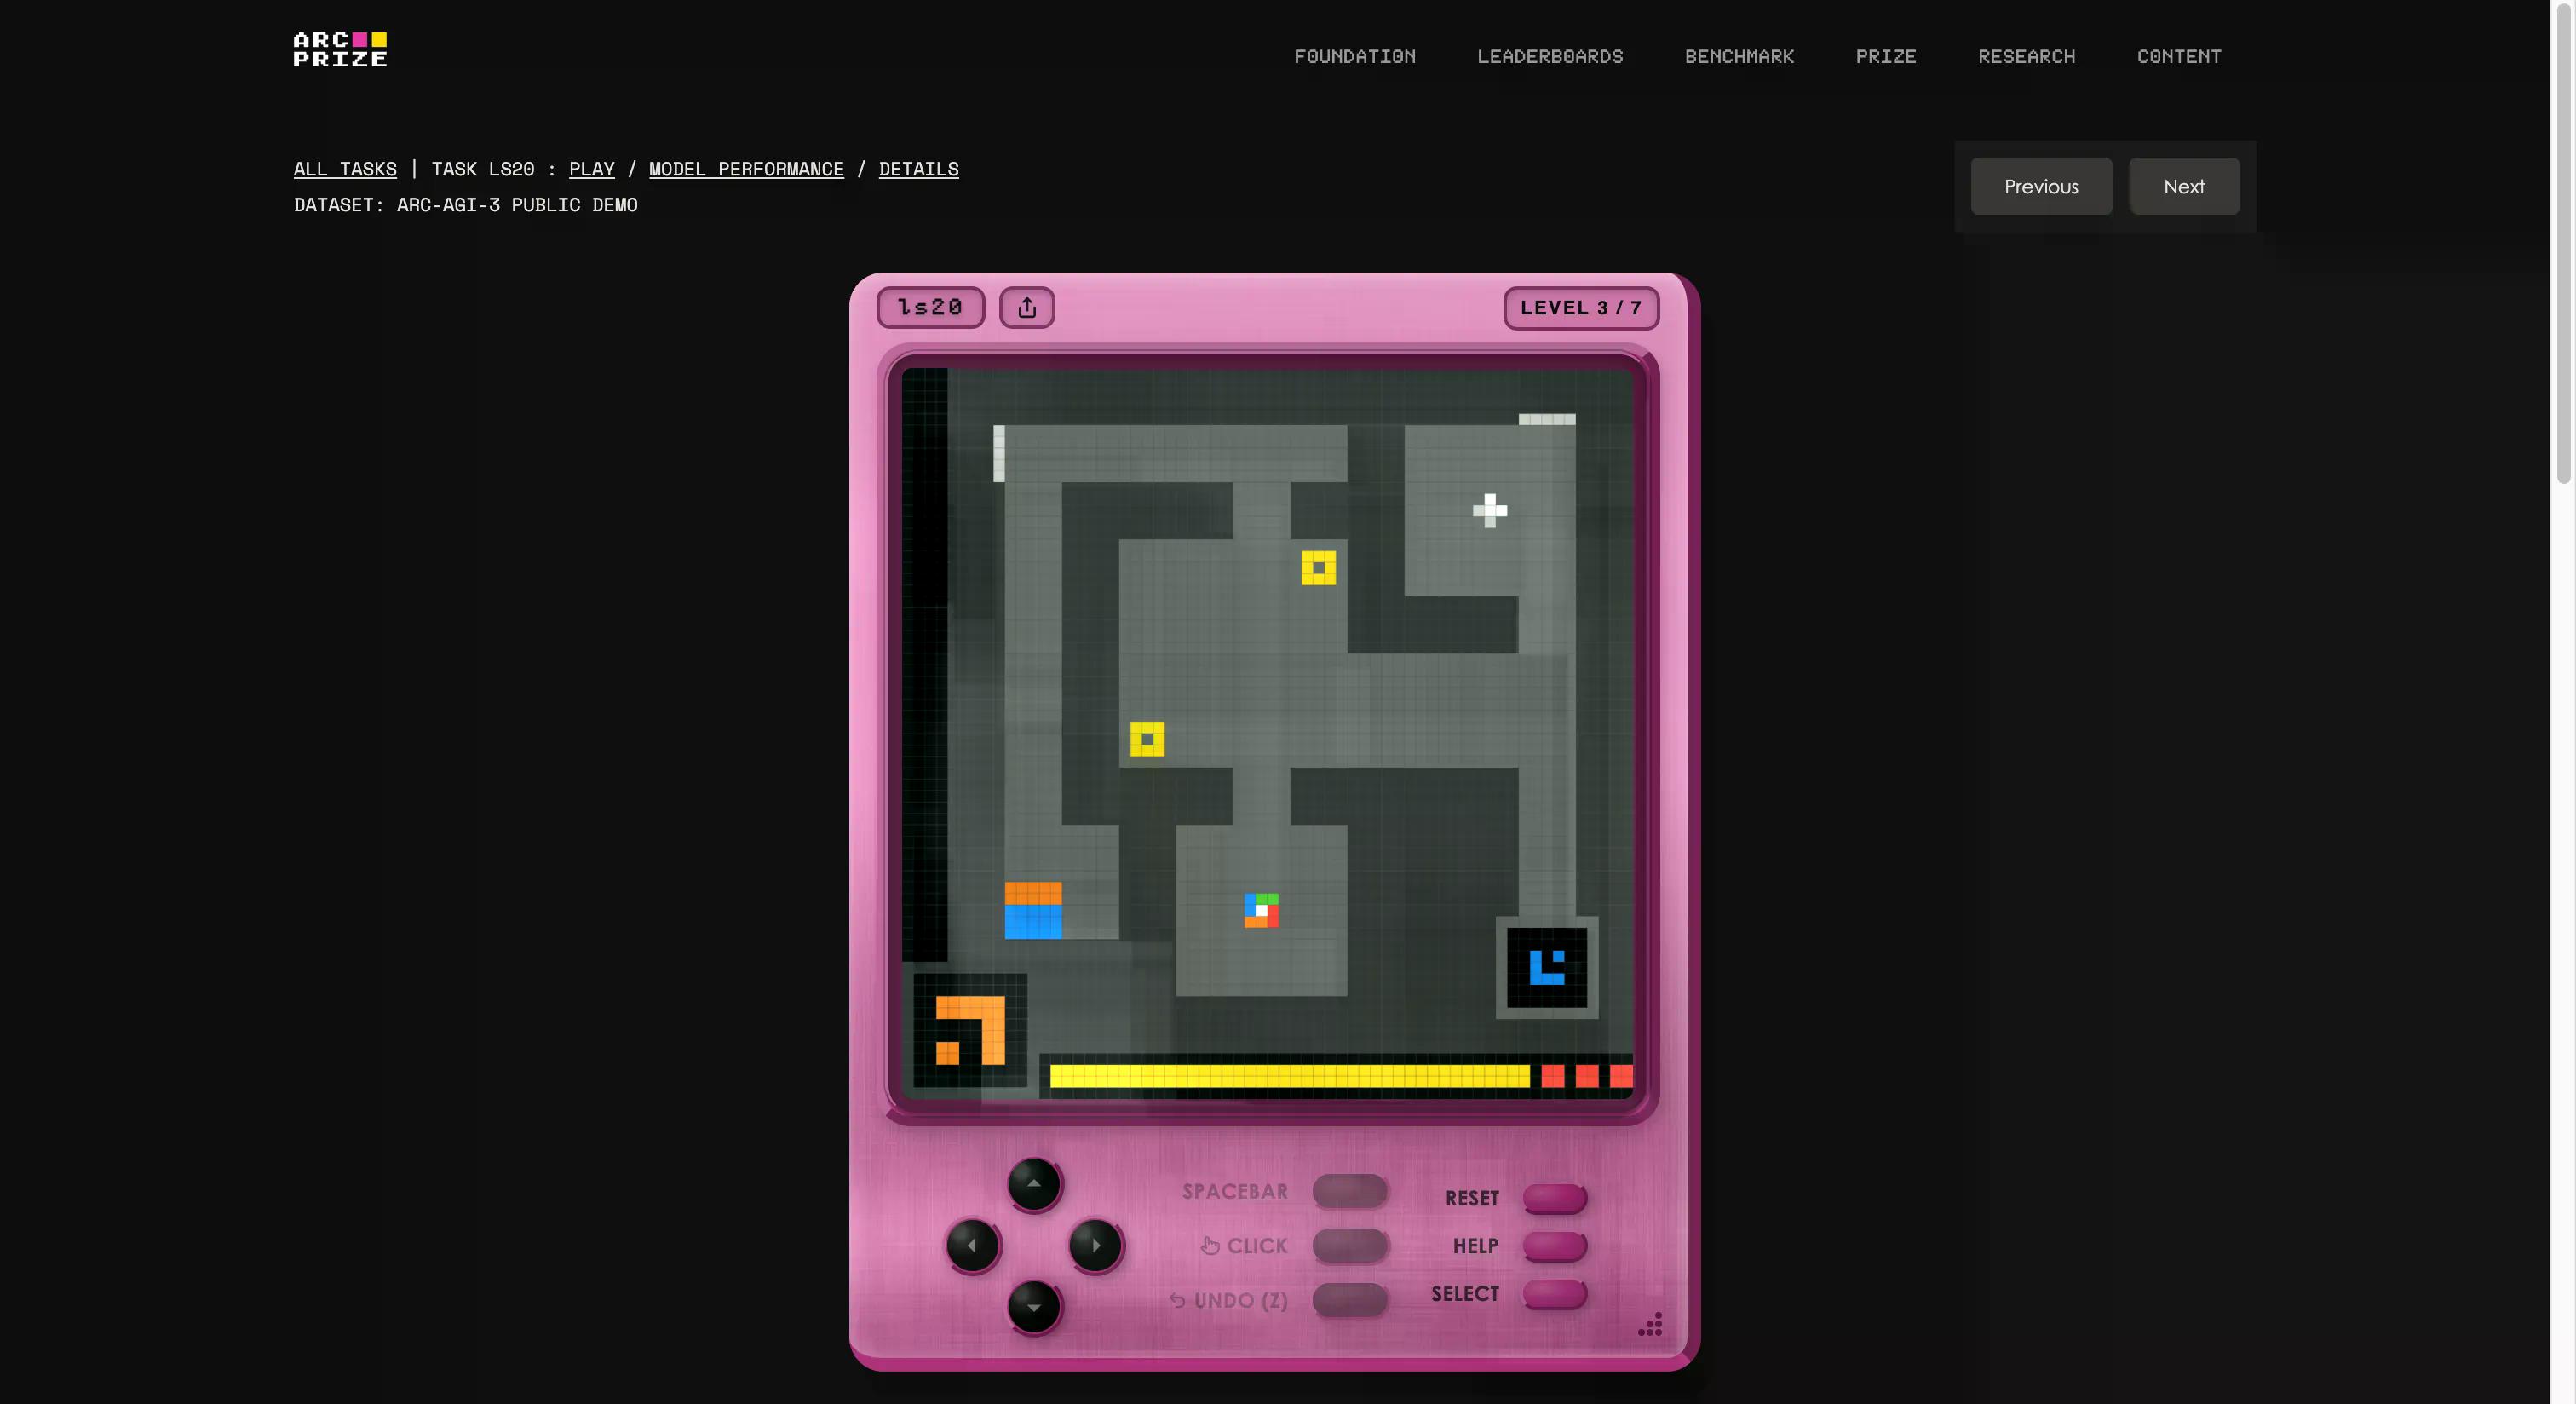
Це також є найчіткішим прикладом того, що означає буква "З" у ШІЗ (штучний загальний інтелект). Коли ви узагальнюєте, ви можете створювати нові знання (як працює дивна гра), не будучи навченим цьому заздалегідь.
Попередні версії ARC тестували статичні візуальні головоломки — показати шаблон, передбачити наступний. Спочатку вони були складними. Потім лабораторії використали обчислювальну потужність та навчання, доки бенчмарки не стали фактично неактуальними. ARC-AGI-1, представлений у 2019 році, піддався навчанню під час тестування та моделям міркування. ARC-AGI-2 протримався близько року, перш ніж Gemini 3.1 Pro досяг 77,1%. Лабораторії дуже добре насичують бенчмарки, проти яких вони можуть тренуватися.
Версія 3 була розроблена спеціально для запобігання цьому. Зі 110 із 135 середовищ, що залишилися приватними — 55 напівприватних для тестування API, 55 повністю закритих для змагань — немає набору даних для запам'ятовування. Ви не можете пробитися грубою силою крізь нову ігрову логіку, яку ніколи раніше не бачили.
Оцінювання також не є заліковим/незаліковим. ARC-AGI-3 використовує те, що фонд називає RHAE — відносна ефективність людських дій. Базовим показником є другий найкращий результат людини при першому виконанні. ШІ, який виконує в десять разів більше дій, ніж людина, отримує 1% за цей рівень, а не 10%. Формула підносить штраф за неефективність у квадрат. Безцільне блукання, повернення назад і вгадування відповіді суворо караються.
Найкращий ШІ-агент у місячному попередньому перегляді для розробників набрав 12,58%. Передові великі мовні моделі (LLM), протестовані через офіційний API без спеціальних інструментів, не змогли подолати 1%. Звичайні люди вирішили всі 135 завдань без попереднього навчання та інструкцій. Якщо це планка, то нинішні моделі її не досягають.
Тут є одна справжня методологічна дискусія. У звіті ARC зазначено, що спеціально розроблений інструмент від Duke дозволив Claude Opus 4.6 підвищити результат з 0,25% до 97,1% на одному варіанті середовища під назвою TR87. Це не означає, що Claude набрав 97,1% за ARC-AGI-3 в цілому; його офіційний бенчмарк-бал залишився 0,25%, але цю зміну все ж варто відзначити.
Офіційний бенчмарк подає агентам JSON-код, а не візуальні дані. Це або методологічний недолік, або демонстрація того, що сучасні моделі краще обробляють зручну для людини інформацію, ніж необроблені структуровані дані. Фонд Шолле визнав цю дискусію, але не змінює формат.
«Сприйняття вмісту кадру та формат API не є обмежувальними факторами для продуктивності передових моделей на ARC-AGI-3», – йдеться в документі. Іншими словами, вони, схоже, відкидають ідею про те, що моделі зазнають невдачі, тому що вони не можуть належним чином «бачити» завдання, стверджуючи натомість, що сприйняття вже є достатнім — і справжній розрив полягає в міркуваннях та узагальненні.
Перевірка реальності щодо ШІЗ відбулася протягом тижня, коли машина хайпу працювала на повну потужність. Окрім коментаря Хуанга, Arm назвала свій новий чіп для центрів обробки даних "AGI CPU". Сем Альтман з OpenAI заявив, що вони "в основному створили ШІЗ", а Microsoft вже просуває лабораторію, яка зосереджена на створенні ШНЗ: еволюції того, що йде після досягнення ШІЗ. Термін розтягується, доки він не означатиме все, що комерційно вигідно, схоже.
Позиція Шолле простіша. Якщо звичайна людина без інструкцій може це зробити, а ваша система не може, то у вас немає ШІЗ — у вас є дуже дорогий автозаповнювач, який потребує багато допомоги.
ARC Prize 2026 пропонує $2 мільйони в трьох конкурсних треках, усі розміщені на Kaggle. Кожне виграшне рішення має бути з відкритим вихідним кодом. Час йде, і зараз машини навіть близько не стоять.






 ETH

