

SpaceXAI Ілона Маска випустила Grok 4.5 у середу, це її перша публічна модель після завершення злиття SpaceX-xAI у лютому та очікуваної угоди SpaceX на $60 мільярдів щодо придбання Cursor. Вона орієнтована на програмістів, інженерів та те, що компанія називає "працівниками знань" — категорія, яка, очевидно, охоплює всіх, від розробників програмного забезпечення до юристів, що перевіряють контракти, та фінансових команд, які створюють моделі Excel.
Заява компанії полягає не в тому, що це найкраща модель. Вона полягає в тому, що вона дешева, принаймні для західної моделі. Grok 4.5 коштує $2 за мільйон вхідних токенів та $6 за мільйон вихідних. Claude Opus 4.8, основний флагман Anthropic, коштує $5 за вхідні та $25 за вихідні токени. GPT 5.6 Sol, нова топова модель OpenAI, яка також була запущена в середу, коштує $5 за вхідні та $30 за вихідні токени.
Маск опублікував на X та уточнив, де насправді позиціонується його нова модель. Він назвав її "приблизно порівнянною з Opus 4.7, але значно швидшою". Opus 4.7 — це попередній флагман Anthropic; Opus 4.8 відтоді замінив його. Claude Fable 5 тепер є найсучаснішою пропозицією Anthropic.
Він представив це як свідомий компроміс: швидкість та вартість замість сирої потужності, з інженерами Tesla та SpaceX як доказом реальної корисності.
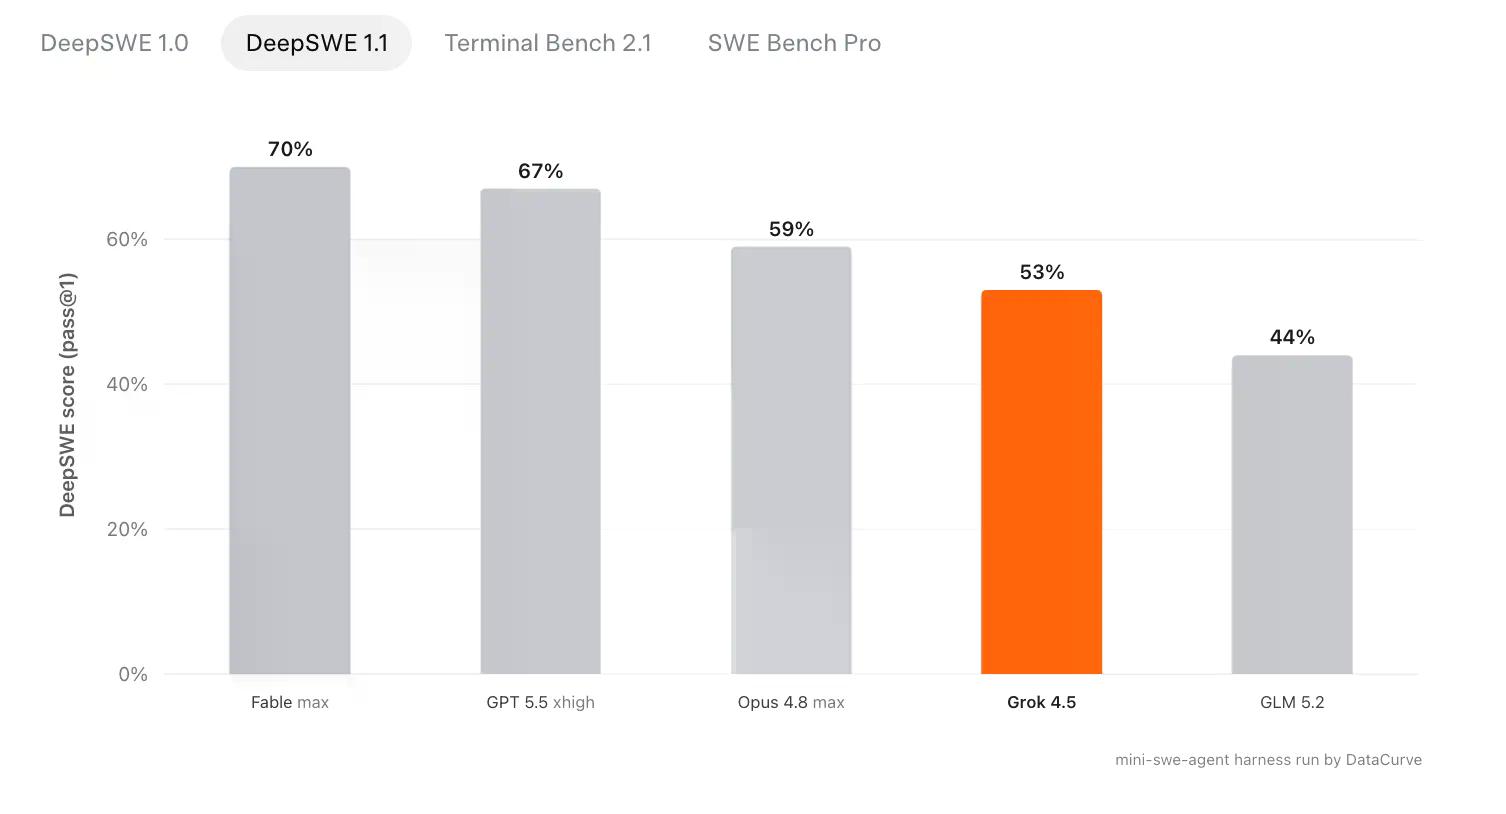
SpaceXAI опублікувала чотири результати бенчмарків під час запуску, і картина неоднозначна. DeepSWE 1.1 вимірює, наскільки надійно ШІ може усувати реальні програмні помилки, подані розробниками, використовуючи стандартизовану тестову систему для справедливого порівняння моделей, оцінюючи за відсотком виправлених проблем. Grok 4.5 набрав 53%, відстаючи від Claude Opus 4.8 (59%) та GPT 5.5 (67%). Claude Fable 5, передова модель Anthropic, очолила рейтинг із 70%.
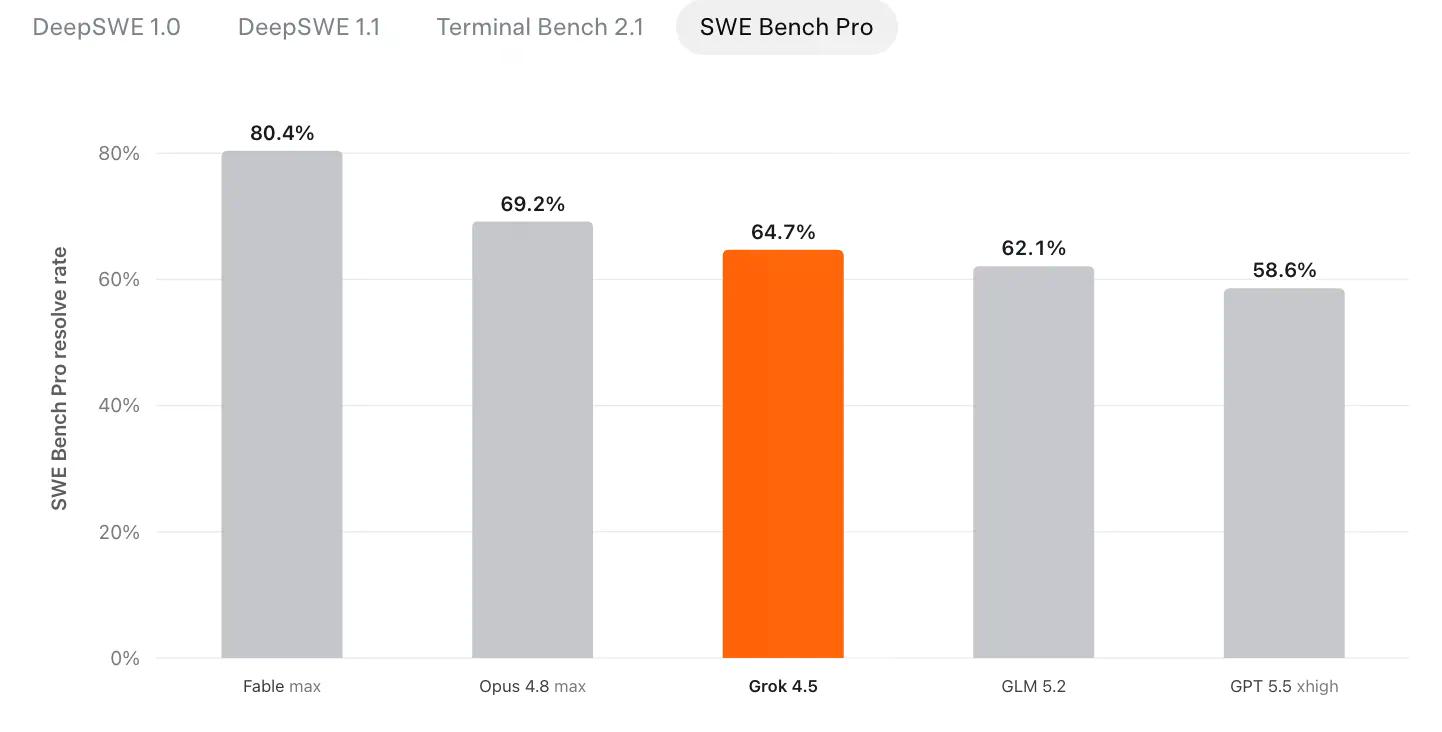
У SWE Bench Pro, ще одному бенчмарку, який вимірює набір проблем програмної інженерії, оцінених за швидкістю вирішення, Grok 4.5 показав 64.7%, що достатньо для перевершення GPT 5.5 з його 58.6% у цьому конкретному тесті. Opus 4.8 все ще лідирує з 69.2%, а Fable 5 має 80.4%.
Бенчмарки компанії порівнюються з GPT 5.5, а не з GPT 5.6, оскільки остання також була запущена в середу, через кілька годин після анонсу Grok 4.5.
SpaceXAI навчала Grok 4.5 у співпраці з нещодавно придбаною Cursor AI на десятках тисяч графічних процесорів Nvidia GB300 всередині Colossus, суперкомп'ютера в Мемфісі із загальною потужністю понад 200 000 графічних процесорів. Лабораторії, чиї моделі перевершують її в цих самих бенчмарках, не мають нічого схожого на таке обладнання. Модель, що вийшла, конкурентоспроможна, але не перша.
Ця закономірність простежується за Grok у кількох релізах. SpaceXAI постійно демонструє величезні обчислювальні потужності та результати на третьому місці. Що змінилося з Grok 4.5, так це ціноутворення та сигнал навчання.
Кращий аргумент не в сирій продуктивності; це математика ефективності. У завданнях SWE Bench Pro Grok 4.5 використовував в середньому 15 954 вихідних токени для виконання кожного завдання. Opus 4.8 витратив 67 020 токенів для тієї ж роботи, що становить різницю в 4.2 рази.
Для команд, які використовують ШІ у великих обсягах, ця різниця перетворюється на реальну економію, на додаток до вже нижчої ціни за токен. Навіть незважаючи на низькі показники Grok 4.5 у бенчмарках якості, дешевші токени та більша ефективність використання дозволяють виконувати більше ітерацій без значних витрат.
Модель також працює зі швидкістю 80 токенів на секунду, що є територією швидких моделей. Grok 4.5 був навчений на даних сесій розробників з Cursor, включаючи трасування налагодження та реальні редагування коду, а не статичні репозиторії. Як Маск визнав у суді, практика навчання xAI вже викликала пильну увагу; цього разу конвеєр проходить через платформу, яку SpaceX знаходиться в процесі повного придбання.
Для розробників, які виконують великі обсяги завдань з кодування, математика працює: приблизно можливості Opus 4.7 за 60% меншу ціну за вхідний токен. Для тих, хто шукає передові рішення, Claude Fable 5 лідирує в кожній категорії, яку SpaceXAI вирішила опублікувати. Наш швидкий тест за допомогою Grok, створеного на Hermes, був невтішним для творчого письма та прийнятним для простого завдання з кодування.
Модель доступна через API, на платформах Hermes та Grok build з контекстом у півмільйона токенів (трохи менше 400 000 слів). Європейським користувачам доведеться зачекати перед її використанням; SpaceXAI заявляє, що Grok 4.5 буде доступний в ЄС у середині липня.







