

DeepSeek повернувся, і це відбулося за кілька годин після того, як OpenAI випустив GPT-5.5. Збіг? Можливо. Але якщо ви китайська лабораторія штучного інтелекту, яку уряд США намагається сповільнити заборонами на експорт чіпів протягом останніх трьох років, ваше почуття часу стає досить гострим.
Лабораторія з Ханчжоу сьогодні випустила попередні версії DeepSeek-V4-Pro та DeepSeek-V4-Flash, обидві з відкритим кодом, обидві з контекстними вікнами на один мільйон токенів. Це означає, що ви можете працювати з контекстом розміром приблизно з трилогію "Володар кілець", перш ніж модель "зламається". Обидві моделі також коштують значно дешевше, ніж будь-які порівнянні аналоги на Заході, і обидві безкоштовні для тих, хто може запускати їх локально.
Останнє значне потрясіння від DeepSeek — R1 у січні 2025 року — знищило 600 мільярдів доларів ринкової капіталізації Nvidia за один день, оскільки інвестори поставили під сумнів, чи дійсно американським компаніям потрібні такі величезні інвестиції для досягнення результатів, яких невелика китайська лабораторія досягла за частку вартості. V4 – це інший тип кроку: тихіший, більш технічний і більше зосереджений на ефективності для тих, хто насправді створює щось за допомогою ШІ.
Серед двох нових моделей, DeepSeek's V4-Pro є найбільшою, маючи 1,6 трильйона загальних параметрів. Щоб уявити це в перспективі, параметри – це внутрішні "налаштування" або "клітини мозку", які модель використовує для зберігання знань та розпізнавання закономірностей – чим більше параметрів має модель, тим складнішу інформацію вона теоретично може утримувати. Це робить її найбільшою моделлю з відкритим кодом на ринку LLM на сьогоднішній день. Розмір може здатися смішним, поки ви не дізнаєтеся, що вона активує лише 49 мільярдів з них за один прохід висновку.
Це трюк "Суміші експертів" (Mixture-of-Experts), який DeepSeek удосконалив з часів V3: повна модель залишається на місці, але лише відповідна її частина активується для кожного запиту. Більше знань, та сама вартість обчислень.
"DeepSeek-V4-Pro-Max, режим максимальних обчислювальних зусиль DeepSeek-V4-Pro, значно розширює можливості відкритих моделей у сфері знань, впевнено затверджуючи себе як найкраща відкрита модель, доступна на сьогодні", – написав Deepseek в офіційній картці моделі на Huggingface. "Вона досягає найвищої продуктивності в бенчмарках кодування та значно зменшує розрив з провідними закритими моделями в завданнях міркування та агентних завданнях".
V4-Flash – це практична модель: 284 мільярди загальних параметрів, 13 мільярдів активних. Вона розроблена бути швидшою, дешевшою, і, згідно з власними бенчмарками DeepSeek, "досягає порівнянної продуктивності міркування з версією Pro при наданні більшого бюджету на обдумування".
Обидві підтримують контекст в один мільйон токенів. Це приблизно 750 000 слів — приблизно вся трилогія "Володар Кілець" і ще трохи. І це стандартна функція, а не преміальний рівень.
Ось технічна частина для "нердів" або тих, хто цікавиться магією, що живить модель. Deepseek не приховує своїх секретів, і все доступно безкоштовно — повна стаття доступна на Github.
Стандартна увага ШІ — механізм, що дозволяє моделі розуміти взаємозв'язки між словами — має жорстоку проблему масштабування. Щоразу, коли ви подвоюєте довжину контексту, обчислювальна вартість приблизно збільшується в чотири рази. Отже, запуск моделі на мільйоні токенів не просто вдвічі дорожчий, ніж на 500 000 токенах. Це в чотири рази дорожче. Ось чому довгий контекст історично був прапорцем, який лабораторії додавали, а потім тихо обмежували.
DeepSeek винайшов два нових типи уваги, щоб обійти це. Перший, Compressed Sparse Attention (Стиснута розріджена увага), працює у два етапи. Спочатку він стискає групи токенів — скажімо, кожні 4 токени — в один запис. Потім, замість того, щоб звертати увагу на всі ці стиснуті записи, він використовує "Lightning Indexer" для вибору лише найбільш релевантних результатів для будь-якого заданого запиту. Ваша модель переходить від обробки мільйона токенів до обробки набагато меншого набору найважливіших фрагментів, наче бібліотекар, який не читає кожну книгу, але точно знає, на якій полиці шукати.
Другий тип, Heavily Compressed Attention (Сильно стиснута увага), є більш агресивним. Він згортає кожні 128 токенів в один запис — без розрідженого вибору, лише жорстоке стиснення. Ви втрачаєте дрібні деталі, але отримуєте надзвичайно дешевий глобальний огляд. Два типи уваги працюють в чергуванні шарів, тому модель отримує як деталі, так і загальний огляд.
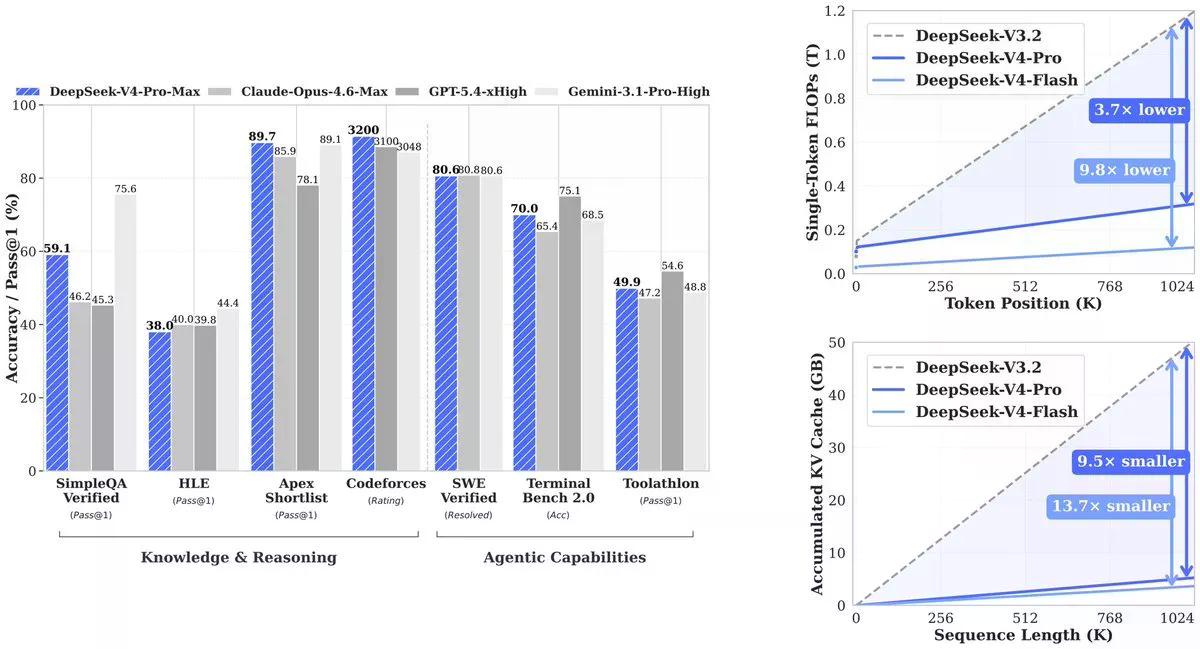
Результат, з технічного документу: На одному мільйоні токенів V4-Pro використовує 27% обчислювальної потужності, яка була потрібна його попереднику (V3.2). Кеш KV — пам'ять, яка потрібна моделі для відстеження контексту — зменшується до лише 10% від V3.2. V4-Flash йде ще далі: 10% обчислювальної потужності, 7% пам'яті.
І це призвело до того, що Deepseek зміг запропонувати набагато нижчу ціну за токен, ніж його конкуренти, забезпечуючи при цьому порівнянні результати. Щоб перевести це в доларовий еквівалент: GPT-5.5, запущений вчора, коштує $5 за мільйон вхідних токенів і $30 за мільйон вихідних токенів, при цьому ціна GPT-5.5 Pro становить $30 за мільйон вхідних токенів і $180 за мільйон вихідних токенів.
Deepseek V4-Pro коштує $1.74 (вхід) та $3.48 (вихід). V4-Flash коштує $0.14 (вхід) та $0.28 (вихід). Генеральний директор Cline Сауд Різван зазначив, що якби Uber використовував DeepSeek замість Claude, його бюджет на ШІ на 2026 рік – якого, за чутками, вистачало на чотири місяці використання – вистачило б на сім років.
deepseek v4 is now the cheapest sota model available at 1/20th the cost of opus 4.7.
for perspective, if uber used deepseek instead of claude their 2026 ai budget would have lasted 7 years instead of only 4 months. pic.twitter.com/i9rJZzvRBV
— Saoud Rizwan (@sdrzn) April 24, 2026
DeepSeek робить щось незвичайне у своєму технічному звіті: публікує недоліки. Більшість релізів моделей вибірково показують лише ті бенчмарки, де вони виграють. DeepSeek провів повне порівняння з GPT-5.4 та Gemini-3.1-Pro, виявив, що міркування V4-Pro відстають від цих моделей приблизно на три-шість місяців, і все одно опублікував це.
Де V4-Pro-Max насправді перемагає: Codeforces, бенчмарк з конкурентного програмування, оцінений як людські шахи. V4-Pro набрав 3 206 балів, що ставить його приблизно на 23-е місце серед реальних учасників конкурсу. На Apex Shortlist, відібраному наборі складних математичних та STEM-задач, він показав прохідний бал і досяг 90,2% проти 85,9% у Opus 4.6 та 78,1% у GPT-5.4. На SWE-Verified, який вимірює, наскільки добре модель може вирішувати реальні проблеми GitHub, взяті з реальних репозиторіїв з відкритим вихідним кодом, він набрав 80,6% — відповідає Claude Opus 4.6.
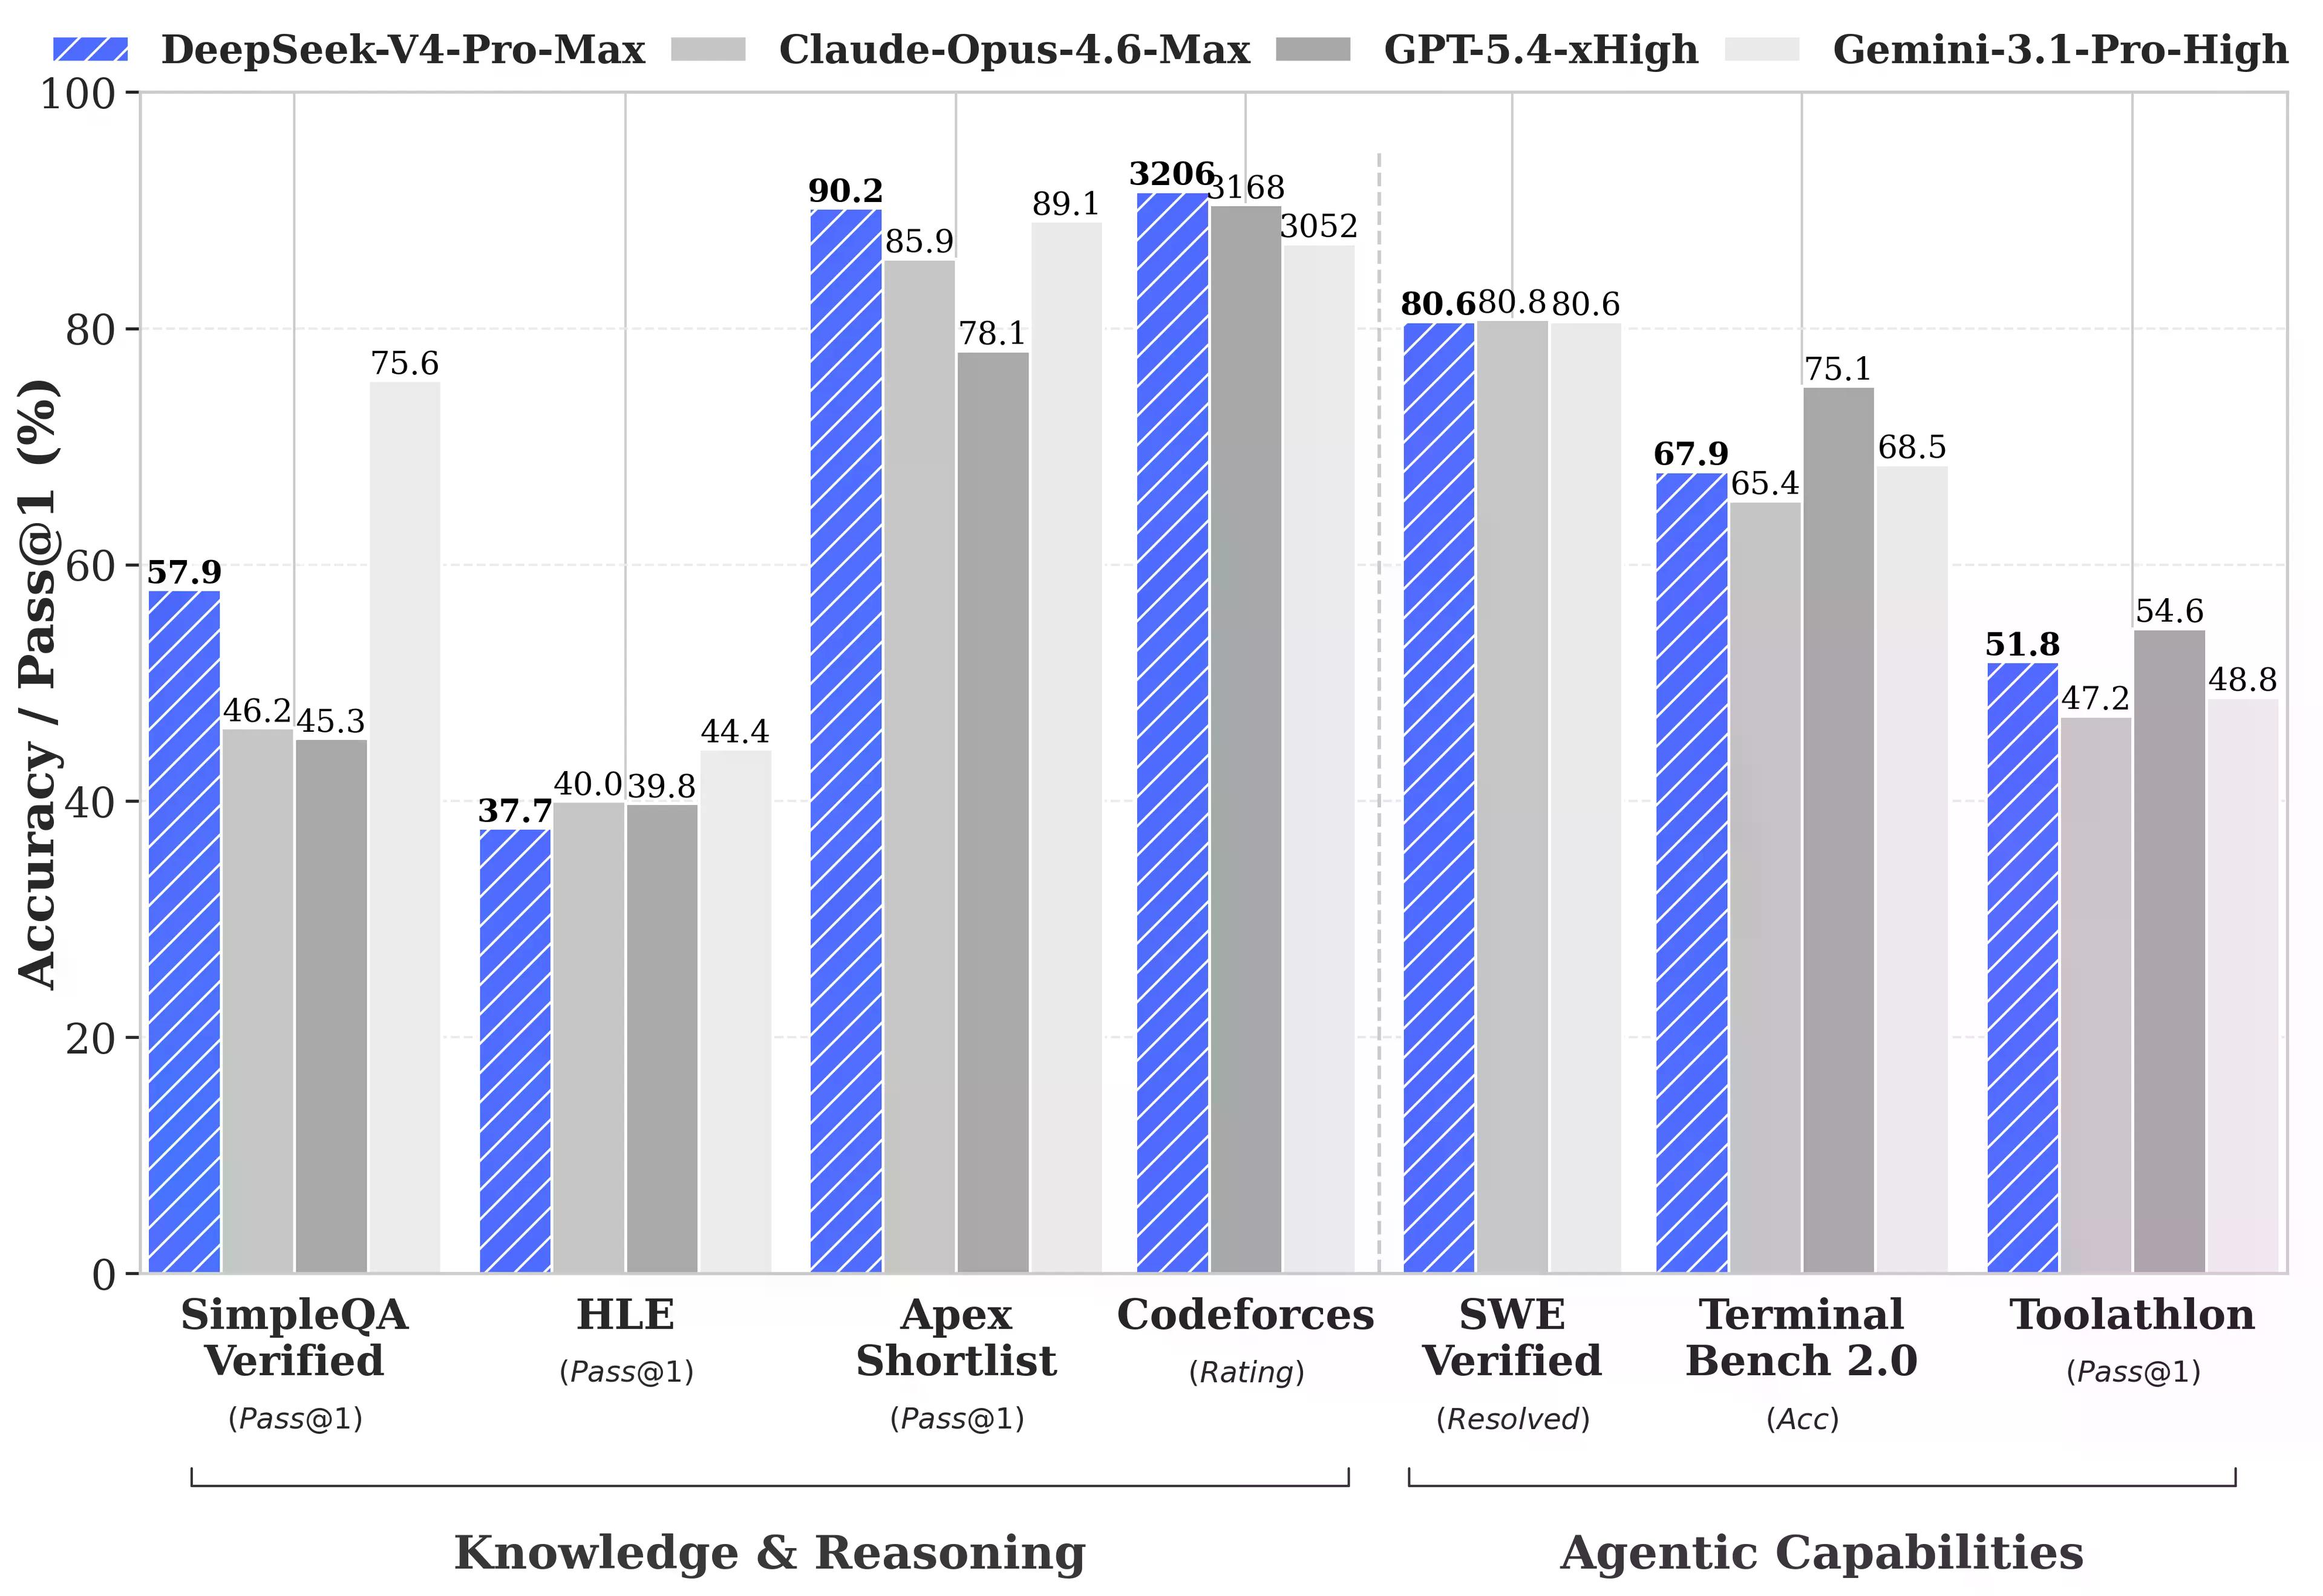
Де вона відстає: бенчмарк багатозадачності MMLU-Pro (Gemini-3.1-Pro на 91,0% проти V4-Pro на 87,5%), бенчмарк експертних знань GPQA Diamond (Gemini 94,3 проти V4-Pro 90,1) та Humanity's Last Exam, бенчмарк для випускників, де 44,4% Gemini-3.1-Pro все ще перевершують 37,7% V4-Pro.
Що стосується саме довгого контексту, V4-Pro лідирує серед моделей з відкритим вихідним кодом і перевершує Gemini-3.1-Pro в бенчмарку CorpusQA (тест, що імітує реальний аналіз документів на один мільйон токенів), але програє Claude Opus 4.6 в MRCR — тесті, що вимірює, наскільки добре модель витягує конкретні "голки", заховані глибоко в дуже великій "стіжці сіна".
Агентські можливості – це те, що робить цей реліз цікавим для розробників, які насправді випускають продукти.
V4-Pro може працювати в Claude Code, OpenCode та інших інструментах кодування ШІ. Згідно з внутрішнім опитуванням DeepSeek серед 85 розробників, які використовували V4-Pro як свого основного агента кодування, 52% сказали, що він готовий стати їхньою моделлю за замовчуванням, 39% схилялися до "так", і менше 9% сказали "ні". Внутрішні співробітники зазначили, що він перевершує Claude Sonnet і наближається до Claude Opus 4.5 у завданнях агентного кодування.
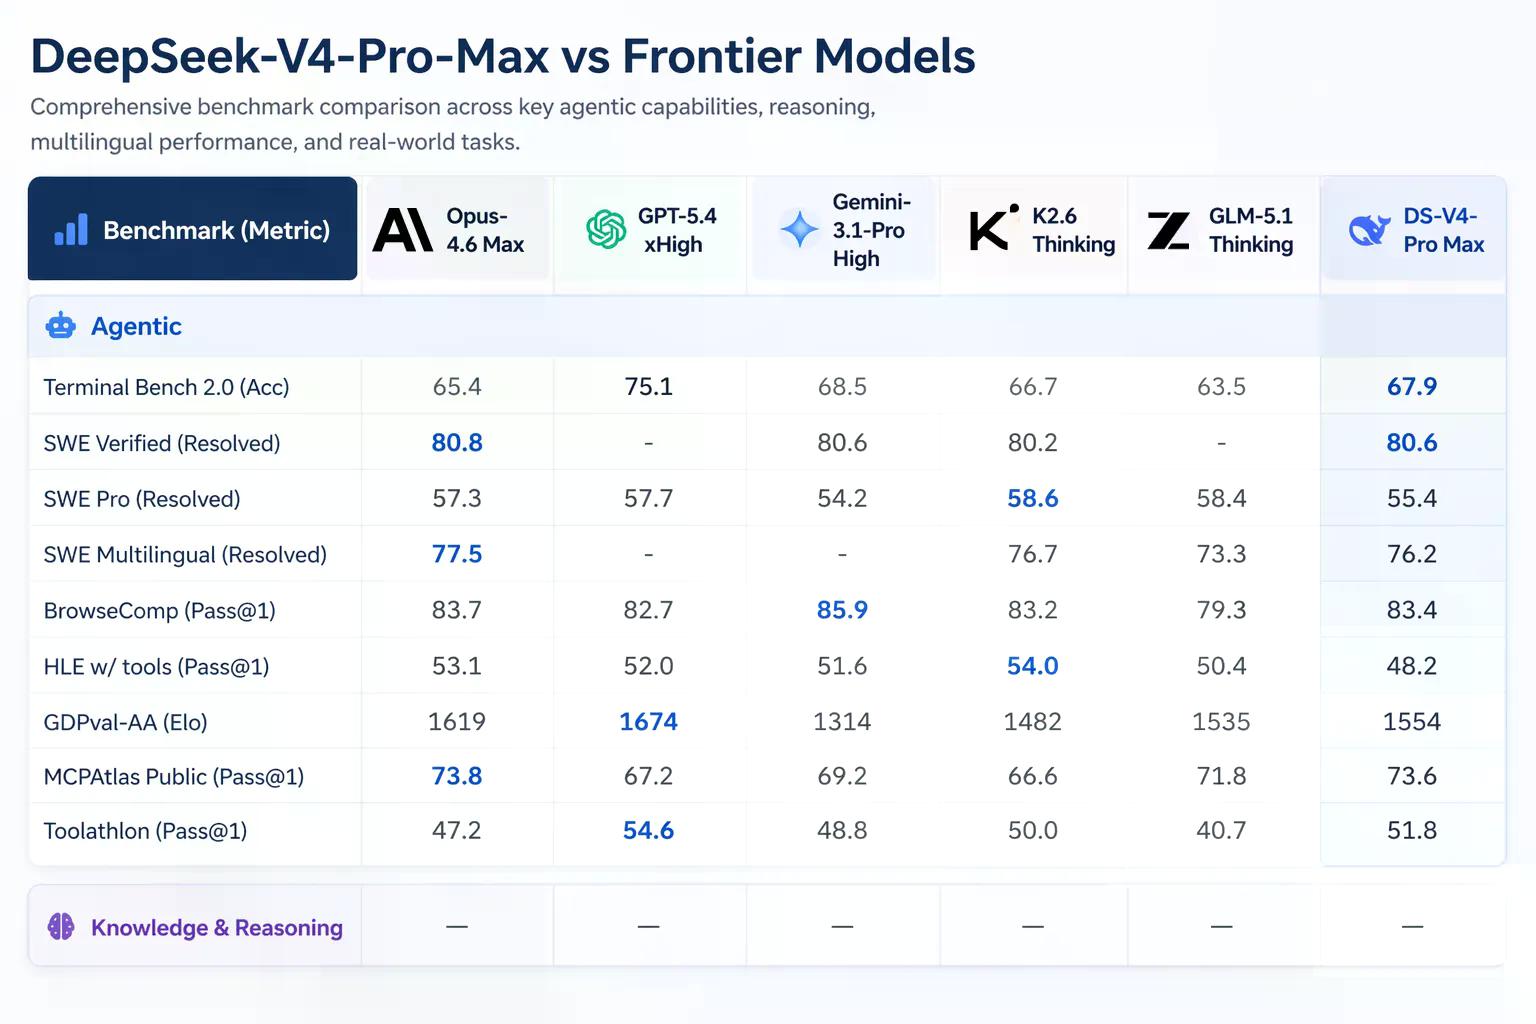
Artificial Analysis, яка проводить незалежні оцінки моделей ШІ на реальних завданнях, поставила V4-Pro на перше місце серед усіх моделей з відкритою вагою в GDPval-AA — бенчмарку, що тестує економічно цінну розумову працю у фінансах, праві та дослідницьких завданнях, оцінених за Elo. V4-Pro-Max набрав 1 554 Elo, випереджаючи GLM-5.1 (1 535) та MiniMax's M2.7 (1 514). Для довідки, Claude Opus 4.6 набирає 1 619 на тому ж бенчмарку — все ще випереджає, але розрив скорочується.
DeepSeek V4 Pro is the #1 open weights model on GDPval-AA, our agentic real-world work tasks evaluation@deepseek_ai has released V4 Pro (1.6T total / 49B active) and V4 Flash (284B total / 13B active). V4 is DeepSeek's first new size since V3, with all intermediate models… pic.twitter.com/2kJWVrKQjF
— Artificial Analysis (@ArtificialAnlys) April 24, 2026
Deepseek V4 також представляє щось під назвою "переплетене мислення". У попередніх моделях, якщо ви запускали агента, який робив кілька викликів інструментів — скажімо, він шукав в Інтернеті, потім запускав якийсь код, потім знову шукав — контекст міркувань моделі скидався між раундами. Кожен новий крок модель мала відтворювати свою ментальну модель з нуля. V4 зберігає повний ланцюжок думок між викликами інструментів, тому 20-кроковий робочий процес агента не страждає від амнезії на півдорозі. Це важливіше, ніж здається, для тих, хто запускає складні автоматизовані конвеєри.
США обмежують експорт високоякісних чіпів Nvidia до Китаю з 2022 року. Заявленою метою було уповільнення розвитку китайського ШІ, але заборона на чіпи не зупинила DeepSeek, а натомість змусила їх винайти більш ефективну архітектуру та розбудувати внутрішній ринок обладнання.
DeepSeek випустила V4 не в вакуумі — сфера ШІ останнім часом була переповнена активністю: Anthropic випустила Claude Opus 4.7 16 квітня — модель, яку _Decrypt_ протестував і визнав сильною в кодуванні та міркуваннях, з помітно високим використанням токенів. За день до цього Anthropic також працювала над Claude Mythos, моделлю кібербезпеки, яку, за її словами, вона не може випустити публічно, тому що вона занадто добре справляється з автономними мережевими атаками.
Xiaomi випустила MiMo V2.5 Pro 22 квітня, повністю перейшовши на мультимодальність — зображення, аудіо, відео. Вартість $1 за мільйон вхідних токенів і $3 за мільйон вихідних. Вона відповідає Opus 4.6 за більшістю бенчмарків кодування. Три місяці тому ніхто не говорив про Xiaomi як про передову компанію ШІ. Тепер вона випускає конкурентоспроможні моделі швидше, ніж більшість західних лабораторій.
GPT-5.5 від OpenAI з’явився вчора, а його вартість зросла до 180 доларів за мільйон вихідних токенів у версії Pro. Він перевершує V4-Pro на Terminal Bench 2.0 (82,7% проти 70,0%), який тестує складні робочі процеси агентів командного рядка. Але він коштує значно дорожче, ніж V4-Pro для еквівалентних завдань. Того ж дня Tencent випустила Hy3, ще одну сучасну модель, орієнтовану на ефективність.
Отже, з такою кількістю нових моделей питання, яке насправді задають розробники: коли преміум-клас того вартий?
Для підприємств математика, можливо, змінилася. Модель, яка лідирує в бенчмарках з відкритим кодом за 1,74 долара за мільйон вхідних токенів, означає, що великомасштабна обробка документів, юридична експертиза або конвеєри генерації коду, які шість місяців тому були дорогими, тепер значно дешевші. Контекст в один мільйон токенів означає, що ви можете подавати цілі кодові бази або регуляторні документи одним запитом замість того, щоб розбивати їх на кілька викликів.
Крім того, його відкритий вихідний код означає, що його можна не тільки безкоштовно запускати на локальному обладнанні, але й налаштовувати та вдосконалювати відповідно до потреб та випадків використання компанії.
Для розробників та індивідуальних творців V4-Flash — це те, на що варто звернути увагу. За $0.14 вхідних токенів та $0.28 вихідних токенів вона дешевша, ніж моделі, які рік тому вважалися бюджетними варіантами — і вона справляється з більшістю завдань, з якими справляється версія Pro. Існуючі кінцеві точки DeepSeek deepseek-chat та deepseek-reasoner вже направляють запити до V4-Flash у режимах без мислення та мислення відповідно, тому, якщо ви використовуєте API, ви вже її використовуєте.
Моделі поки що лише текстові. DeepSeek заявив, що працює над мультимодальними можливостями, що означає, що інші великі лабораторії від Xiaomi до OpenAI все ще мають цю перевагу. Обидві моделі мають ліцензію MIT і доступні на Hugging Face сьогодні. Старі кінцеві точки deepseek-chat і deepseek-reasoner будуть виведені з експлуатації 24 липня 2026 року.







