

Z.ai представив GLM-5.2 16 червня, обіцяючи найвищу продуктивність, що перевершує його вже просунуту модель GLM 5.1.
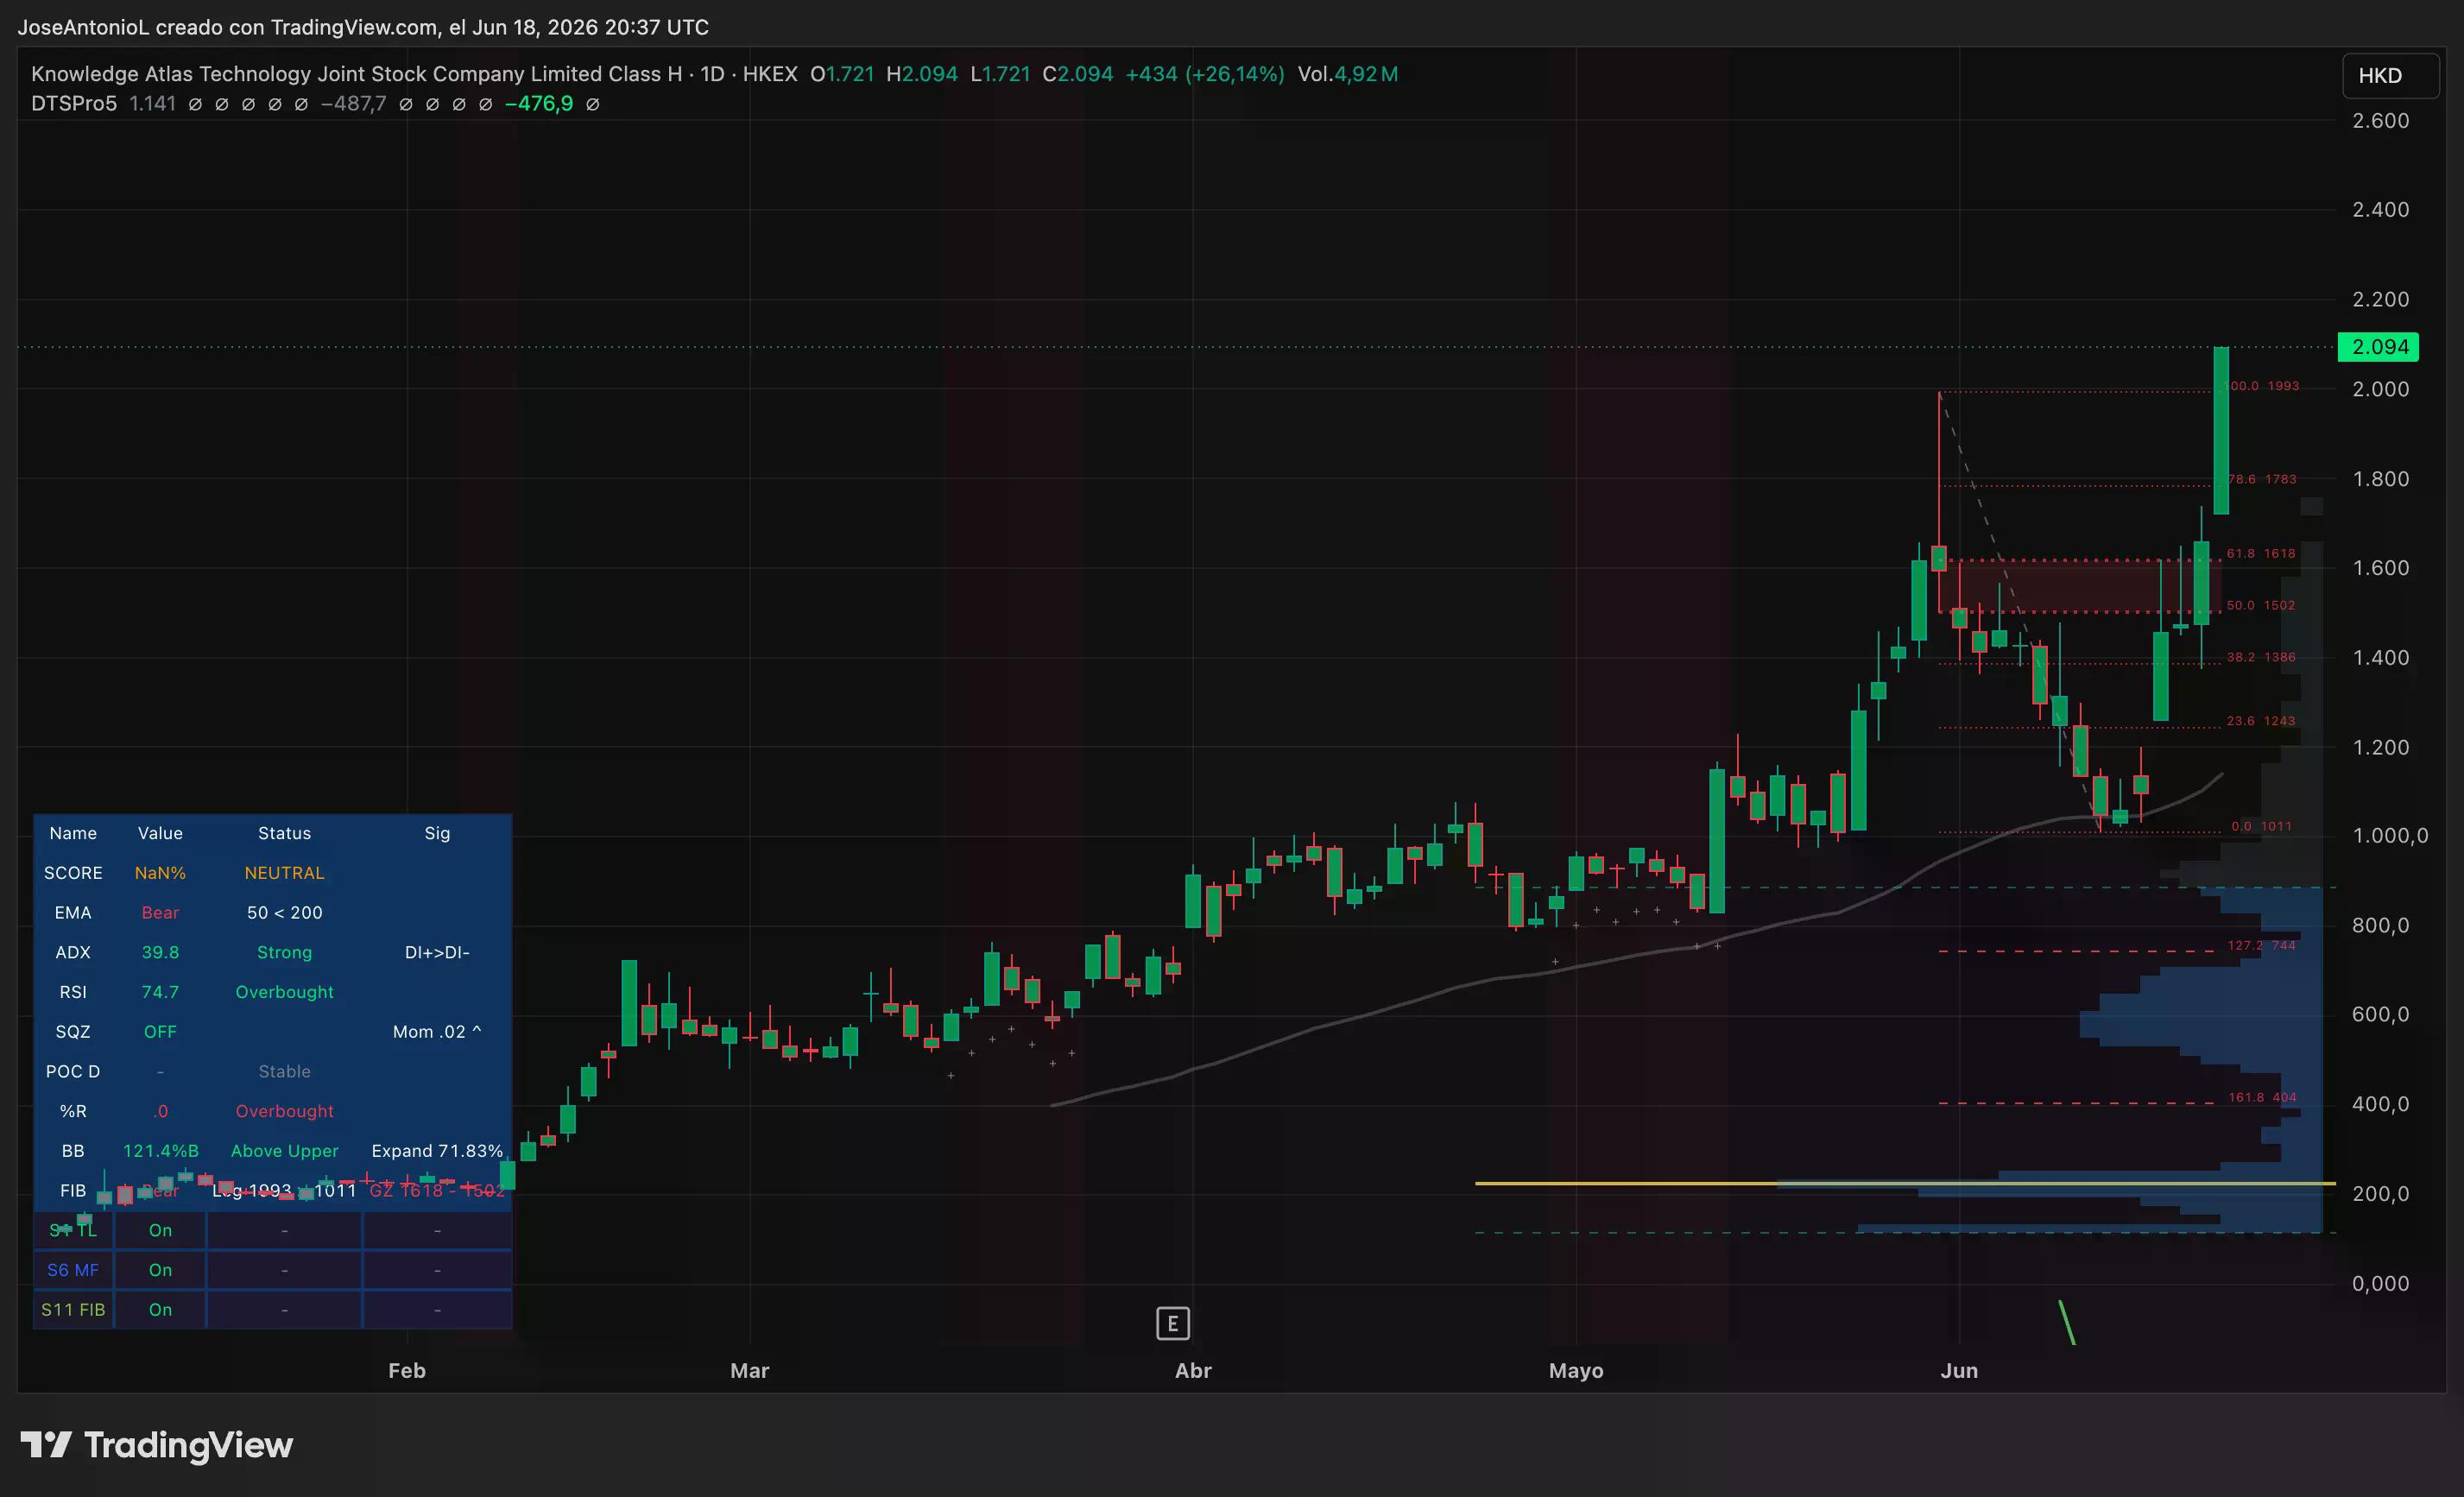
Пекінська лабораторія, яка перебуває в списку санкцій США з січня 2025 року, схоже, виграє від зростання занепокоєння щодо підходу Америки до штучного інтелекту. Протягом останнього тижня заборона на Anthropic Fable та випуск цієї нової моделі допомогли підвищити вартість акцій zAI на 90%, досягнувши нового історичного максимуму.
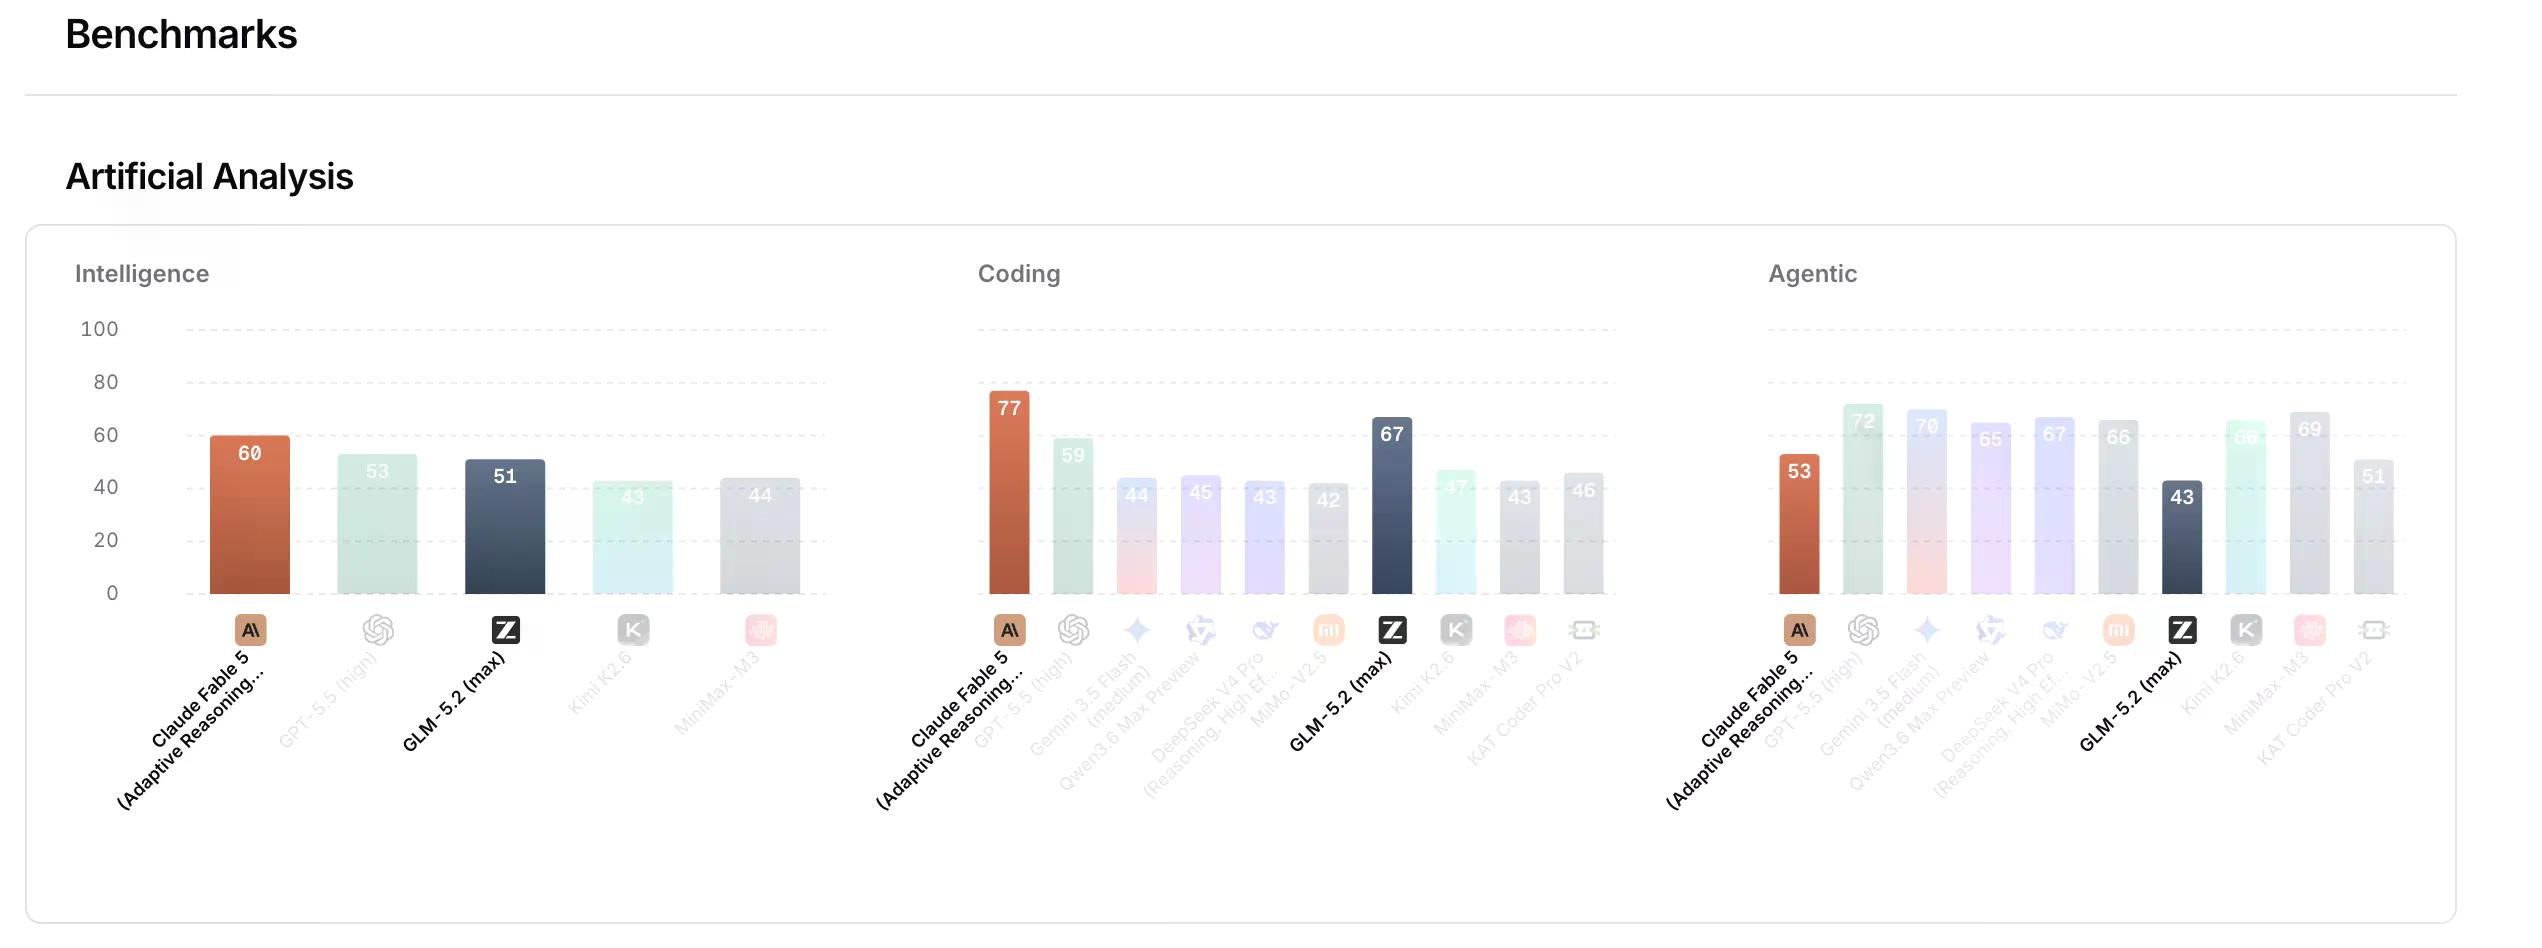
GLM 5.2 має цифри, щоб підтвердити ажіотаж.
На FrontierSWE — бенчмарку, який оцінює, чи може агент ШІ завершити відкриті технічні проєкти, що вимірюються годинами, охоплюючи оптимізацію систем, великомасштабне конструювання коду та прикладні дослідження машинного навчання, оцінені за показником домінування — GLM-5.2 набрав 74.4 проти 75.1 у Claude Opus 4.8. Він випередив GPT-5.5 з результатом 72.6. На SWE-bench Pro, який тестує автономне вирішення реальних проблем GitHub, оцінених як відсоток успішних рішень, GLM-5.2 набрав 62.1 проти 58.6 у GPT-5.5 — і значно перевищив показник свого попередника GLM-5.1 у 58.4.
Стрибок якості робить її найкращою відкритою моделлю на сьогодні в Artificial Analysis Intelligence Index, який агрегує результати 9 різних оцінок для визначення загальної якості моделі ШІ. Бенчмарки OpenRouter поміщають її в ту саму категорію, що й нині заборонена Claude Fable 5.
Апаратне забезпечення, використане для досягнення цього подвигу, є ще однією цікавою частиною історії. GLM-5.2 був навчений на чіпах Huawei Ascend — жодного обладнання Nvidia в ланцюжку. Емад Мостаке, засновник Stability AI, оцінив загальні витрати на навчання приблизно в 25 мільйонів доларів, 80% з яких припадає на пост-тренінг, що робить його надзвичайно дешевим порівняно з аналогами.
Як повідомляв Decrypt раніше цього року, Z.ai вже навчав моделі зображень на серверах Huawei Ascend Atlas без жодного американського чіпа. GLM-5.2 розвиває цю інфраструктуру далі — модель суміші експертів (mixture-of-experts) з 744 мільярдами параметрів зі справжнім вікном контексту на 1 мільйон токенів, що в п'ять разів перевищує ліміт у 200 тисяч для GLM-5.1, та ліцензією MIT, що означає, що жодна урядова директива не може відключити доступ.
Токени — це фрагменти тексту, які модель може читати та генерувати, тоді як параметри — це кількість внутрішніх налаштувань та значень, які визначають, як модель обробляє інформацію та генерує відповіді.
Для розробників вікно контексту є операційною зміною. Навігація по всьому репозиторію, рефакторинг кількох файлів та довгі агентні конвеєри, які раніше вимагали розбиття на частини, тепер стають робочими процесами з одним викликом. Ціни API становлять $1.40 за мільйон вхідних токенів та $4.40 за мільйон вихідних — проти $5 за вхідні та $25 за вихідні у Claude Opus 4.8. План кодування починається приблизно з $18 на місяць і працює безпосередньо в Claude Code, Cline, Kilo Code та більшості популярних агентних середовищ.
Локальне розгортання також технічно можливе. Unsloth AI випустив 2-бітні GGUF квантування, які стискають модель з 1.51 ТБ до 238 ГБ, зберігаючи при цьому ~82% точності.
Однак не варто занадто радіти. Це все ще означає, що для неї потрібно 256 ГБ уніфікованої пам'яті або відповідна комбінація RAM/VRAM — максимальний M4 Ultra Mac Studio або робоча станція з відеокартою середнього класу та 256 ГБ системної RAM з відвантаженням "суміші експертів" (mixture-of-experts). Це все ще багато грошей, але принаймні це те, що ви можете купити та запустити в себе вдома, якщо дійсно цього бажаєте.
Ми провели швидкий тест, попросивши GLM-5.2 створити нашу стандартну гру, що поєднує механіку друку зі шутером. Інтерфейс користувача не був найкрасивішим — інші моделі генерували більш витончені інтерфейси, але досвід був найрізноманітнішим: різні сценарії по хвилях, типи ворогів, що змінювалися, боси, що з'являлися пізніше в грі.
Він генерував більш різноманітні стани гри, ніж будь-що інше, що ми тестували для того ж завдання в налаштуванні "zero-shot".
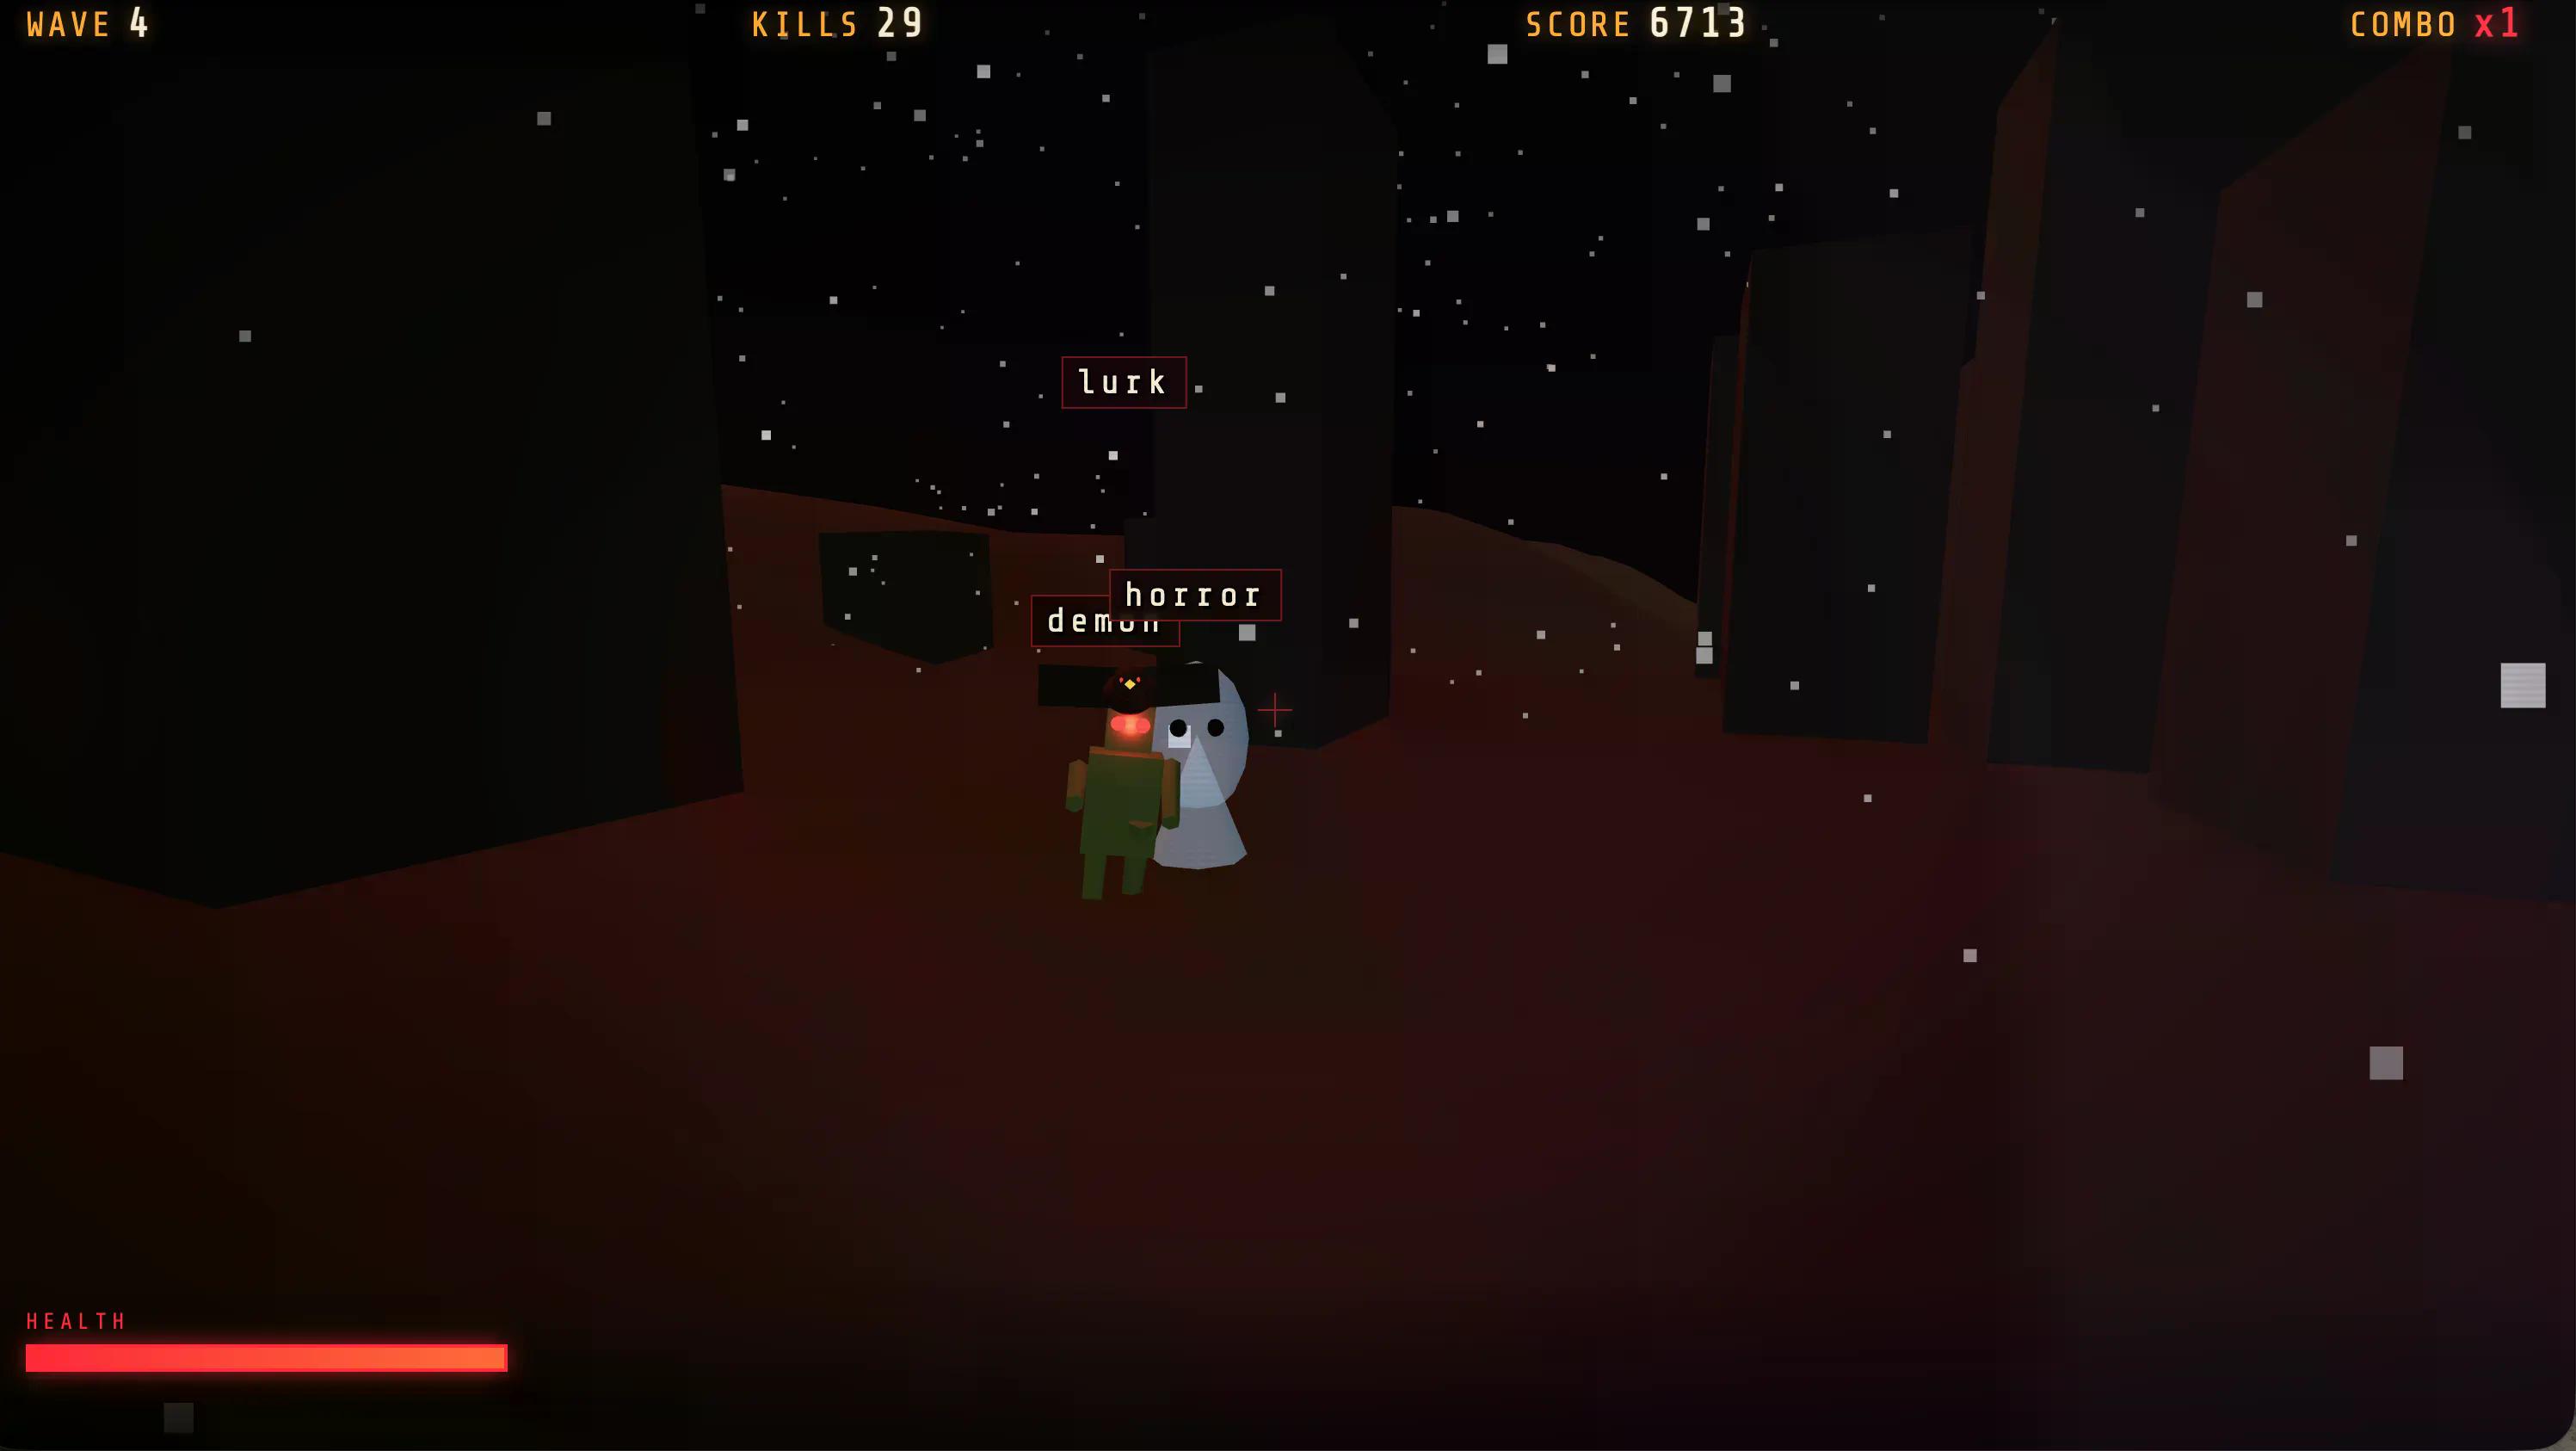
Якщо ви хочете пограти в неї, вона доступна в нашому профілі на Itch.io.
Ця варіативність вказує на те, де GLM-5.2 має найбільший економічний сенс. Для робочих процесів генерації з багатьма спробами та агентних конвеєрів, де різноманітність вихідних даних має більше значення, ніж досконалість, математика на рівнях ціноутворення з відкритим вихідним кодом важко заперечити. Для найскладніших тривалих завдань — SWE-Marathon, де він набирає 13.0 проти 26.0 у Opus 4.8 — розрив до закритого фронтиру все ще реальний і становить 13 пунктів.
Ваги з відкритим вихідним кодом доступні на HuggingFace за ліцензією MIT. Квантовані ваги також доступні на HuggingFace. Передплатники GLM Coding Plan можуть переключитися зараз за допомогою рядка моделі GLM-5.2, і вона також доступна для безкоштовного тестування на z.AI з деякими обмеженнями використання.







