

Шість тижнів. Стільки часу знадобилося Anthropic, щоб перейти від Opus 4.7 до Opus 4.8.
Нова модель швидша та розумніша у бенчмарк-тестах, а також поставляється з набором нових функцій — але ціна не змінилася: це $5 за мільйон вхідних токенів і $25 за мільйон вихідних токенів, як і раніше.
Також є швидкий режим, який працює з тією ж моделлю в 2,5 рази швидше за $10 за вхід і величезні $50 за вихід за мільйон. Anthropic стверджує, що ця ставка тепер утричі дешевша, ніж вартість швидкого режиму на попередніх моделях, що є гарним способом сказати, що раніше вона була набагато дорожчою.
SWE-bench Pro, ймовірно, є найважливішим бенчмарком, за яким варто стежити, щоб мати уявлення про те, наскільки хороша ця модель. Він вимірює, чи може ШІ фактично вирішувати складні багатомовні проблеми програмної інженерії, взяті з реальних баз коду — оцінюється як відсоток вирішених проблем.
У цьому тесті Opus 4.8 досяг 69,2%, порівняно з 64,3% для Opus 4.7. GPT-5.5 від OpenAI набрав 58,6%, а Gemini 3.1 Pro від Google відстав на 54,2%. Для моделі за тією ж ціною це значний стрибок.
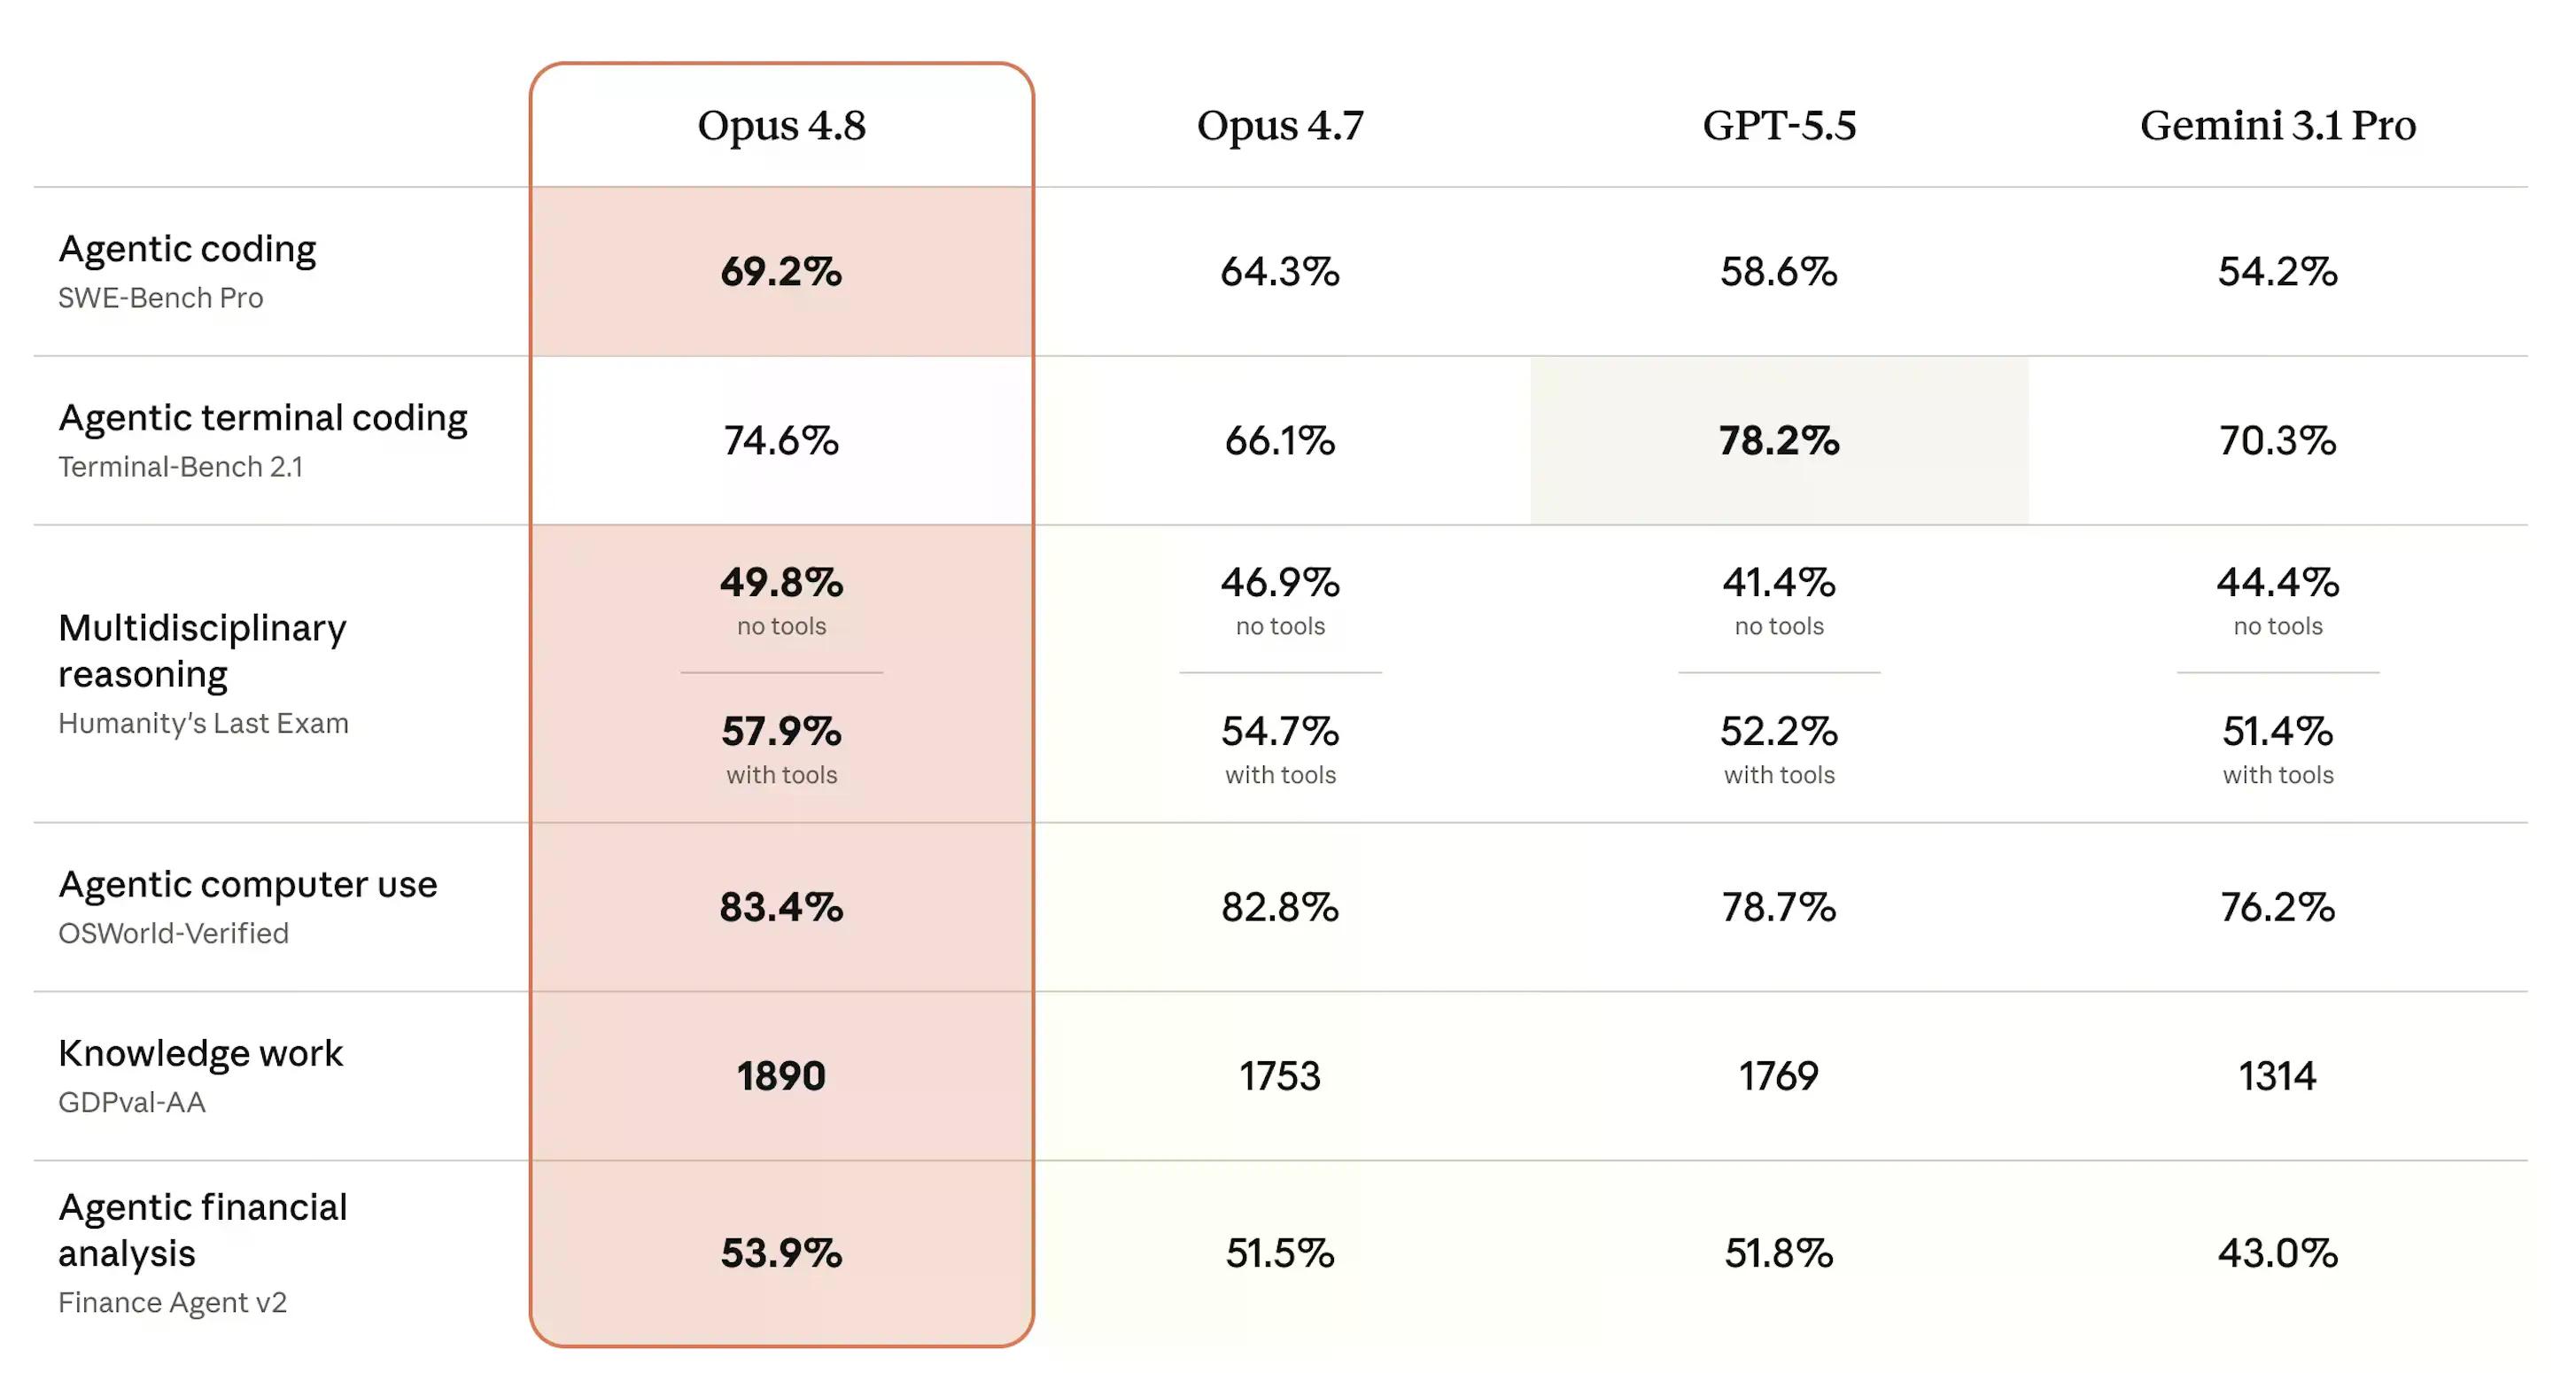
На іспиті «Останній іспит людства» (Humanity's Last Exam) — питання експертного рівня з десятків академічних дисциплін, оцінювані як відсоток правильних відповідей — Opus 4.8 досяг 49,8% без інструментів і 57,9% з ними, випередивши всіх трьох конкурентів. OSWorld-Verified, який тестує завдання реального використання комп’ютера, такі як навігація програмним інтерфейсом, показав 83,4%, трохи перевершивши показник Opus 4.7 у 82,8%.
Єдиний програш: Terminal-Bench 2.1, який вимірює продуктивність ШІ в завданнях командного рядка. GPT-5.5 лідирує з 78,2%, тоді як Opus 4.8 набирає 74,6% — це краще, ніж 66,1% Opus 4.7 і випереджає 70,3% Gemini, але друге місце все ще означає програш.
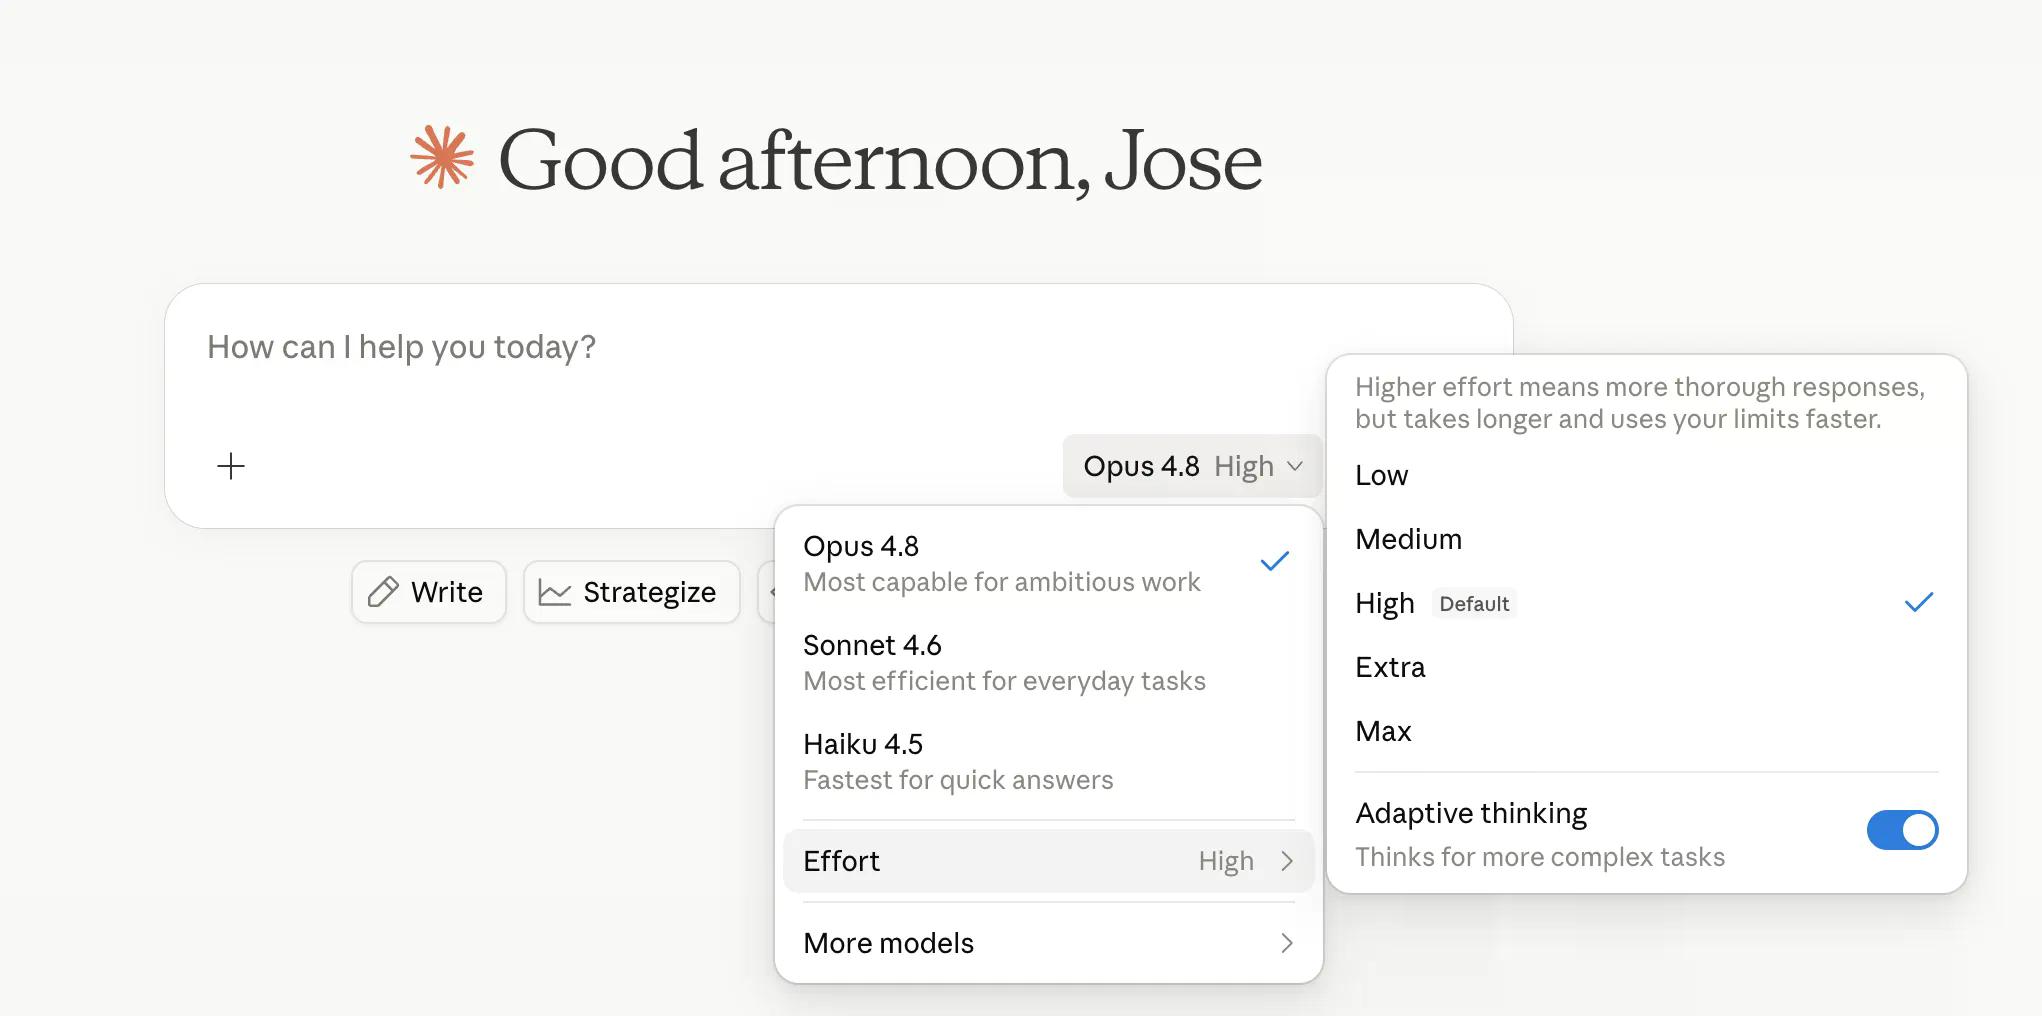
Anthropic тепер дозволяє користувачам контролювати, наскільки інтенсивно модель «мислить». «High» (Високий) є стандартним і добре справляється з більшістю завдань, тоді як «Extra» (Додатковий) — названий «xhigh» всередині Claude Code — витрачає більше обчислювальної потужності для складніших проблем. «Max» (Максимальний) — це найвищий рівень. «Low» (Низький) та «Medium» (Середній) виділяють менше токенів на те саме завдання, заощаджуючи час в обмін на точність.
Контроль зусиль розташований поруч із вибором моделі в claude.ai та Cowork, доступний на всіх тарифах. Anthropic заявляє, що стандартний режим «High» використовує приблизно стільки ж токенів, скільки стандартний режим Opus 4.7, але з кращими результатами — що є або вражаючим інженерним рішенням, або гарним маркетингом, або, ймовірно, і тим, і іншим.
Також важливо пам’ятати, що новий токенізатор Anthropic для Opus використовує більше токенів на завдання. Отже, користувачі Claude неминуче витратять значно більше грошей, щоб виконати завдання, якщо вони оберуть Opus замість Claude Sonnet — менш потужної моделі, але, ймовірно, достатньо хорошої для повсякденних завдань і складних проблем, які не досягають рівня передової науки чи кодування.
Ліміти швидкості в Claude Code також були підвищені, щоб поглинати більші витрати токенів, які створюють налаштування Extra та Max.
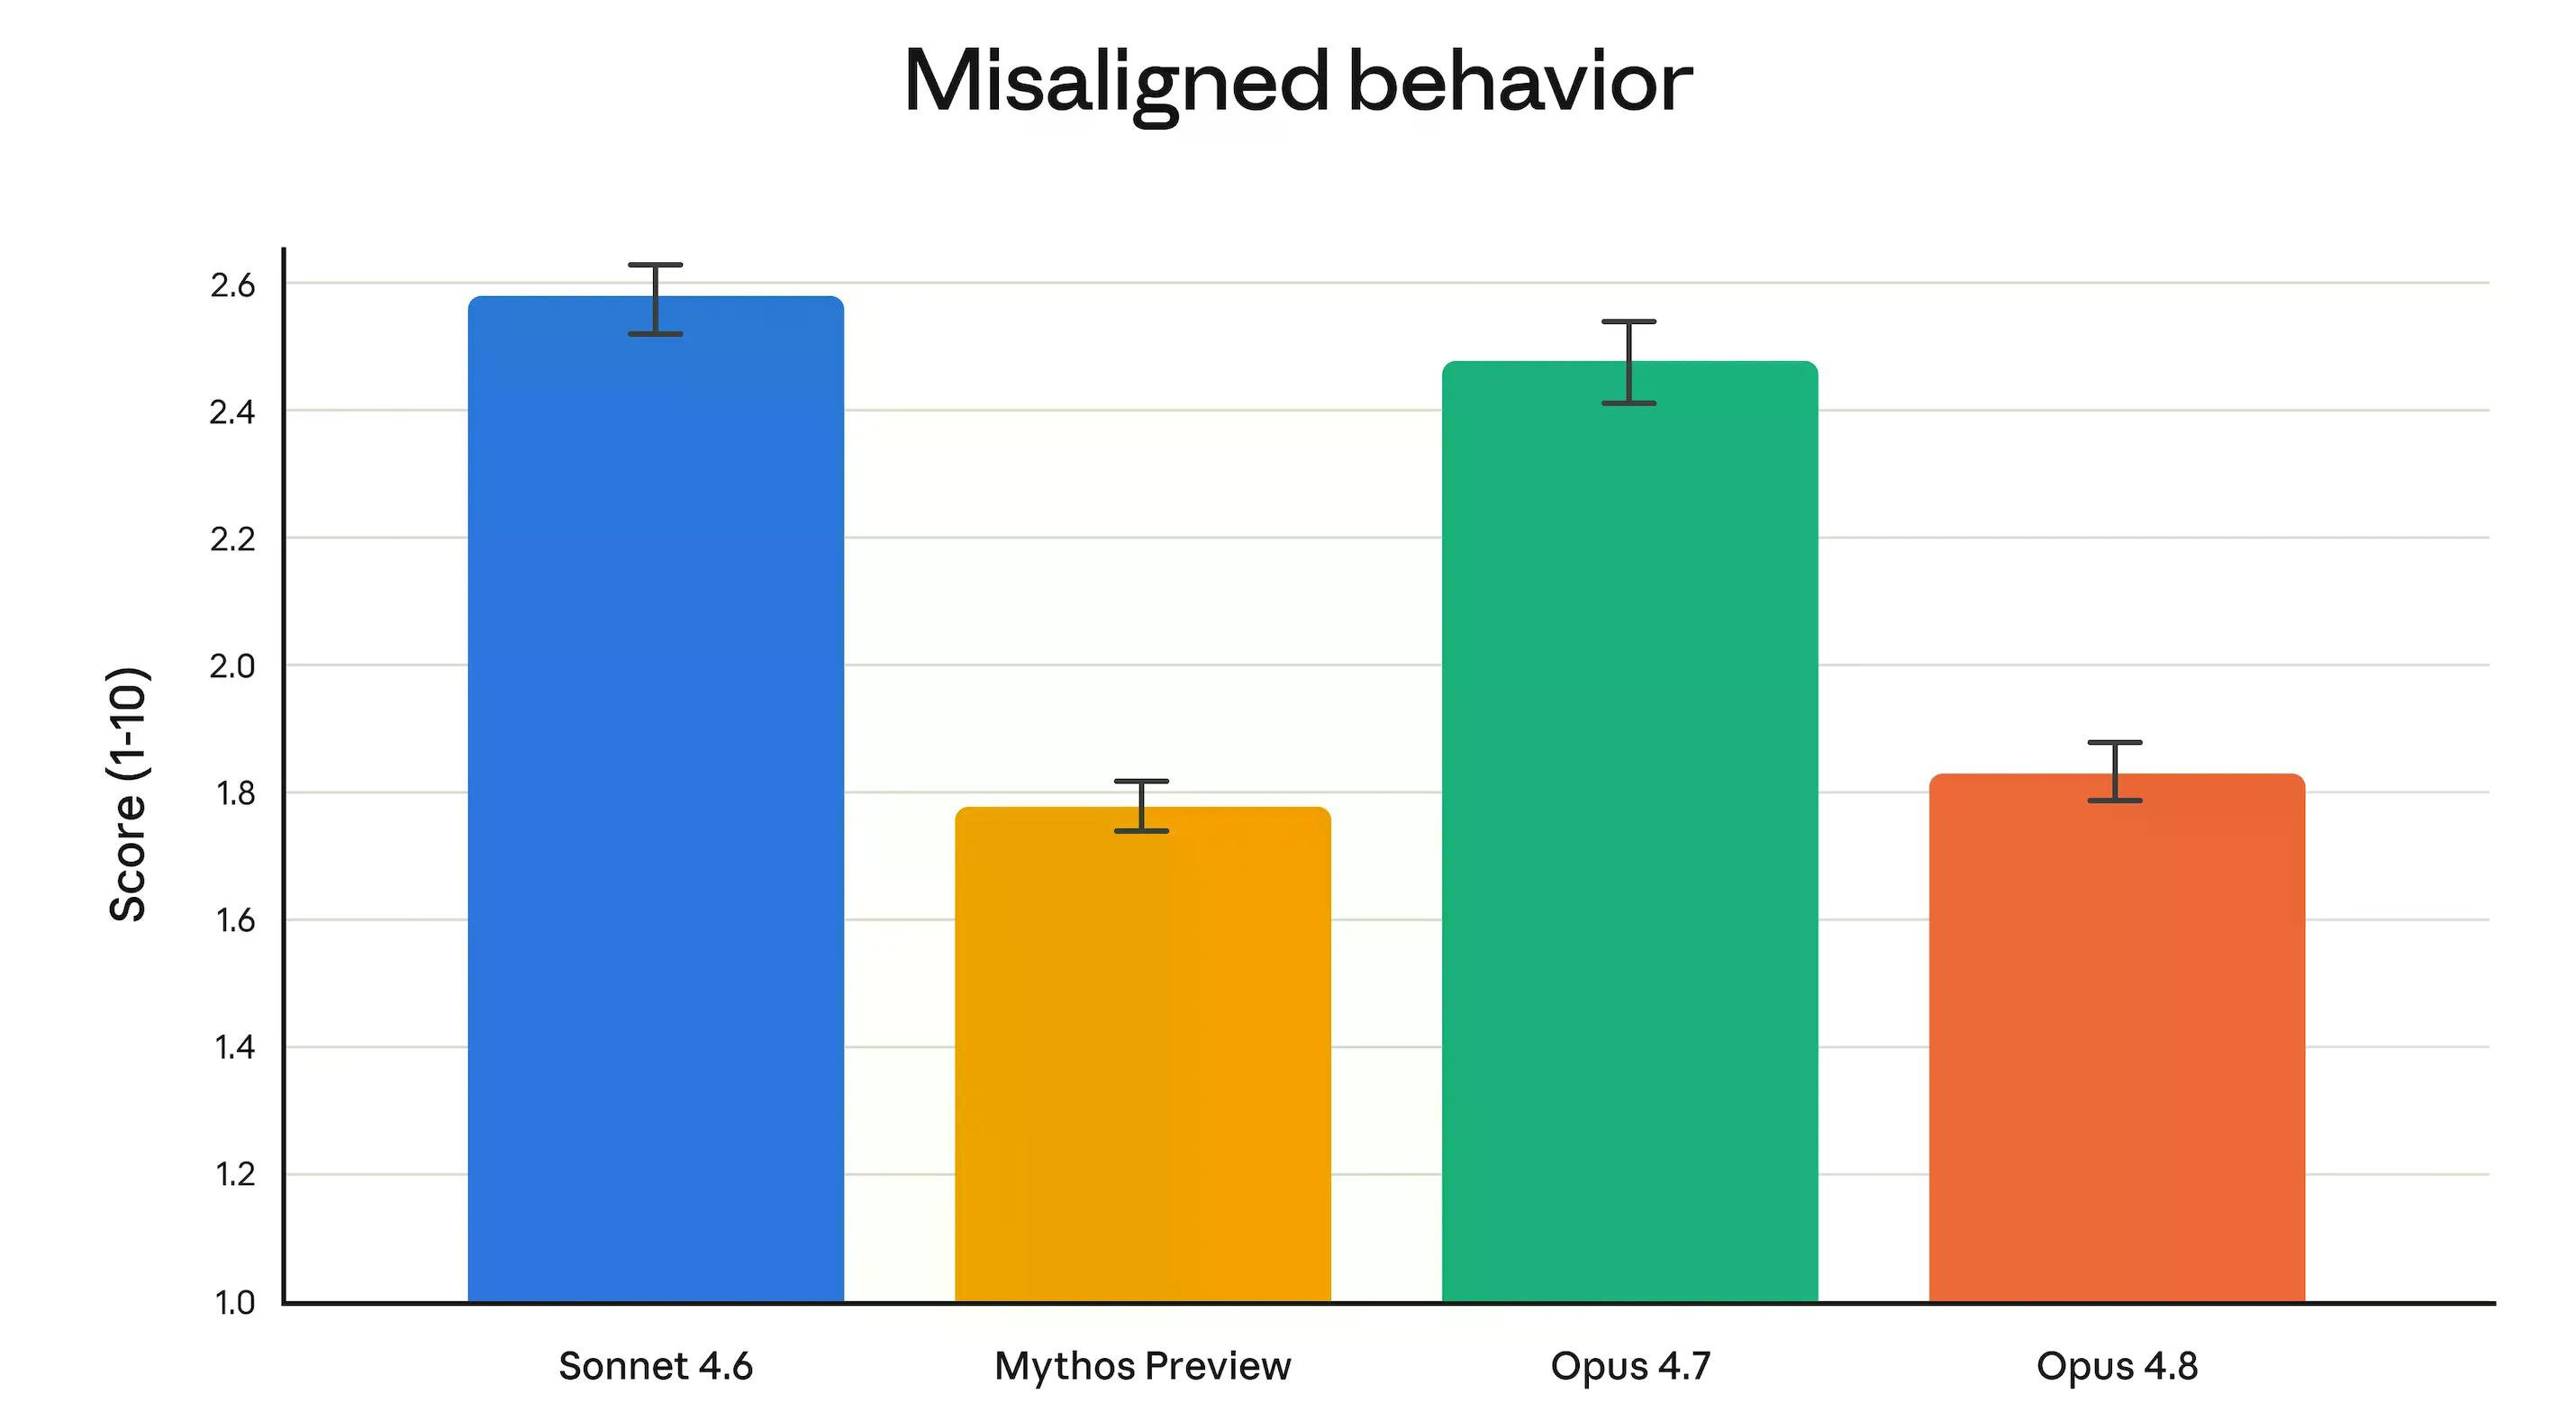
Команда Anthropic з узгодження заявила, що Opus 4.8 «досягає нових висот у наших вимірюваннях просоціальних рис, таких як підтримка автономності користувача та дії в його інтересах». Більш конкретно: показники обману та співпраці зі зловживаннями були значно нижчими, ніж у Opus 4.7, і порівнянними з Claude Mythos Preview — найбільш захищеною моделлю Anthropic.
Opus 4.8 також у чотири рази рідше, ніж 4.7, дозволяє помилкам у власному коді залишатися непоміченими.
Це порівняння з Mythos заслуговує на контекст. Mythos — це модель абсолютно іншого рівня, ніж Opus — Anthropic описує її як «більшу та розумнішу за наші моделі Opus». Наразі вона існує лише як попередній перегляд, доступний невеликій кількості перевірених організацій, що займаються кібербезпекою через Project Glasswing.
Інститут безпеки ШІ Великобританії виявив, що вона може автономно завершити «The Last Ones», 32-етапну симуляцію атаки на корпоративну мережу, яка зазвичай займає у людських «червоних команд» 20 годин. Саме тому вона ще не продається. Anthropic заявляє, що посилення кіберзахисту знаходиться на стадії розробки, і очікує, що моделі класу Mythos стануть доступними для всіх «найближчими тижнями».
Також сьогодні випускається: динамічні робочі процеси в Claude Code, у дослідницькій попередній версії. Ця функція дозволяє Claude писати власні сценарії оркестрації та запускати паралельні під-агенти в одній сесії, перевіряти їхні результати та звітувати — подібно до того, що Hermes робив вже деякий час.
Динамічні робочі процеси доступні для користувачів тарифних планів Enterprise, Team та Max, і Anthropic прямо заявляє, що вони споживають значно більше токенів, ніж стандартна сесія Claude Code.
Ціноутворення Anthropic $5/$25 виглядає дуже по-іншому порівняно з тим, що останнім часом робить Китай.
DeepSeek V4 Pro минулого тижня зробив свою 75% знижку постійною: $0,435 за мільйон вхідних токенів і $0,87 за мільйон вихідних токенів. Xiaomi MiMo V2.5 Pro працює за такими ж тарифами через таких провайдерів, як OpenRouter.
Швидкий режим Anthropic коштує $10 за вхід і $50 за вихід за мільйон — дорожче, ніж сам стандартний Opus 4.8, і приблизно в 57 разів дорожче за вихідний токен, ніж DeepSeek V4 Pro. Корпорації вже витратили мільйони доларів на висновки американських моделей. Сміливо використовуйте Opus, і ваше підприємство може досить швидко досягти мільйонів доларів.
Відповіддю Anthropic на розрив у ціні є якість та безпека. У SWE-bench Pro Opus 4.8 перевершує обидві китайські моделі. Щодо вирівнювання, жодна з них навіть близько не підходить до опублікованих бенчмарків Anthropic.
Ці речі мають значення в виробничих середовищах, де модель, що тихо співпрацює з поганими вхідними даними, є реальним ризиком — регульовані галузі, юридична робота та будь-що, де «здавалося нормальним» не є прийнятним звітом після інциденту. Для всіх інших цей розрив важко ігнорувати.
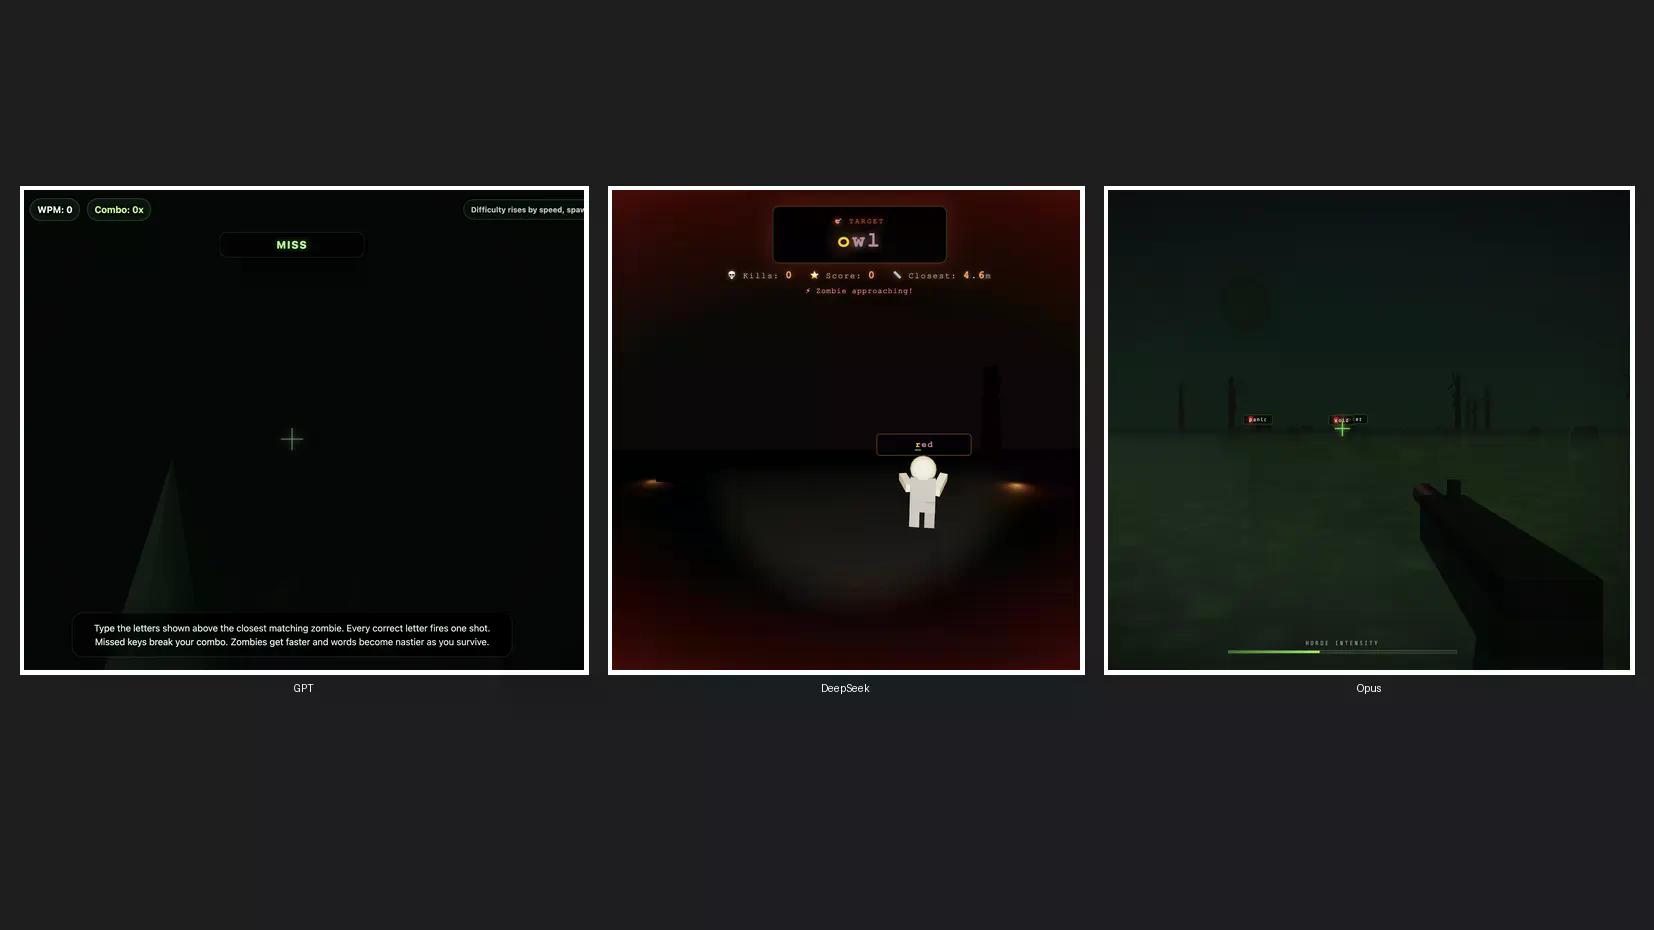
Ми провели швидкий тест кодування, щоб створити 3D гру про зомбі, щоб побачити, як Claude Opus 4.8 порівнюється з ChatGPT і DeepSeek, можливо, його найпопулярнішими конкурентами зі США та Китаю. Ми встановили Opus 4.8 на стандартний високий режим, GPT-5.5 на високий режим зусиль, а DeepSeek V4 Pro на високий режим зусиль — три моделі, один запит, без повторних спроб.
GPT-5.5 завершив першим. У його грі не було візуальних ефектів зомбі та звукових ефектів. Вона була швидкою, безумовно, але повністю проігнорувала завдання.
DeepSeek V4 Pro посів друге місце з рухом миші, справжніми персонажами зомбі, звуковими ефектами, надійною механікою та чистою естетикою. Жодних нарікань.
Opus 4.8 зайняв приблизно втричі більше часу, ніж GPT-5.5, але надав найкращий початковий екран, найкращий дизайн зомбі, найкращу ігрову механіку та пристойні звукові ефекти. Він був найповільнішим, але дав найкращий результат. Проте, цього, мабуть, недостатньо, щоб виправдати його використання замість DeepSeek, враховуючи розрив у вартості.
Усі ігри доступні на нашому профілі Itch.io. GPT-5.5 згенерував Zombie Typing, Opus — Typing Dead, а DeepSeek v4 Pro — гру без назви, яка одразу занурює вас у дію. Назвемо її TypeSeek.
Повний порівняльний огляд з'явиться незабаром. Наразі: Claude Opus 4.8 кодує краще, ніж GPT-5.5 та Opus 4.7 для такого типу завдань, за тією ж ціною, яку Anthropic встановлював з версії 4.7. Розробники, які вже платили $5 за мільйон токенів, щойно отримали кращу модель безкоштовно.







