

Схоже, це кінець інтернет-анонімності в тому вигляді, в якому ми її знали, якщо вірити численним наляканим користувачам соцмереж, які лише сьогодні натрапили на дослідження, пов’язане зі штучним інтелектом.
Наукова робота, яка знову активно розходиться сьогодні в X і Reddit, базується на лютневому дослідженні, а суть висновків лякає анонів по всьому інтернету: ШІ може з’ясувати, хто ви насправді, маючи лише анонімний акаунт.
Стаття має назву "Large-scale online deanonymization with LLMs", і її підготували дослідники з ETH Zurich та групи безпеки ШІ MATS у співпраці з Ніколасом Карліні, дослідником Anthropic — компанії, що стоїть за Claude.
Дослідники стверджують, що великі мовні моделі — AI-системи, які лежать в основі Claude, ChatGPT і Gemini, — можуть читати чиїсь анонімні пости й визначати, хто ця людина в реальному житті. Не зламуючи нічого, а просто читаючи, шукаючи та міркуючи — виконуючи ті самі дії, які ці чатботи вже щодня роблять у мільйоні буденних завдань.
Дослідники створили ШІ, який деанонить будь-який "анонімний" акаунт Reddit менш ніж за хвилину і за $2.
eth zurich та anthropic опублікували моторошну статтю, яка доводить, що "практична анонімність" в інтернеті офіційно мертва.
вони створили повністю автономний AI-конвеєр, який бере ваш… pic.twitter.com/XMeXifhDf3
— Superman (@thesupermannx) 23 вересня 2026 року
«Наші результати показують, що практична невидимість, яка захищала псевдонімних користувачів онлайн, більше не працює, а моделі загроз для онлайн-приватності потрібно переглянути», — йдеться в статті.
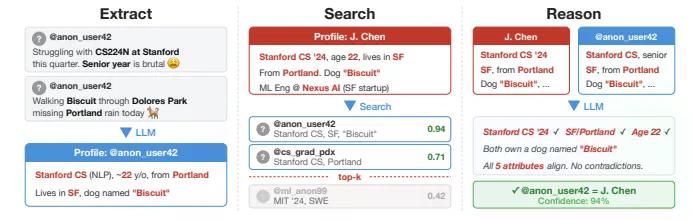
Дослідники розбили атаку на чотири етапи, які вони назвали Extract, Search, Reason і Calibrate.
«Extract» означає передати ШІ чиїсь дописи й попросити його скласти зведений профіль людини: де вона може жити, ким працює, які має хобі, навіть такі дрібниці, як британський правопис або ім’я собаки, згадане мимохідь.
«Search» перетворює це резюме на ембединг — послідовність чисел, яку комп’ютер може використати, щоб миттєво знаходити схожі профілі серед тисяч кандидатів.
«Reason» — це етап, на якому потужніша модель дивиться на кілька найкращих збігів і визначає, який із них справді підходить, звіряючи деталі так, як це зробив би людина-розслідувач, тільки значно швидше.
«Calibrate» змушує ШІ оцінювати власну впевненість, щоб він робив припущення лише тоді, коли достатньо впевнений, а в іншому разі мовчав.
В одному з тестів команда зібрала 338 користувачів переважно псевдонімної платформи Hacker News, які вказали посилання на свій профіль LinkedIn у біо, прибрала все, що їх ідентифікувало, а потім попросила AI-агента встановити, хто вони, використовуючи лише вебпошук. Він правильно назвав 226 із них, тобто 67%, і помилявся приблизно в одному випадку з десяти серед тих відповідей, які фактично дав.
В окремому тесті на стенограмах із власного інтерв’ю-дослідження Anthropic за участі 125 науковців ШІ правильно ідентифікував щонайменше 9 людей лише з того, як вони описували свою роботу.
Справжній висновок тут — це вартість усього процесу. Згідно зі статтею, запуск одного такого пошуку коштує від $1 до $4 у вигляді підписок на AI-сервіси.
Для цього також не потрібні витік даних, злам чи внутрішній доступ. Використовуються ті самі можливості вебпошуку й узагальнення, які вбудовані у звичайні чатботи. Дослідники стверджують, що саме тому це складно заблокувати: немає єдиного перемикача «деанонімізувати цю людину», який можна вимкнути, є лише ланцюжок окремих на вигляд нешкідливих завдань.
Це не перший випадок, коли кілька деталей викривали чиюсь особу. Ще у 2008 році дослідники зламали нібито анонімний датасет Netflix із рейтингами фільмів, зіставивши його з публічними рецензіями на IMDb. Різниця тепер у тому, що ШІ проводить таке зіставлення на безладному, неструктурованому тексті — жартах, коментарях, випадкових згадках — замість акуратних таблиць, і робить це самостійно.
Найстрашніші на перший погляд цифри зі статті мають важливе застереження. Щоб виміряти успіх, дослідникам були потрібні учасники, чию реальну особу вони вже знали, тому вони обрали акаунти, які вже містили посилання на LinkedIn, або ж ділили історію постів однієї людини на дві частини й приховували зв’язок між ними.
Це контрольований сценарій із найкращими можливими умовами, а не доказ того, що будь-який випадковий псевдонімний акаунт уже сьогодні можна зламати в плані деанону.
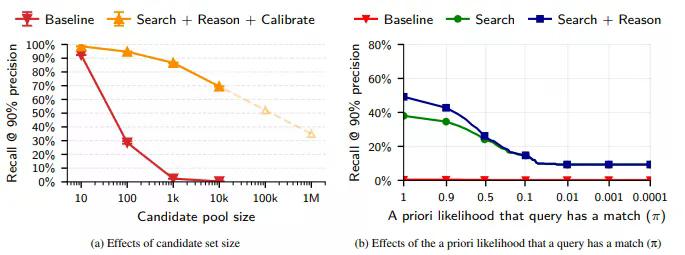
Масштаб також працює проти найстрашніших цифр дослідження. Чим більша копиця можливих кандидатів, тим важче знайти голку. У вибірці з 89 000 кандидатів найсильніший AI-метод все одно виявив лише приблизно половину правильних збігів за точності 90%. Precision означає, наскільки часто його припущення були правильними, а recall — скільки реальних збігів він фактично зміг знайти.
Дослідники також не опублікували свої інструменти, промпти чи будь-які реальні імена, які їм вдалося встановити, а дослідження пройшло етичну перевірку перед релізом. Вони не роздають нікому готовий набір для доксингу. Вони документують можливість, яка, за словами авторів, уже існує в сучасних AI-моделях — незалежно від того, є ця стаття чи ні.
Чому це важливо, навіть якщо ви ніколи не постили в Reddit
Користувачі крипти вже добре знають цей страх. Хвиля доксингів і спроб викрадення після витоку даних Coinbase у 2025 році, серед багатьох інших інцидентів, показала, наскільки швидко злиті персональні дані можуть перетворитися на реальну адресу біля чиїхось дверей.
Деанонімізація за допомогою ШІ — це та сама загроза, тільки без самого витоку: вона працює на основі того, що ви вже опублікували у відкритому доступі, без потреби в зламі чи зливі.
Це також відбувається через кілька місяців після того, як Anthropic повідомила, що підтримувані державою хакери використовували Claude для виконання більшої частини кампанії кібершпигунства самостійно — ще одне нагадування, що дослідження зловживань ШІ випереджають запобіжники, покликані їх стримувати.
Для кожного, хто публікується під псевдонімом через активізм, насильство, сексуальність, імміграційний статус або роботу, де не схвалюють публічні погляди, це означає, що рідне місто, роботодавець і навіть ім’я домашнього улюбленця, розкидані по роках старих коментарів, складаються в унікальний відбиток. Це завжди було можливо — ШІ просто робить це швидше й дешевше.
Але якщо такий тип доксингу справді викликає занепокоєння, рішення — не паніка, а звичка: менше конкретних ідентифікаційних деталей, прив’язаних до одного псевдоніма, а для всього по-справжньому чутливого — інструменти, створені так, щоб узагалі не зберігати ваші дані.






 COIN
