


Majoritatea oamenilor cunosc Xiaomi ca brandul chinezesc de telefoane. Cel care produce scutere electrice ieftine și purificatoare de aer. Nu este tocmai compania de la care te-ai aștepta să bată un record major de viteză în inferența AI într-o dimineață de luni.
Și totuși. Xiaomi a lansat recent MiMo-V2.5-Pro-UltraSpeed, un mod de servire pentru modelul său emblematic cu trilioane de parametri, care atinge peste 1.000 de tokenuri pe secundă — cu vârfuri de aproape 1.200 în demonstrații.
Parametrii sunt ponderile numerice interne care definesc modul în care gândește un model – cu cât ai mai mulți, cu atât modelele pe care le poate recunoaște sunt mai complexe. Tokenurile sunt fragmentele de text pe care modelul le citește și le scrie, reprezentând în medie aproximativ trei sferturi dintr-un cuvânt fiecare.
Xiaomi a realizat acest lucru pe un singur nod comercial cu 8 GPU-uri. Hardware standard, fără cipuri personalizate. Acest lucru schimbă modul în care se calculează cine poate implementa efectiv acest tip de viteză în producție.
Pentru a exprima această cifră în termeni umani: conform Artificial Analysis, GPT-5.5 — cu care majoritatea utilizatorilor ChatGPT interacționează de fapt — se situează la 68. Claude Opus 4.6 atinge aproximativ 71, iar modelul de gamă inferioară, Haiku, ajunge la 98 de tokenuri pe secundă. Gemini Flash atinge 192 de tokenuri pe secundă. MiMo-V2.5-Pro-UltraSpeed face 1.000, pe un model care egalează Opus la benchmark-urile de codare.
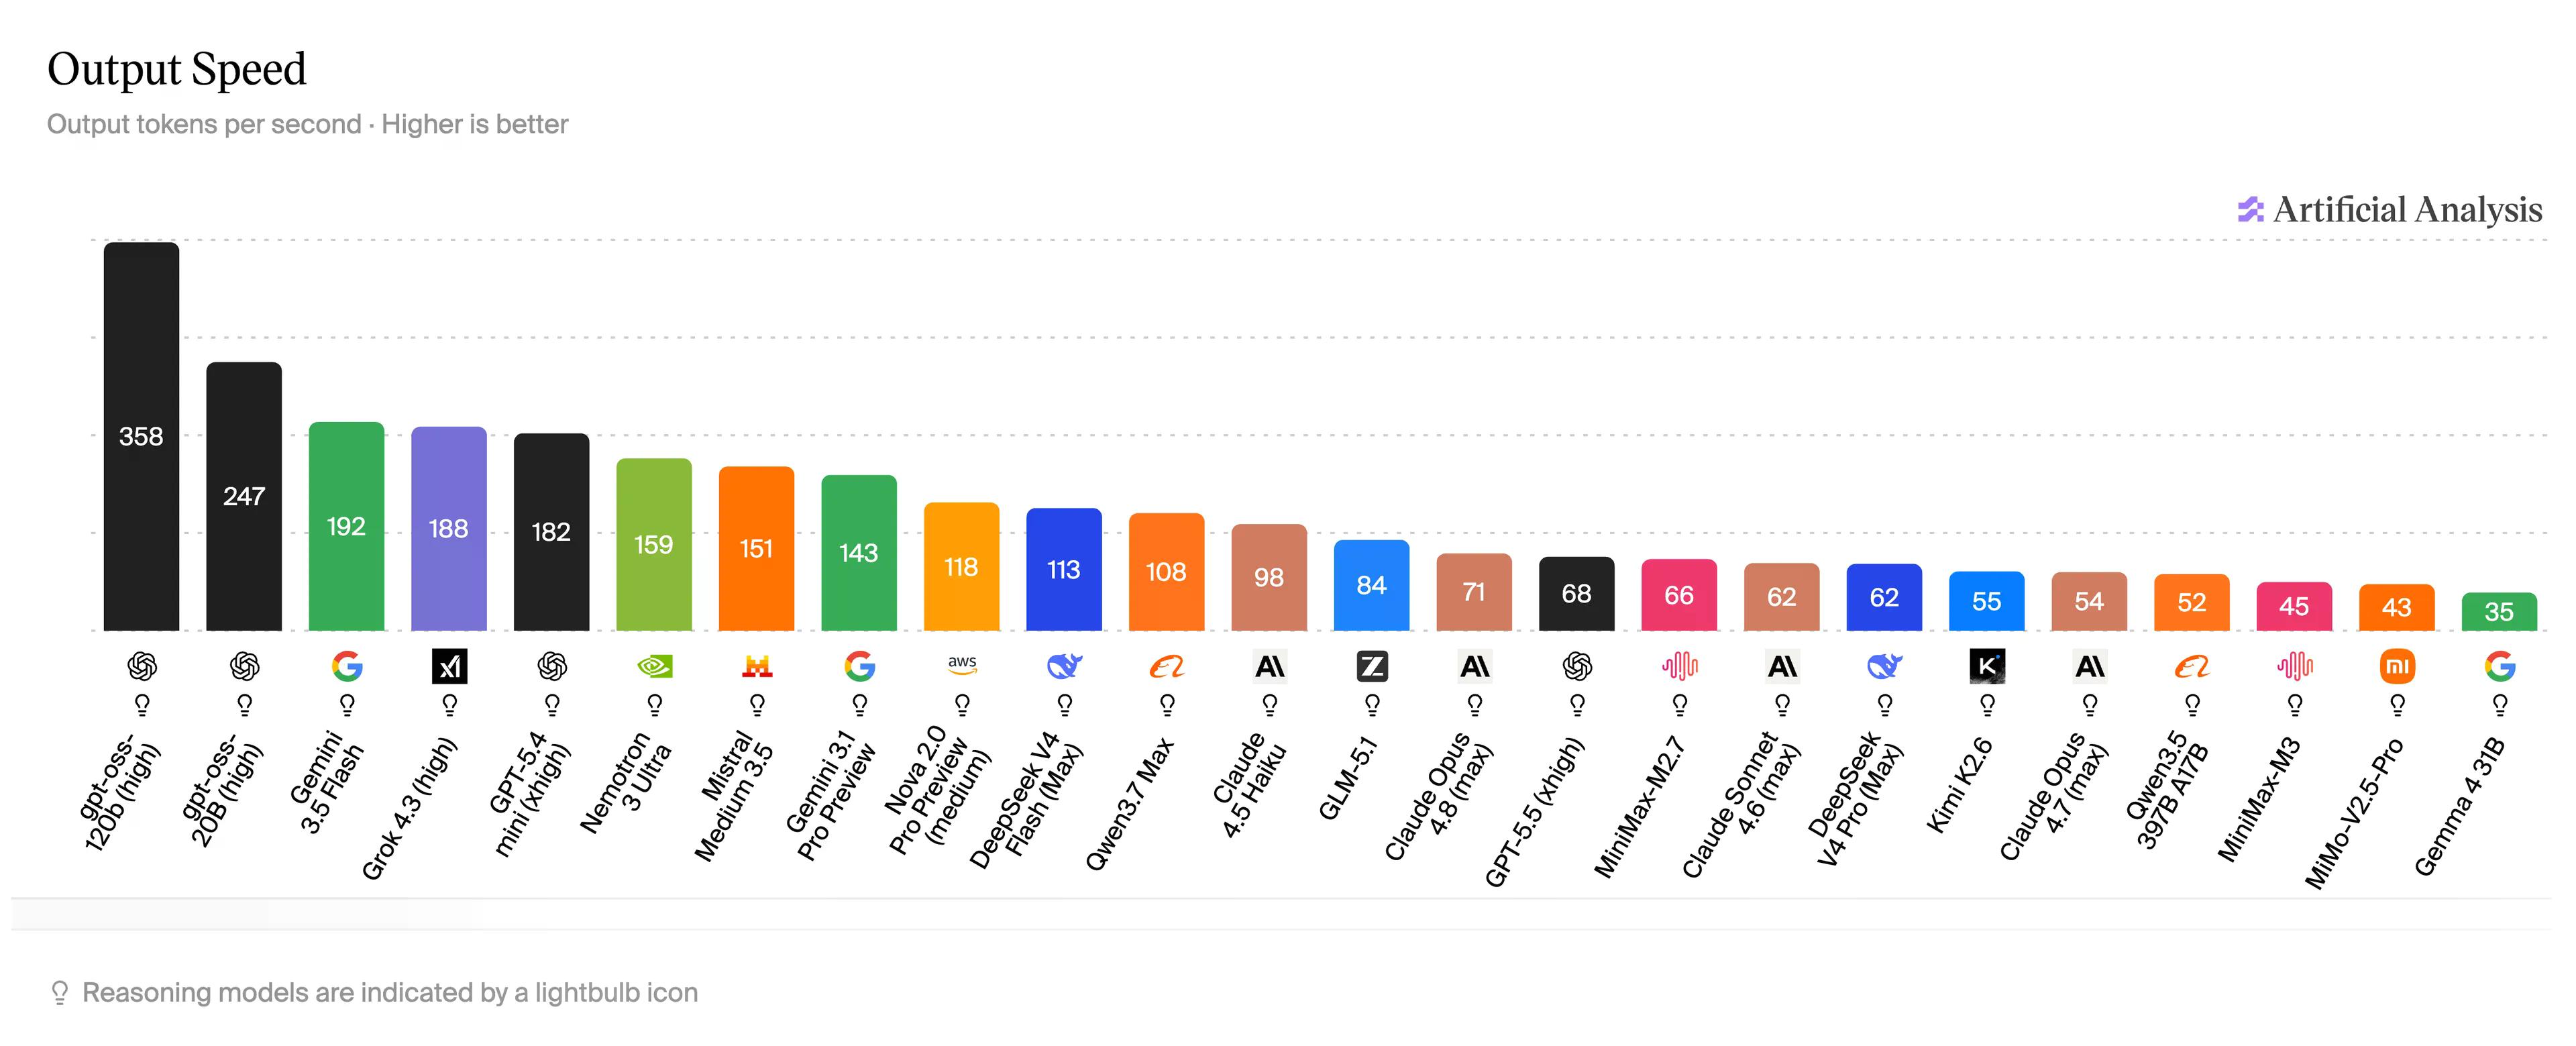
Cerebras și Groq și-au construit afaceri întregi în jurul acestei probleme. Cerebras a proiectat un cip la scară wafer, de dimensiunea unei farfurii, cu 44 GB de memorie pe cip pentru a elimina gâtul de sticlă al lățimii de bandă care încetinește inferența GPU. A atins 969 de tokenuri pe secundă pe modelul Llama 3.1 405B de la Meta — impresionant, dar acesta este un model cu 405 miliarde de parametri, mai puțin de jumătate din dimensiunea MiMo-V2.5-Pro. Arhitectura personalizată a Unității de Procesare a Limbajului (LPU) de la Groq atinge între 300 și 750 de tokenuri pe secundă, în funcție de model.
Niciunul nu rulează pe hardware pe care îl poți închiria de la AWS în această seară.
Xiaomi a reușit acest lucru pe GPU-uri comerciale doar prin software — o combinație de trucuri la nivel de model și un motor de inferență special construit numit TileRT.
Două tehnici asigură viteza. Prima tehnică se numește Cuantizare FP4: în loc să ruleze modelul la precizie numerică completă de 8 biți sau 16 biți, Xiaomi reduce straturile expert — care alcătuiesc majoritatea celor 1 trilion de parametri — la 4 biți. Amprenta de memorie scade, presiunea lățimii de bandă scade, viteza crește. De obicei, dezavantajul este o mică degradare a calității. Soluția Xiaomi este chirurgicală: doar straturile expert sunt comprimate, tot restul rămânând la precizie completă. Cu această abordare, pierderea calității este descrisă ca fiind aproape zero.
A doua tehnică este decodificarea speculativă DFlash. Decodificarea speculativă normală implică un model de tip "draft" mai mic, care ghicește următoarele câteva tokenuri, iar apoi modelul mare le verifică în paralel. DFlash omite complet schițarea secvențială — umple un bloc întreg de poziții mascate într-o singură trecere înainte. În sarcinile de codare, modelul mare acceptă o medie de 6,3 din 8 tokenuri propuse per rundă de verificare. Asta înseamnă șase tokenuri confirmate într-un singur pas, în loc de unul.
TileRT leagă totul. Acesta menține întregul pipeline de calcul rezident continuu în interiorul GPU-ului — fără suprasarcini de lansare per-operator, fără goluri de execuție.
Xiaomi numește această abordare „codesign extrem model-sistem”, iar expresia este precisă: Nicio tehnică singulară nu ajunge la 1.000 de tokenuri pe secundă, dar sinergia dintre toate abordările o face.
MiMo-V2.5-Pro este un model de nivel de avangardă. Am acoperit lansarea V2.5 Pro în aprilie — acesta egalează Claude Opus la majoritatea benchmark-urilor de codare și rulează la aproximativ 0,43 $ intrare / 0,87 $ ieșire per milion de tokenuri. Opus costă 5 $ intrare / 25 $ ieșire per milion de tokenuri.
UltraSpeed accelerează exact modelul MiMo V2.5 Pro, nu o versiune simplificată.
O inferență suficient de rapidă schimbă modul în care poți folosi un model. Poți rula zeci de căi de raționament în paralel, în loc să aștepți un singur răspuns. Detectarea fraudelor, generarea de semnale de tranzacționare, buclele de agenți în timp real – toate acestea au constrângeri stricte de latență pe care 60 de tokenuri pe secundă nu le pot satisface. La 1.000 de tokenuri pe secundă, ele pot.
Xiaomi prețuiește viteza la de 3 ori rata standard MiMo-V2.5-Pro pentru aproximativ de 10 ori mai multă ieșire. Perioada de testare API se desfășoară între 9 și 23 iunie, bazată pe aplicații, cu prioritate acordată dezvoltatorilor de întreprindere și profesioniști. Checkpoint-ul FP4-DFlash este deja open-source pe Hugging Face pentru testare comunitară.








