

DeepSeek a revenit și a apărut la câteva ore după ce OpenAI a lansat GPT-5.5. Coincidență? Poate. Dar dacă ești un laborator chinez de inteligență artificială pe care guvernul SUA a încercat să-l încetinească cu interdicții de export de cipuri în ultimii trei ani, simțul tău de sincronizare devine destul de ascuțit.
Laboratorul din Hangzhou a lansat astăzi versiuni de previzualizare ale DeepSeek-V4-Pro și DeepSeek-V4-Flash, ambele cu greutate deschisă, ambele cu ferestre de context de un milion de tokeni. Aceasta înseamnă că puteți lucra practic cu un context de dimensiunea Trilogiei Stăpânul Inelelor înainte ca modelul să se prăbușească. Ambele sunt, de asemenea, prețuite mult sub orice comparabil din Occident, și ambele sunt gratuite pentru cei capabili să le ruleze local.
Ultima perturbare majoră a DeepSeek—R1 în ianuarie 2025—a șters 600 de miliarde de dolari din capitalizarea de piață a Nvidia într-o singură zi, în timp ce investitorii se întrebau dacă companiile americane aveau nevoie cu adevărat de investiții atât de mari pentru a produce rezultate pe care un mic laborator chinez le-a obținut cu o fracțiune din cost. V4 este un tip diferit de mișcare: mai silențios, mai tehnic și mai concentrat pe eficiență pentru oricine construiește efectiv cu inteligența artificială.
Dintre cele două noi modele, DeepSeek V4-Pro este cel mare, cu 1,6 trilioane de parametri totali. Pentru a pune asta în perspectivă, parametrii sunt „setările” interne sau „celulele cerebrale” pe care un model le folosește pentru a stoca cunoștințe și a recunoaște tipare – cu cât un model are mai mulți parametri, cu atât poate reține teoretic mai multe informații complexe. Aceasta îl face cel mai mare model open-source de pe piața LLM de până acum. Dimensiunea poate părea ridicolă până când aflați că activează doar 49 de miliarde dintre ei per pas de inferență.
Acesta este trucul Mixture-of-Experts pe care DeepSeek l-a perfecționat de la V3: modelul complet stă acolo, dar doar felia relevantă din el se activează pentru orice solicitare dată. Mai multe cunoștințe, aceeași factură de calcul.
„DeepSeek-V4-Pro-Max, modul de efort maxim de raționament al DeepSeek-V4-Pro, avansează semnificativ capacitățile de cunoaștere ale modelelor open-source, stabilindu-se ferm ca cel mai bun model open-source disponibil astăzi”, a scris Deepseek în cardul oficial al modelului de pe Huggingface. „Acesta atinge performanțe de top în benchmark-uri de codare și reduce semnificativ decalajul față de modelele closed-source de top în sarcini de raționament și de tip agent.”
V4-Flash este cel practic: 284 de miliarde de parametri totali, 13 miliarde activi. Este conceput pentru a fi mai rapid, mai ieftin și, conform propriilor benchmark-uri DeepSeek, „atinge performanțe de raționament comparabile cu versiunea Pro atunci când i se acordă un buget de gândire mai mare.”
Ambele suportă un milion de tokeni de context. Asta înseamnă aproximativ 750.000 de cuvinte – aproximativ întreaga trilogie „Stăpânul Inelelor” și chiar mai mult. Și aceasta este o caracteristică standard, nu un nivel premium.
Iată partea tehnică pentru pasionați sau pentru cei interesați de magia care alimentează modelul. Deepseek nu-și ascunde secretele, și totul este disponibil gratuit – lucrarea completă este disponibilă pe Github.
Atenția standard a AI – mecanismul care permite unui model să înțeleagă relațiile dintre cuvinte – are o problemă brutală de scalare. De fiecare dată când dublezi lungimea contextului, costul de calcul se cvadruplează aproximativ. Așadar, rularea unui model pe un milion de tokeni nu este doar de două ori mai scumpă decât 500.000 de tokeni. Este de patru ori mai scumpă. Acesta este motivul pentru care contextul lung a fost istoric o opțiune pe care laboratoarele o adăugau și apoi o limitau în tăcere prin rate limit.
DeepSeek a inventat două noi tipuri de atenție pentru a ocoli această problemă. Primul, Atenția Sparsă Comprimată, funcționează în doi pași. Mai întâi, comprimă grupuri de tokeni – să spunem, fiecare 4 tokeni – într-o singură intrare. Apoi, în loc să se concentreze pe toate aceste intrări comprimate, folosește un „Lightning Indexer” pentru a selecta doar cele mai relevante rezultate pentru o anumită interogare. Modelul tău trece de la a se concentra pe un milion de tokeni la a se concentra pe un set mult mai mic de cele mai importante fragmente, cam ca un bibliotecar care nu citește fiecare carte, dar știe exact ce raft să verifice.
Al doilea, Atenția Puternic Comprimată, este mai agresiv. Acesta colapsează fiecare 128 de tokeni într-o singură intrare – fără selecție rară, doar compresie brutală. Pierzi detaliile fine, dar obții o imagine de ansamblu globală extrem de ieftină. Cele două tipuri de atenție rulează în straturi alternative, astfel încât modelul obține atât detaliile, cât și imaginea de ansamblu.
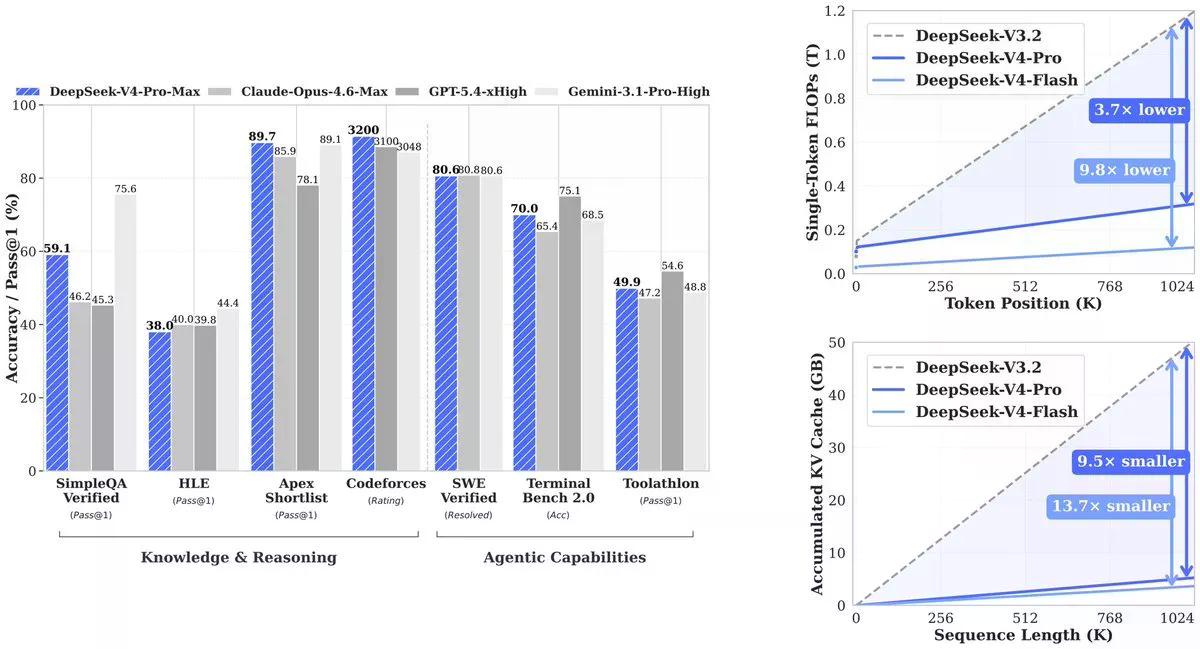
Rezultatul, conform documentului tehnic: La un milion de tokeni, V4-Pro utilizează 27% din puterea de calcul necesară predecesorului său (V3.2). Cache-ul KV – memoria de care modelul are nevoie pentru a urmări contextul – scade la doar 10% din V3.2. V4-Flash împinge acest lucru și mai departe: 10% din calcul, 7% din memorie.
Și acest lucru a permis Deepseek să ofere un preț per token mult mai mic decât concurenții săi, oferind în același timp rezultate comparabile. Pentru a exprima asta în dolari: GPT-5.5 a fost lansat ieri la 5 USD intrare și 30 USD ieșire per milion de tokeni, cu GPT-5.5 Pro la 30 USD per milion de tokeni de intrare și 180 USD per milion de tokeni de ieșire.
Deepseek V4-Pro are un preț de 1,74 USD pentru intrare și 3,48 USD pentru ieșire. V4-Flash costă 0,14 USD pentru intrare și 0,28 USD pentru ieșire. CEO-ul Cline, Saoud Rizwan, a subliniat că, dacă Uber ar fi folosit DeepSeek în loc de Claude, bugetul său AI din 2026 – despre care se spune că ar fi fost suficient pentru patru luni de utilizare – ar fi durat șapte ani.
deepseek v4 is now the cheapest sota model available at 1/20th the cost of opus 4.7.
for perspective, if uber used deepseek instead of claude their 2026 ai budget would have lasted 7 years instead of only 4 months. pic.twitter.com/i9rJZzvRBV
— Saoud Rizwan (@sdrzn) April 24, 2026
DeepSeek face ceva neobișnuit în raportul său tehnic: publică lacunele. Majoritatea lansărilor de modele aleg cu grijă benchmark-urile în care câștigă. DeepSeek a efectuat comparația completă cu GPT-5.4 și Gemini-3.1-Pro, a constatat că raționamentul V4-Pro este în urmă cu aproximativ trei până la șase luni față de aceste modele și a publicat oricum rezultatele.
Unde V4-Pro-Max câștigă de fapt: Codeforces, un benchmark de programare competitivă, evaluat ca șahul uman. V4-Pro a obținut 3.206 puncte, plasându-se în jurul locului 23 printre participanții umani reali la concurs. Pe Apex Shortlist, un set curatat de probleme dificile de matematică și STEM, a înregistrat o rată de promovare de 90.2% față de 85.9% pentru Opus 4.6 și 78.1% pentru GPT-5.4. Pe SWE-Verified, care măsoară dacă un model poate rezolva probleme reale de pe GitHub, extrase din depozite open-source, a obținut 80.6% – egalând Claude Opus 4.6.
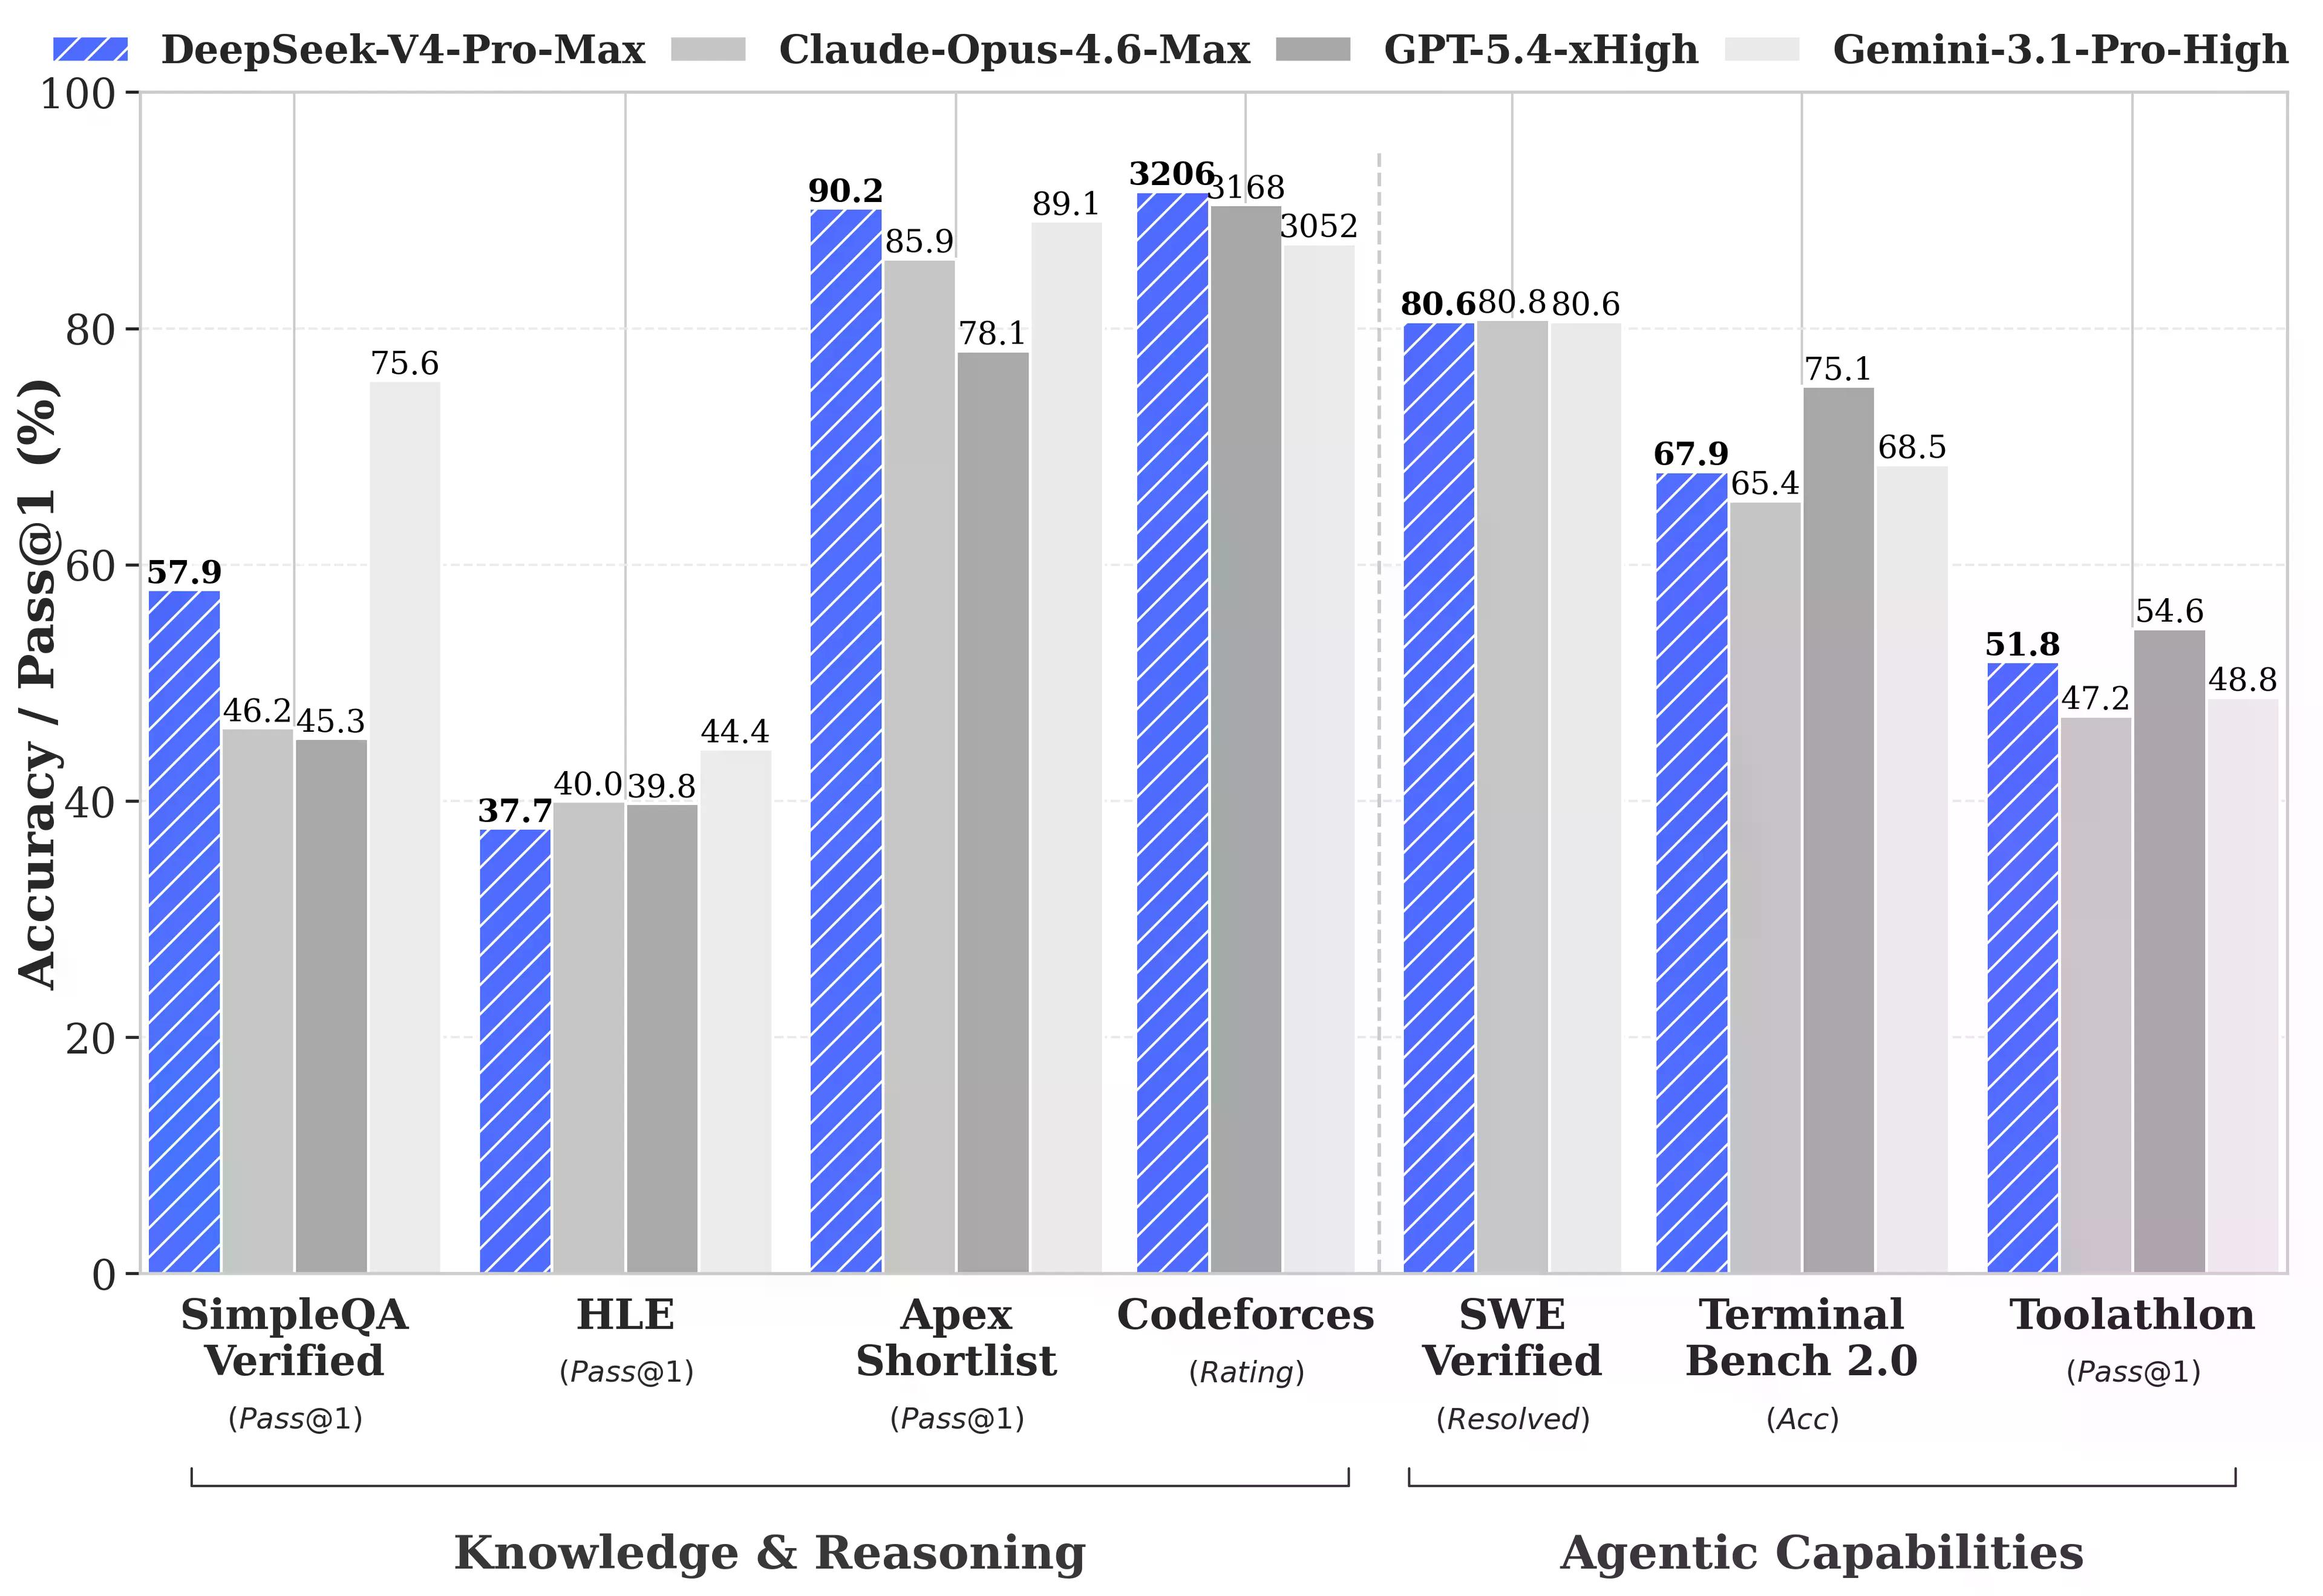
Unde rămâne în urmă: benchmark-ul de multitasking MMLU-Pro (Gemini-3.1-Pro la 91.0% față de V4-Pro la 87.5%), benchmark-ul de cunoștințe de expert GPQA Diamond (Gemini 94.3 față de V4-Pro 90.1) și Humanity's Last Exam, un benchmark la nivel de absolvent unde Gemini-3.1-Pro cu 44.4% încă depășește V4-Pro cu 37.7%.
În ceea ce privește contextul lung, V4-Pro conduce modelele open-source și depășește Gemini-3.1-Pro pe benchmark-ul CorpusQA (un test care simulează analiza documentelor reale la un milion de tokeni), dar pierde în fața Claude Opus 4.6 pe MRCR – un test care măsoară cât de bine un model extrage informații specifice îngropate adânc într-un volum foarte mare de date.
Aspectele legate de agenți sunt cele care fac această lansare interesantă pentru dezvoltatorii care livrează produse.
V4-Pro poate rula în Claude Code, OpenCode și alte instrumente de codare AI. Conform unui sondaj intern al DeepSeek realizat pe 85 de dezvoltatori care au folosit V4-Pro ca agent principal de codare, 52% au declarat că este gata să fie modelul lor implicit, 39% au înclinat spre da, și mai puțin de 9% au spus nu. Angajații interni au declarat că depășește Claude Sonnet și se apropie de Claude Opus 4.5 în sarcinile de codare de tip agent.
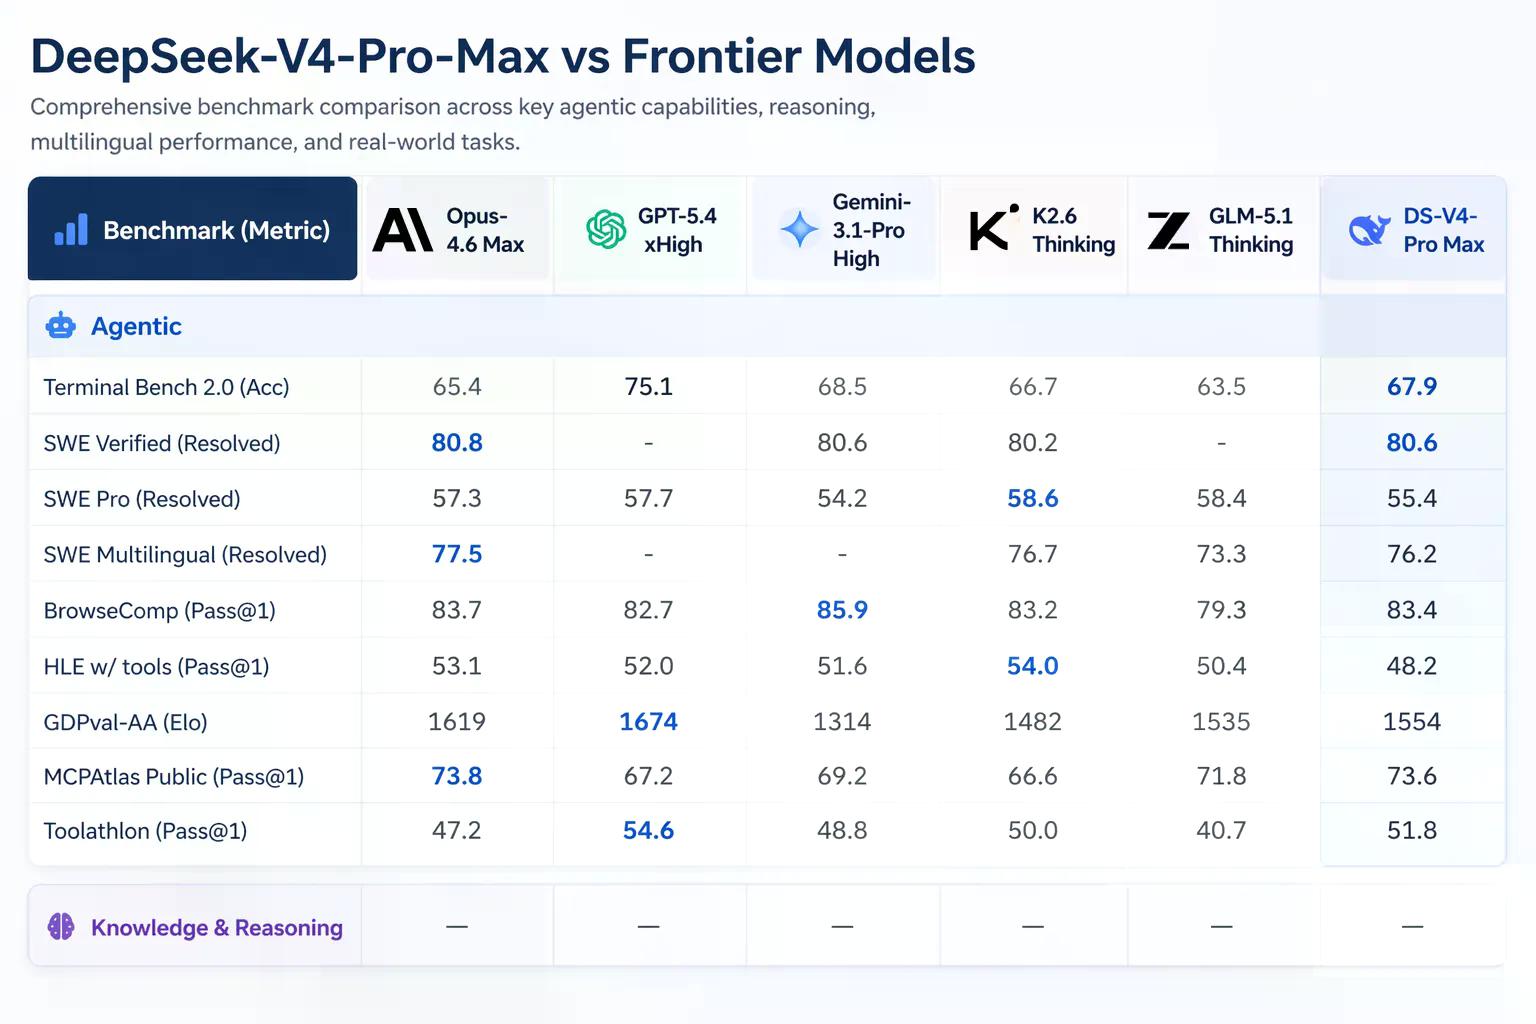
Artificial Analysis, care efectuează evaluări independente ale modelelor AI în sarcini din lumea reală, a clasat V4-Pro pe primul loc printre toate modelele cu greutate deschisă pe GDPval-AA – un benchmark care testează munca de cunoștințe valoroase economic în domenii financiare, juridice și de cercetare, scorat prin Elo. V4-Pro-Max a obținut 1.554 Elo, înaintea GLM-5.1 (1.535) și M2.7 de la MiniMax (1.514). Ca referință, Claude Opus 4.6 obține 1.619 pe același benchmark – încă în față, dar decalajul se reduce.
DeepSeek V4 Pro is the #1 open weights model on GDPval-AA, our agentic real-world work tasks evaluation@deepseek_ai has released V4 Pro (1.6T total / 49B active) and V4 Flash (284B total / 13B active). V4 is DeepSeek's first new size since V3, with all intermediate models… pic.twitter.com/2kJWVrKQjF
— Artificial Analysis (@ArtificialAnlys) April 24, 2026
V4 de la Deepseek introduce, de asemenea, ceva numit „gândire intercalată”. În modelele anterioare, dacă rulați un agent care efectua mai multe apeluri de instrumente – să spunem, căuta pe web, apoi rula un cod, apoi căuta din nou – contextul de raționament al modelului era golit între runde. La fiecare pas nou, modelul trebuia să-și reconstruiască modelul mental de la zero. V4 reține întregul lanț de gândire peste apelurile de instrumente, astfel încât un flux de lucru al agentului în 20 de pași nu suferă de amnezie la jumătatea drumului. Acest lucru contează mai mult decât pare pentru oricine rulează pipeline-uri complexe automatizate.
SUA a restricționat exporturile de cipuri Nvidia de înaltă performanță către China începând cu 2022. Scopul declarat a fost de a încetini dezvoltarea AI chinezească, dar interdicția cipurilor nu a oprit DeepSeek și, în schimb, i-a determinat să inventeze o arhitectură mai eficientă și să-și construiască o aprovizionare internă cu hardware.
DeepSeek nu a lansat V4 într-un vid – spațiul AI a fost plin de activitate în ultima vreme: Anthropic a livrat Claude Opus 4.7 pe 16 aprilie – un model pe care _Decrypt_ l-a testat și l-a găsit puternic în codare și raționament, cu un consum de tokeni remarcabil de mare. Cu o zi înainte, Anthropic lucra și la Claude Mythos, un model de securitate cibernetică pe care spune că nu îl poate lansa public pentru că este prea bun la atacuri autonome de rețea.
Xiaomi a lansat MiMo V2.5 Pro pe 22 aprilie, trecând la capabilități multimodale complete – imagine, audio, video. Costă 1 USD intrare și 3 USD ieșire per milion de tokeni. Se potrivește cu Opus 4.6 în majoritatea benchmark-urilor de codare. Acum trei luni, nimeni nu vorbea despre Xiaomi ca despre o companie AI de frontieră. Acum, lansează modele competitive mai rapid decât majoritatea laboratoarelor occidentale.
GPT-5.5 de la OpenAI a fost lansat ieri, cu costuri care au crescut până la 180 USD per milion de tokeni de ieșire în versiunea Pro. Acesta depășește V4-Pro pe Terminal Bench 2.0 (82.7% vs 70.0%), care testează fluxurile de lucru complexe ale agenților de linie de comandă. Dar costă considerabil mai mult decât V4-Pro pentru sarcini echivalente. În aceeași zi, Tencent a lansat Hy3, un alt model de ultimă generație axat pe eficiență.
Deci, cu atâtea modele noi disponibile, întrebarea pe care dezvoltatorii o pun de fapt este: Când merită prețul premium?
Pentru întreprinderi, matematica s-ar putea să se fi schimbat. Un model care conduce benchmark-urile open-source la 1,74 USD per milion de tokeni de intrare înseamnă că procesarea documentelor la scară largă, revizuirea legală sau pipeline-urile de generare de cod care erau scumpe acum șase luni sunt acum mult mai ieftine. Contextul de un milion de tokeni înseamnă că puteți alimenta baze de cod întregi sau dosare de reglementare într-o singură cerere, în loc să le împărțiți în mai multe apeluri.
Pe lângă aceasta, natura sa open-source înseamnă că nu numai că poate fi rulat gratuit pe hardware local, dar poate fi și personalizat și îmbunătățit în funcție de nevoile și cazurile de utilizare ale companiei.
Pentru dezvoltatori și constructori individuali, V4-Flash este cel de urmărit. La 0,14 USD intrare și 0,28 USD ieșire, este mai ieftin decât modelele considerate opțiuni economice acum un an – și gestionează majoritatea sarcinilor pe care le gestionează versiunea Pro. Punctele finale existente deepseek-chat și deepseek-reasoner de la DeepSeek rutează deja către V4-Flash în modurile non-thinking și thinking, respectiv, deci dacă utilizați API-ul, îl folosiți deja.
Modelele sunt text-only deocamdată. DeepSeek a declarat că lucrează la capabilități multimodale, ceea ce înseamnă că alte laboratoare mari, de la Xiaomi la OpenAI, încă au acel avantaj. Ambele modele sunt licențiate MIT și sunt disponibile astăzi pe Hugging Face. Punctele finale vechi deepseek-chat și deepseek-reasoner se retrag pe 24 iulie 2026.








