


Z.ai a lansat GLM-5.2 pe 16 iunie, promițând performanțe de top, depășind modelul său deja avansat GLM 5.1.
Laboratorul cu sediul în Beijing, care se află pe Lista de Entități a SUA din ianuarie 2025, pare să beneficieze de îngrijorările tot mai mari cu privire la abordarea Americii față de AI. În ultima săptămână, interdicția pe Anthropic Fable și lansarea acestui nou model au contribuit la creșterea acțiunilor zAI cu 90%, ducându-le la un nou maxim istoric.
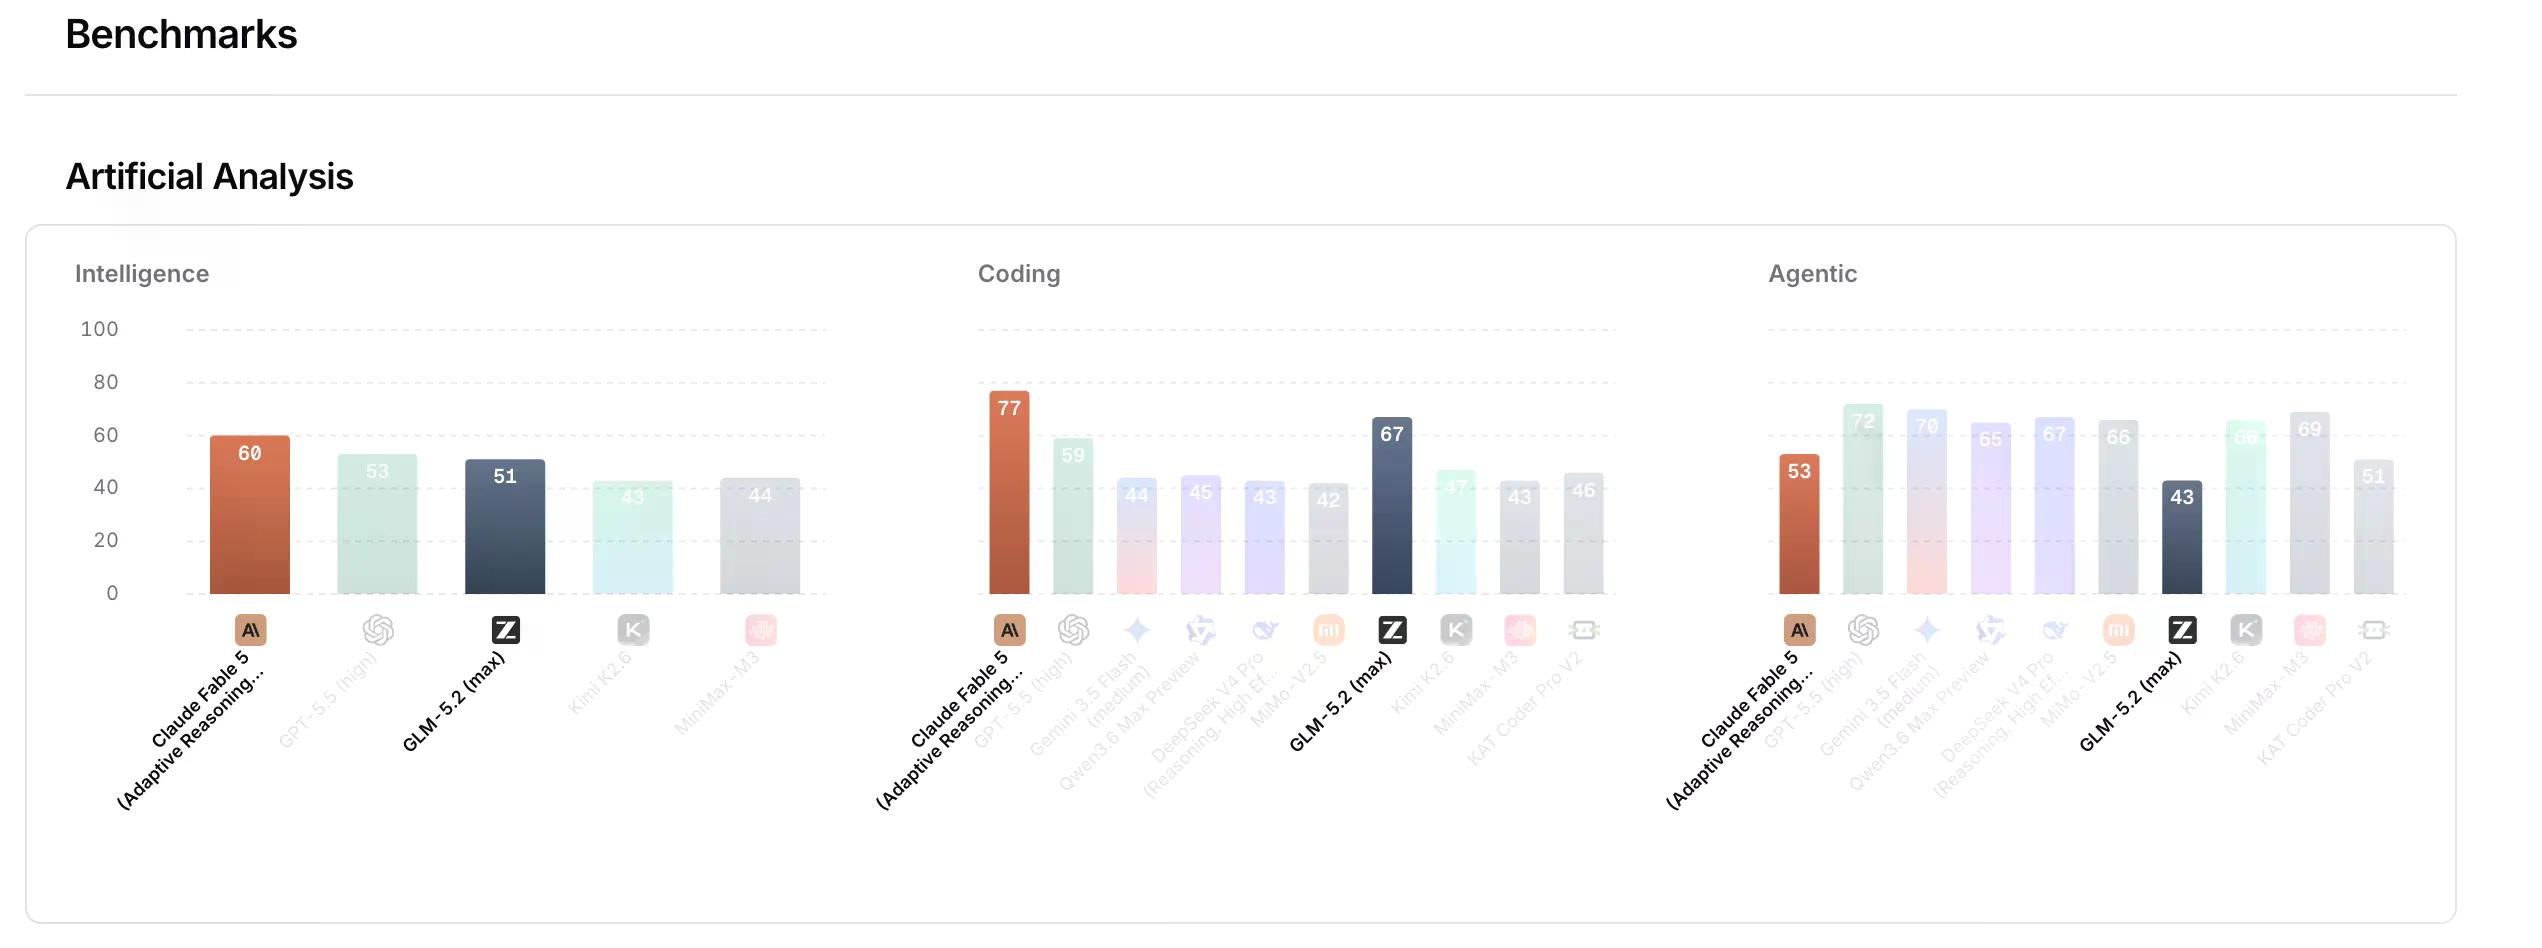
GLM 5.2 are cifre care susțin entuziasmul.
La FrontierSWE—un benchmark care evaluează dacă un agent AI poate finaliza proiecte tehnice deschise, măsurate în ore, acoperind optimizarea sistemelor, construcția de cod la scară largă și cercetarea ML aplicată, punctat prin rata de dominanță—GLM-5.2 a atins 74,4 față de 75,1 al Claude Opus 4.8. A depășit GPT-5.5 cu 72,6. La SWE-bench Pro, care testează rezolvarea autonomă a problemelor reale de pe GitHub, punctată ca rată de promovabilitate, GLM-5.2 a obținut 62,1 față de 58,6 al GPT-5.5—și a depășit predecesorul său GLM-5.1, care avea 58,4, la o marjă largă.
Saltul de calitate îl face cel mai bun model open-source de până acum în Indicele de Inteligență al Analizei Artificiale, care cumulează rezultatele a 9 scoruri diferite pentru a evalua calitatea generală a unui model AI. Benchmark-urile OpenRouter îl plasează în aceeași categorie cu Claude Fable 5, acum interzis.
Hardware-ul folosit pentru a realiza această performanță este o altă parte interesantă a poveștii. GLM-5.2 a fost antrenat pe cipuri Huawei Ascend—niciun hardware Nvidia implicat în întregul proces. Emad Mostaque, fondatorul Stability AI, a estimat costurile totale de antrenament la aproximativ 25 de milioane de dolari, 80% din această sumă fiind pentru post-antrenament, ceea ce l-ar face extrem de ieftin în comparație cu omologii săi.
Așa cum a raportat *Decrypt la începutul acestui an*, Z.ai antrena deja modele de imagini pe serverele Huawei Ascend Atlas fără niciun cip american. GLM-5.2 extinde această infrastructură—un model mixture-of-experts cu 744 de miliarde de parametri, cu o fereastră de context autentică de 1 milion de tokenuri, de cinci ori limita de 200K a GLM-5.1, și o licență MIT care înseamnă că nicio directivă guvernamentală nu poate schimba accesul.
Token-urile sunt fragmentele de text pe care un model le poate citi și genera, în timp ce Parametrii sunt numărul de setări interne și valori care determină modul în care un model procesează informațiile și generează răspunsuri.
Pentru dezvoltatori, fereastra de context este schimbarea operațională. Navigarea completă a depozitului, refactorizările multi-fișier și fluxurile de lucru agențiale lungi care anterior necesitau fragmentarea devin fluxuri de lucru cu un singur apel. Prețurile API sunt de 1,40 USD per milion de tokenuri de intrare și 4,40 USD per milion de tokenuri de ieșire—față de 5 USD de intrare și 25 USD de ieșire la Claude Opus 4.8. Planul de Codare începe de la aproximativ 18 USD pe lună și funcționează direct în Claude Code, Cline, Kilo Code și majoritatea mediilor agențiale populare.
Implementarea locală este, de asemenea, tehnic posibilă. Unsloth AI a lansat cuantizări GGUF pe 2 biți care comprimă modelul de la 1,51TB la 238GB, păstrând în același timp o precizie de aproximativ 82%.
Totuși, nu vă entuziasmați prea mult. Asta înseamnă că necesită 256GB de memorie unificată sau o combinație RAM/VRAM potrivită—un Mac Studio M4 Ultra maximizat sau o stație de lucru cu un GPU de gamă medie și 256GB de RAM de sistem cu descărcare mixture-of-experts. Este încă mult de bani, dar măcar este ceva ce puteți cumpăra și rula acasă dacă chiar doriți.
Am făcut un test rapid, cerând GLM-5.2 să construiască jocul nostru standard care combină mecanici de tastare cu un shooter. Interfața de utilizator nu era cea mai frumoasă—alte modele au generat interfețe cu un aspect mai rafinat, dar experiența a fost cea mai variată: scenarii diferite pe parcursul valurilor, tipuri de inamici care se schimbau, șefi apărând mai târziu în joc.
A generat stări de joc mai diverse decât orice altceva am testat pentru aceeași sarcină într-o configurare zero-shot.
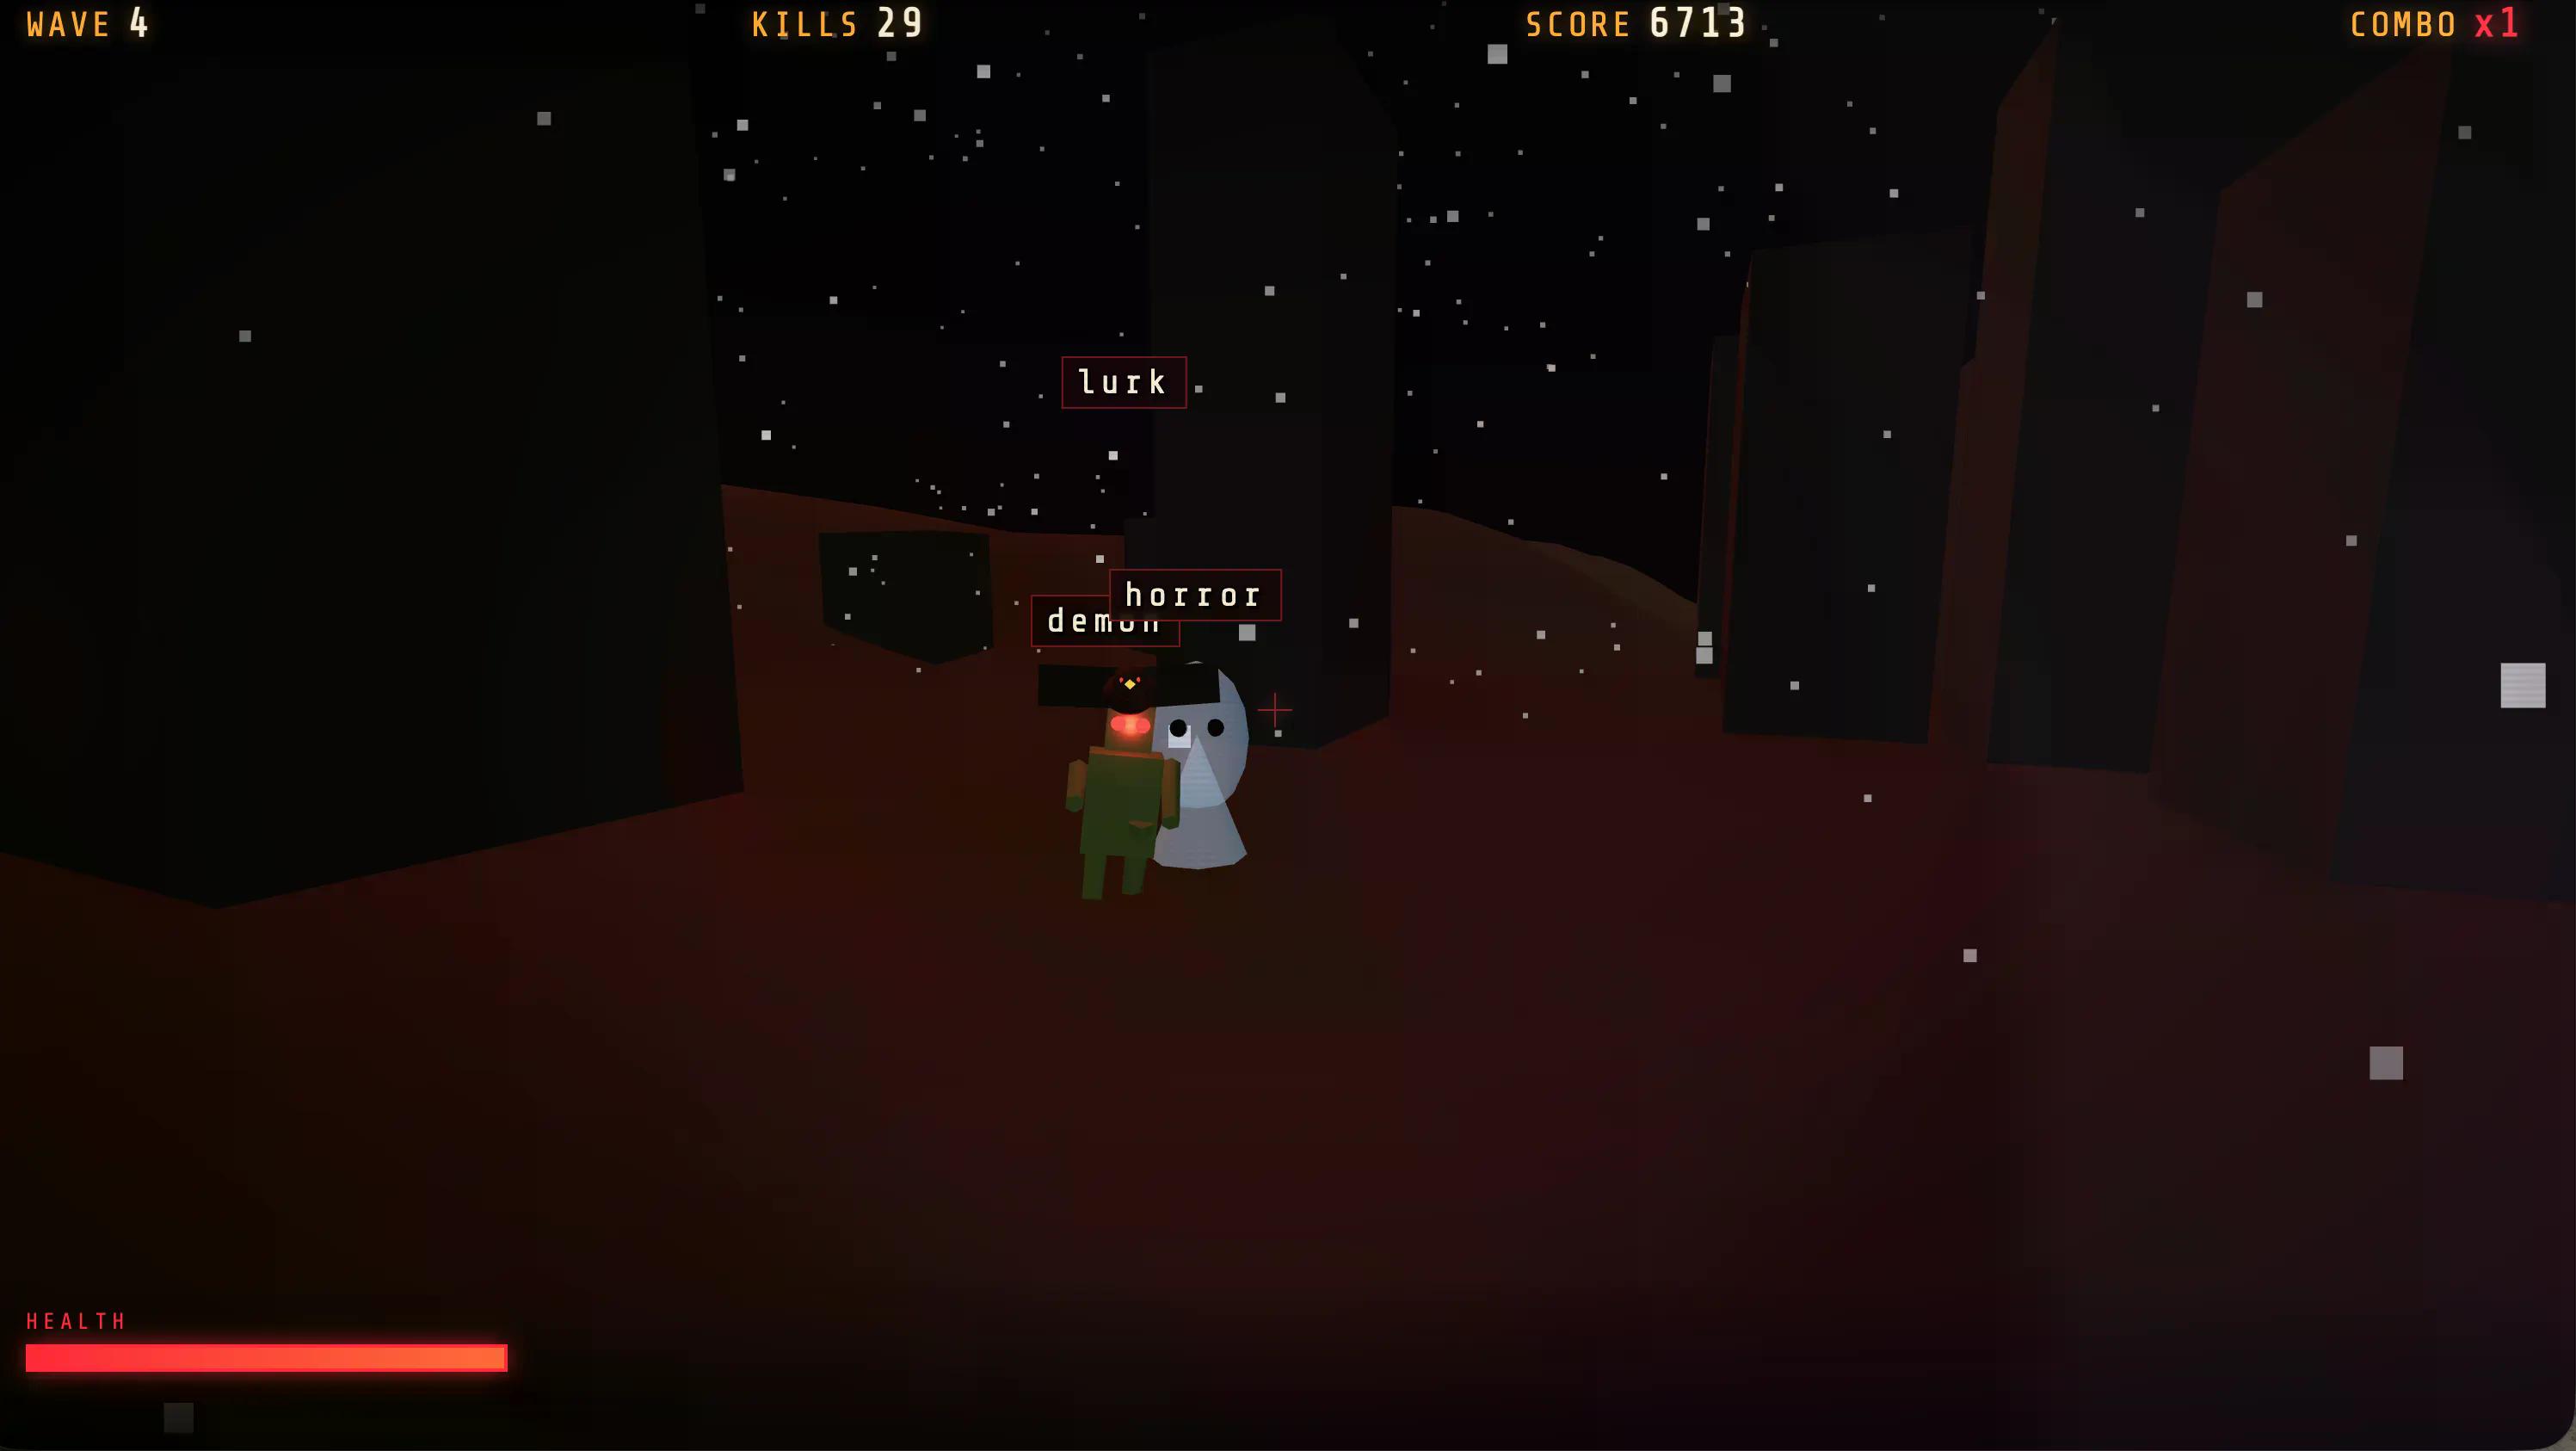
Dacă doriți să-l jucați, este disponibil acum pe profilul nostru Itch.io.
Această variație indică unde GLM-5.2 are cel mai mult sens economic. Pentru fluxurile de lucru de generare multi-shot și conductele agențiale unde diversitatea rezultatelor contează mai mult decât rafinamentul, matematica la nivelurile de prețuri open-source este greu de contestat. Pentru cele mai dificile sarcini susținute—SWE-Marathon, unde obține 13,0 față de 26,0 al Opus 4.8—decalajul față de frontiera închisă este încă real și de 13 puncte.
Ponderile open-source sunt disponibile pe HuggingFace sub licența MIT. Ponderile cuantificate sunt, de asemenea, disponibile pe HuggingFace. Abonații GLM Coding Plan pot trece acum la modelul cu șirul GLM-5.2 și este, de asemenea, disponibil pentru testare gratuită pe z.AI cu anumite restricții de utilizare.







