


Șase săptămâni. Atât i-a luat Anthropic să treacă de la Opus 4.7 la Opus 4.8.
Noul model este mai rapid și mai inteligent la testele benchmark și vine cu o suită de funcționalități noi – dar prețul nu s-a modificat: este de 5 dolari pe milion de tokeni de intrare și 25 de dolari pe milion de tokeni de ieșire, la fel ca înainte.
Există, de asemenea, un mod rapid care rulează același model de 2,5 ori mai repede, pentru 10 dolari de intrare și nu mai puțin de 50 de dolari de ieșire pe milion. Anthropic spune că această rată este acum de trei ori mai ieftină decât ceea ce costa modul rapid la modelele anterioare, ceea ce este un mod elegant de a spune că înainte era mult mai scump.
SWE-bench Pro este probabil cel mai important benchmark de urmărit pentru a vă face o idee despre cât de bun este acest model. Măsoară dacă o inteligență artificială poate rezolva probleme de inginerie software complexe, multilingve, extrase din baze de cod reale de producție – scorul fiind procentul de probleme rezolvate cu succes.
La acest test, Opus 4.8 a atins 69,2%, în creștere de la 64,3% pentru Opus 4.7. GPT-5.5 de la OpenAI a obținut 58,6%, iar Gemini 3.1 Pro de la Google a rămas în urmă cu 54,2%. Pentru un model la același nivel de preț, aceasta este o creștere semnificativă.
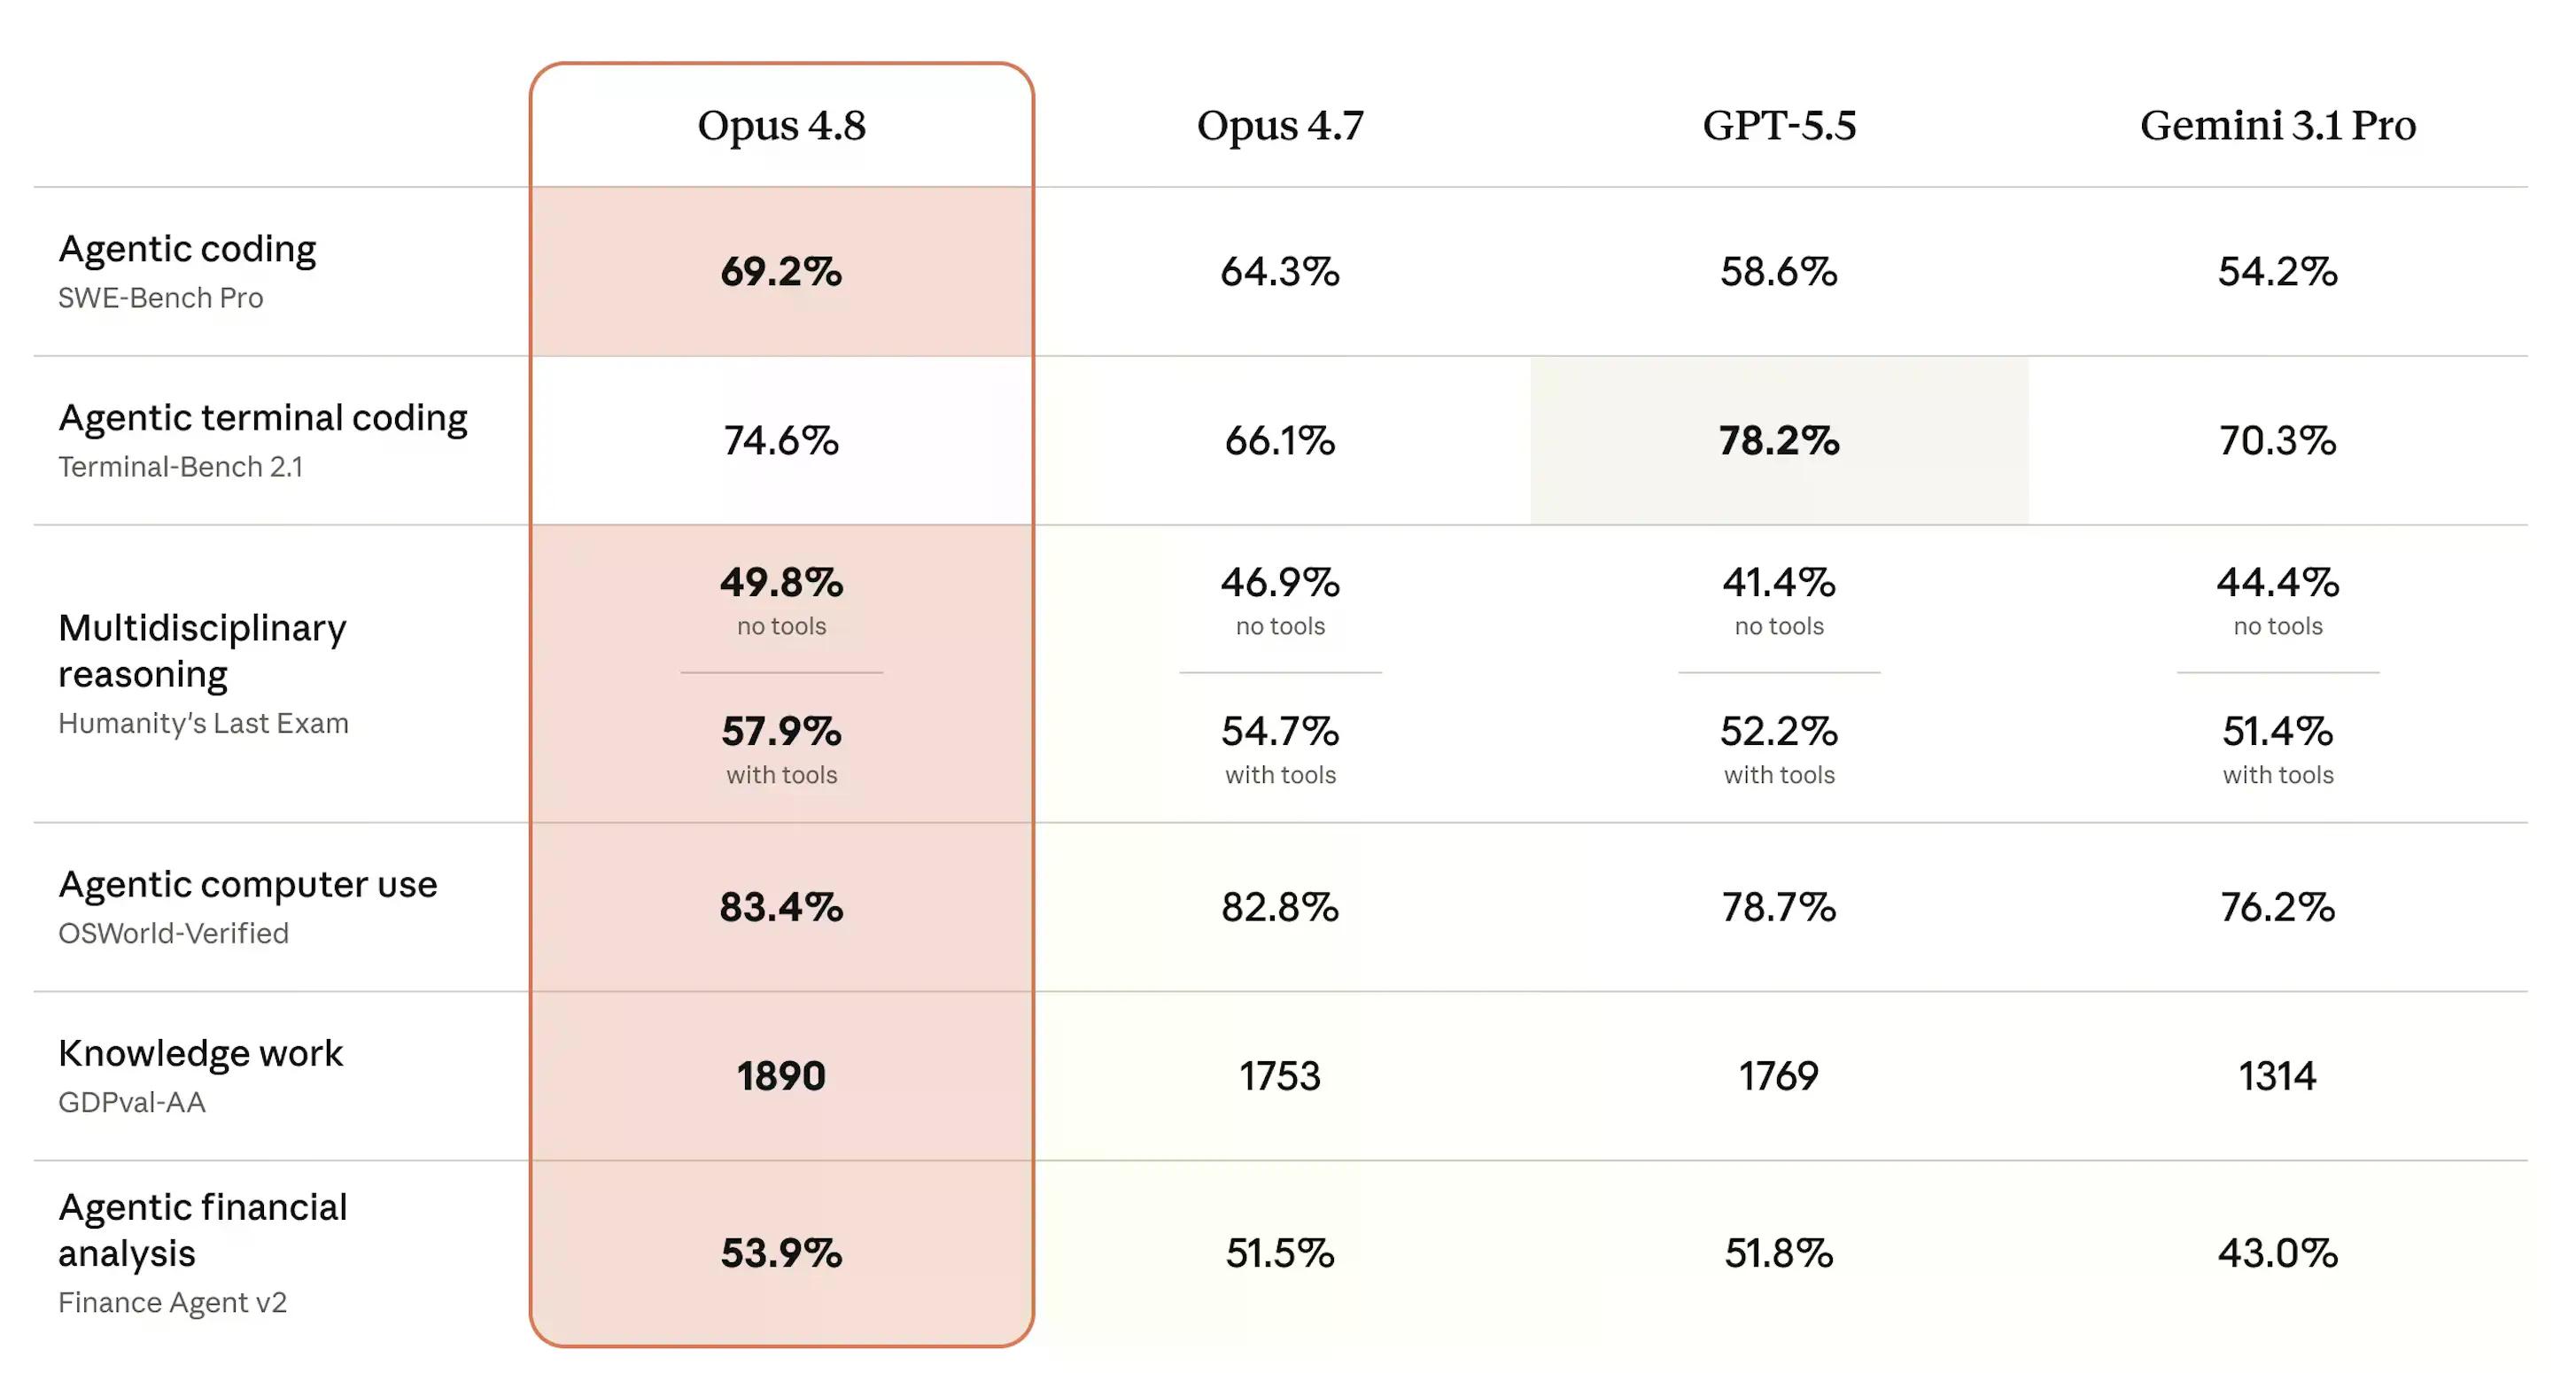
La Humanity's Last Exam – întrebări de nivel expert din zeci de discipline academice, punctate ca procent corect – Opus 4.8 a atins 49,8% fără instrumente și 57,9% cu ele, depășind toți cei trei rivali. OSWorld-Verified, care testează sarcini de utilizare a computerului în lumea reală, cum ar fi navigarea în interfețele software, a obținut 83,4%, depășind ușor scorul de 82,8% al Opus 4.7.
Singura pierdere: Terminal-Bench 2.1, care măsoară performanța AI la sarcinile de linie de comandă. GPT-5.5 conduce cu 78,2%, în timp ce Opus 4.8 obține 74,6% – mai bine decât 66,1% al Opus 4.7 și înaintea lui Gemini cu 70,3%, dar locul al doilea este totuși, în cele din urmă, o pierdere.
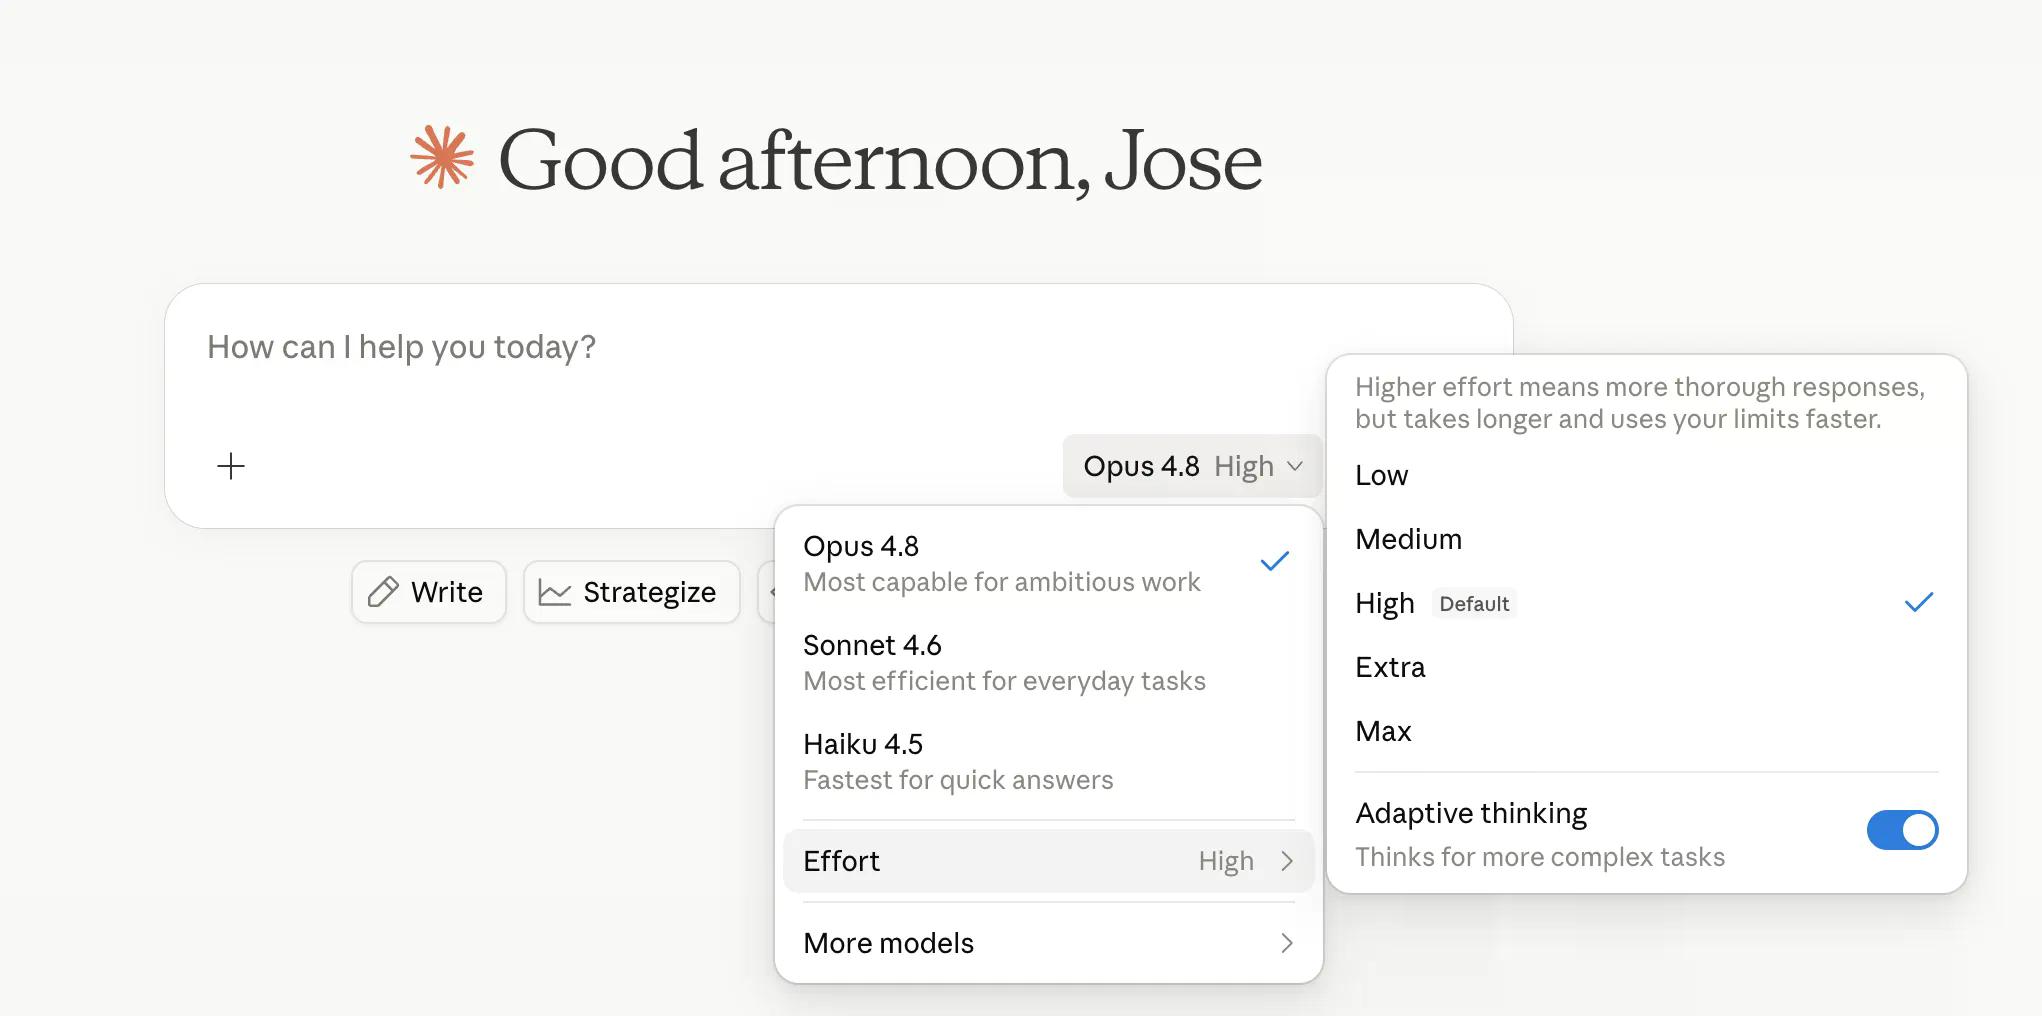
Anthropic le permite acum utilizatorilor să controleze cât de "greu" gândește modelul. "High" este setarea implicită și gestionează majoritatea sarcinilor bine, în timp ce "Extra" – numită "xhigh" în Claude Code – utilizează mai multă putere de calcul pentru probleme mai dificile. "Max" este nivelul cel mai profund. "Low" și "Medium" dedică mai puțini tokeni aceleiași sarcini, economisind timp în schimbul preciziei.
Controlul efortului se află lângă selectorul de model în claude.ai și Cowork, disponibil pe toate planurile. Anthropic spune că setarea implicită "high" utilizează aproximativ același număr de tokeni ca și setarea implicită a Opus 4.7, dar cu rezultate mai bune – ceea ce este fie o inginerie impresionantă, fie un mesaj de marketing bun, și probabil ambele.
Este, de asemenea, important de reținut că noul tokenizer al Anthropic pentru Opus utilizează mai mulți tokeni per sarcină. Așadar, utilizatorii Claude vor cheltui inevitabil mult mai mulți bani pentru a-și îndeplini sarcinile, dacă aleg Opus în locul Claude Sonnet – un model mai puțin capabil, dar probabil suficient de bun pentru sarcinile zilnice și probleme complexe care nu ating nivelul științei de frontieră sau al programării.
Limitele de rată în Claude Code au fost, de asemenea, mărite pentru a absorbi cheltuielile mai mari de tokeni generate de setările Extra și Max.
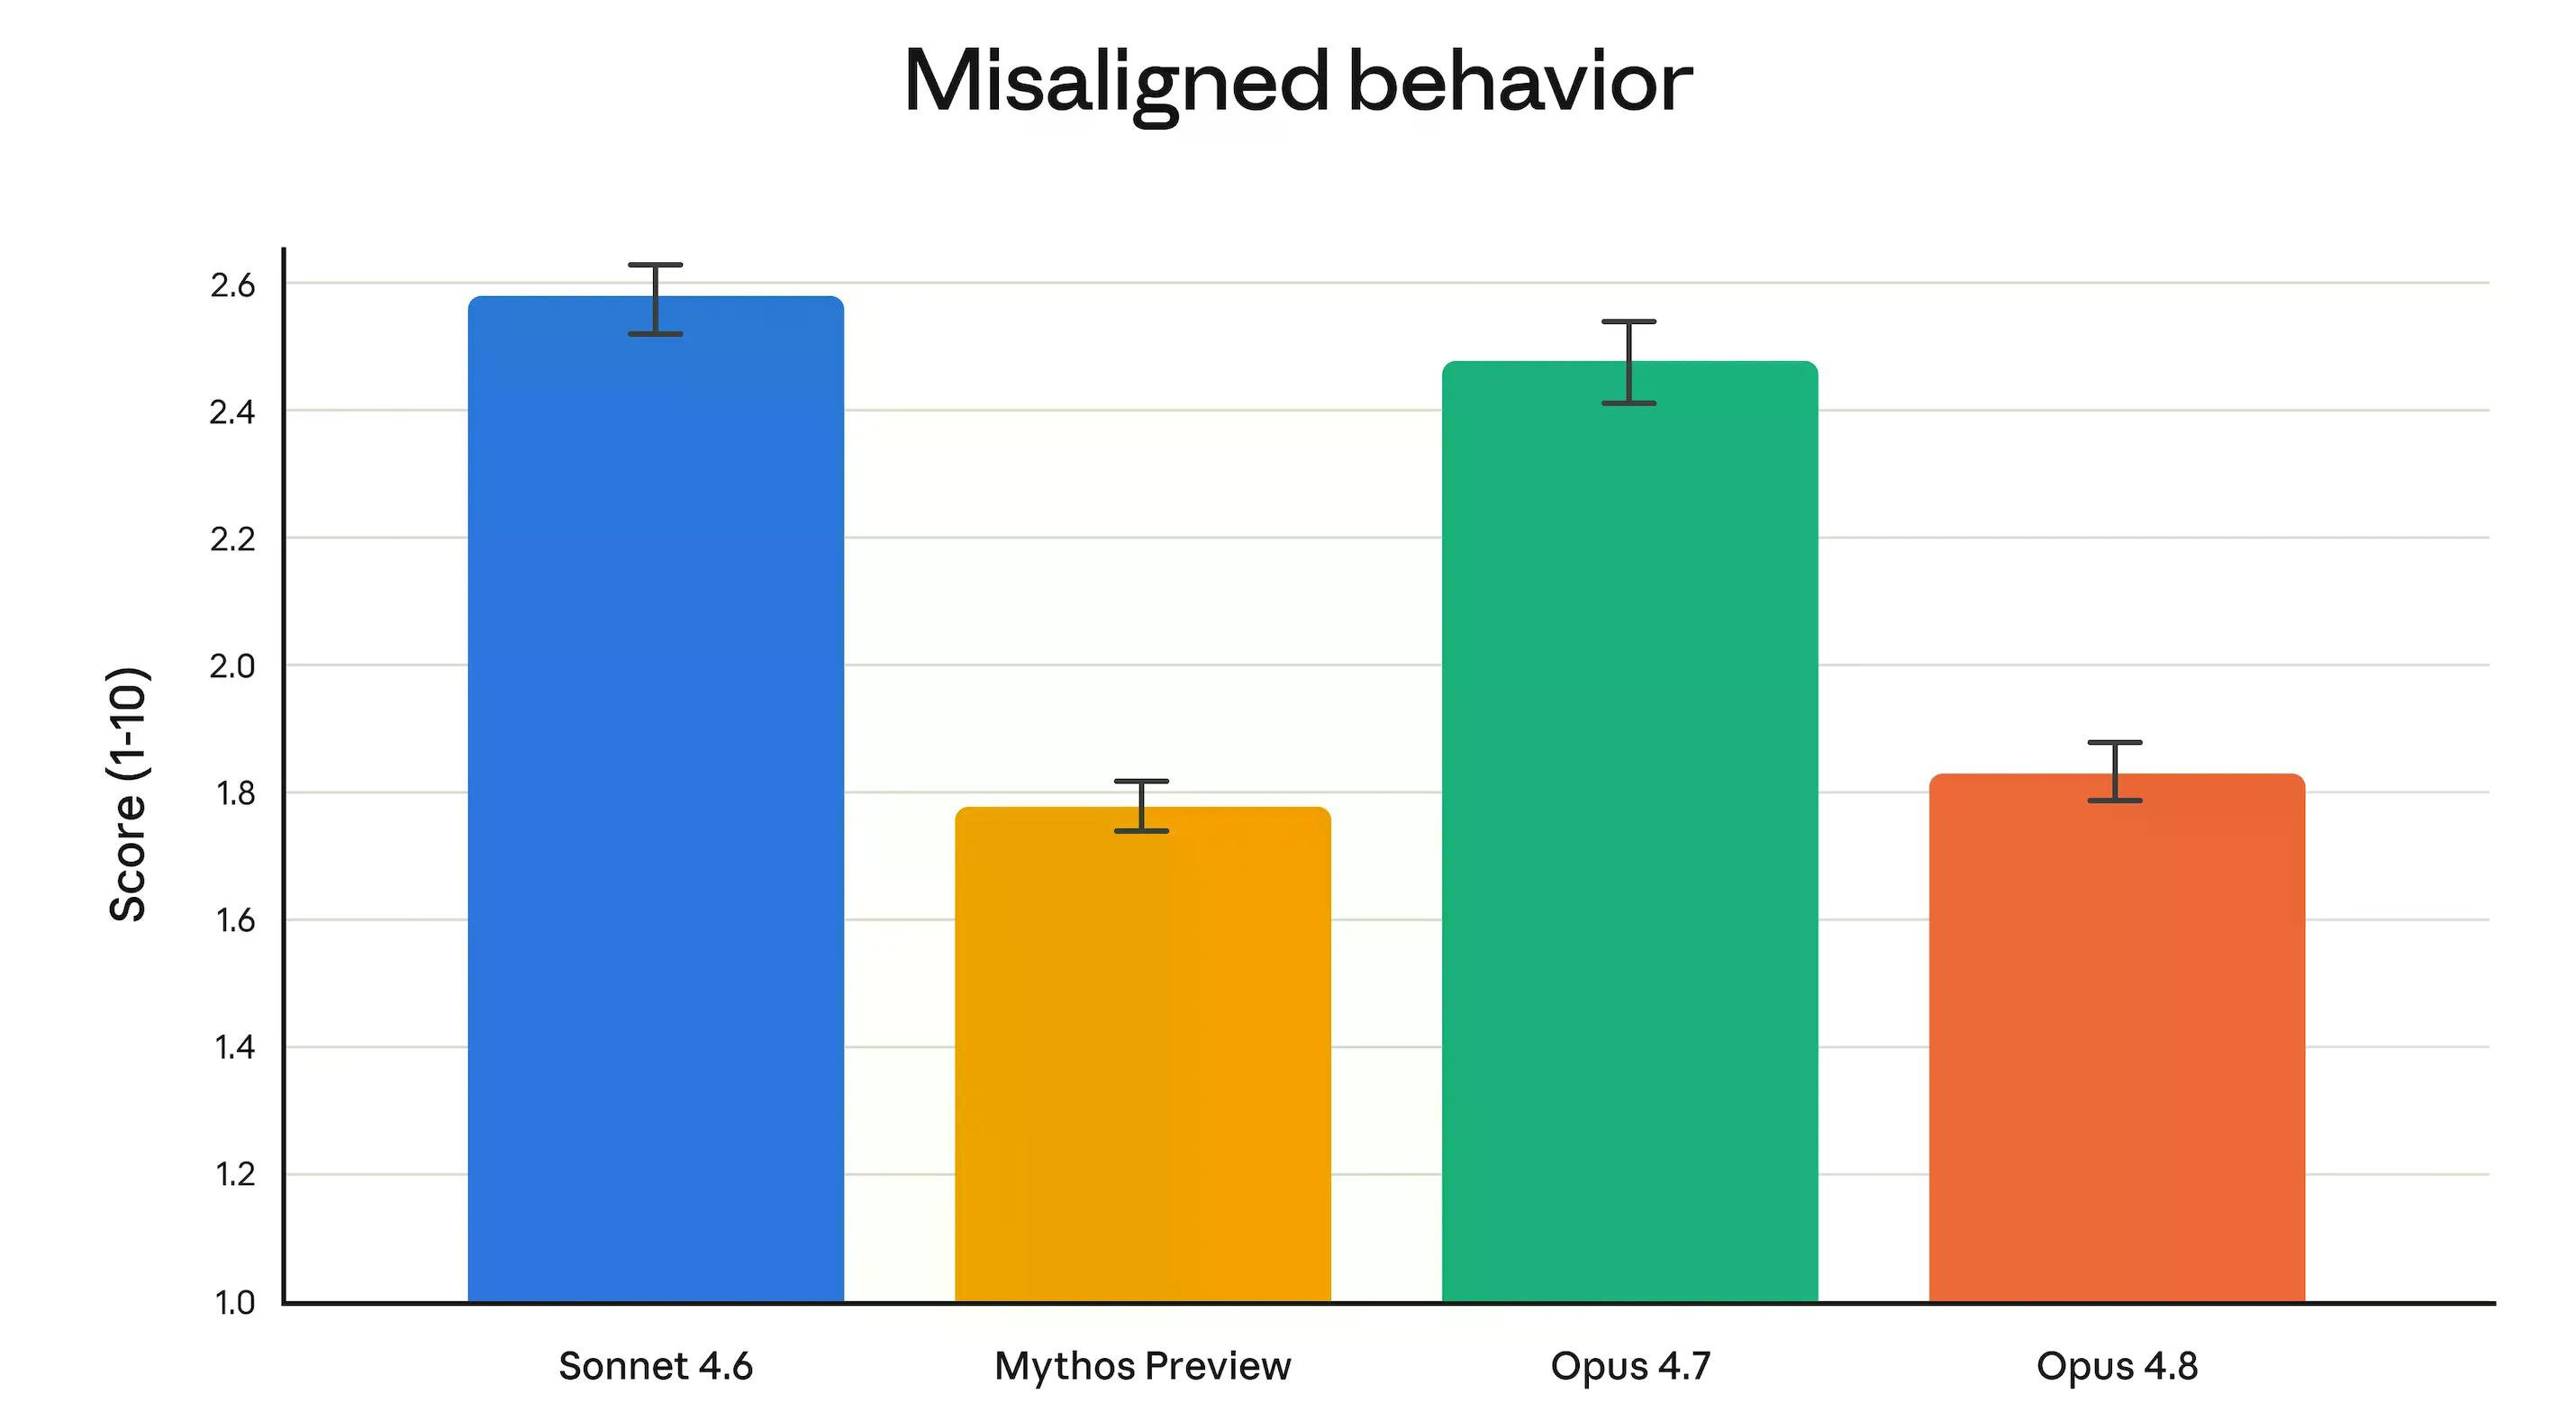
Echipa de aliniere a Anthropic a declarat că Opus 4.8 "atinge noi culmi în măsurile noastre de trăsături prosociale, cum ar fi susținerea autonomiei utilizatorului și acționarea în interesul superior al acestuia". Mai concret: ratele de înșelăciune și ratele de cooperare la utilizarea abuzivă au fost substanțial mai mici decât la Opus 4.7 și comparabile cu Claude Mythos Preview – modelul cel mai strict controlat al Anthropic.
Opus 4.8 este, de asemenea, de patru ori mai puțin probabil decât 4.7 să lase bug-uri în propriul cod să treacă neobservate, fără a le semnaliza.
Această comparație cu Mythos merită context. Mythos este o clasă superioară lui Opus – Anthropic îl descrie ca fiind "mai mare și mai inteligent decât modelele noastre Opus". În prezent, există doar ca o previzualizare, accesibilă unui număr restrâns de organizații verificate care efectuează activități de securitate cibernetică prin Project Glasswing.
Institutul de Securitate AI din Marea Britanie a descoperit că poate finaliza autonom "The Last Ones", o simulare de atac asupra rețelei corporative în 32 de pași, care durează de obicei 20 de ore pentru echipele roșii umane. De aceea nu este încă de vânzare. Anthropic spune că sunt în curs de dezvoltare garanții cibernetice mai puternice și se așteaptă să aducă modele de clasă Mythos tuturor "în următoarele săptămâni".
De asemenea, lansate astăzi: fluxuri de lucru dinamice în Claude Code, în previzualizare de cercetare. Această funcționalitate permite lui Claude să-și scrie propriile scripturi de orchestrare și să lanseze subagenți paraleli într-o singură sesiune, să-și verifice rezultatele și să raporteze – exact ca ceea ce a făcut Hermes de ceva vreme.
Fluxurile de lucru dinamice sunt disponibile pentru utilizatorii planurilor Enterprise, Team și Max, iar Anthropic afirmă clar că acestea consumă semnificativ mai mulți tokeni decât o sesiune standard Claude Code.
Prețurile Anthropic de 5 dolari/25 dolari arată foarte diferit față de ceea ce a făcut China recent.
DeepSeek V4 Pro și-a făcut reducerea de 75% permanentă săptămâna trecută: 0,435 dolari per milion de tokeni de intrare și 0,87 dolari per milion de tokeni de ieșire. Xiaomi MiMo V2.5 Pro rulează la aceleași rate prin furnizori precum OpenRouter.
Modul rapid al Anthropic costă 10 dolari de intrare și 50 de dolari de ieșire pe milion – mai scump decât Opus 4.8 standard în sine și de aproximativ 57 de ori mai mult per token de ieșire decât DeepSeek V4 Pro. Corporațiile au cheltuit deja milioane de dolari în inferență pe modele americane. Fiți extravaganti cu Opus și compania dumneavoastră ar putea ajunge la milioane de dolari destul de rapid.
Răspunsul Anthropic la decalajul de preț este calitatea și siguranța. Pe SWE-bench Pro, Opus 4.8 le depășește pe ambele modele chinezești. În ceea ce privește alinierea, niciunul nu se apropie de benchmark-urile publicate de Anthropic.
Aceste lucruri contează în mediile de producție unde un model care cooperează discret cu intrări malițioase este un risc real – industrii reglementate, activități juridice și orice situație în care „a părut în regulă” nu este un raport acceptabil post-incident. Pentru toți ceilalți, decalajul este greu de ignorat.
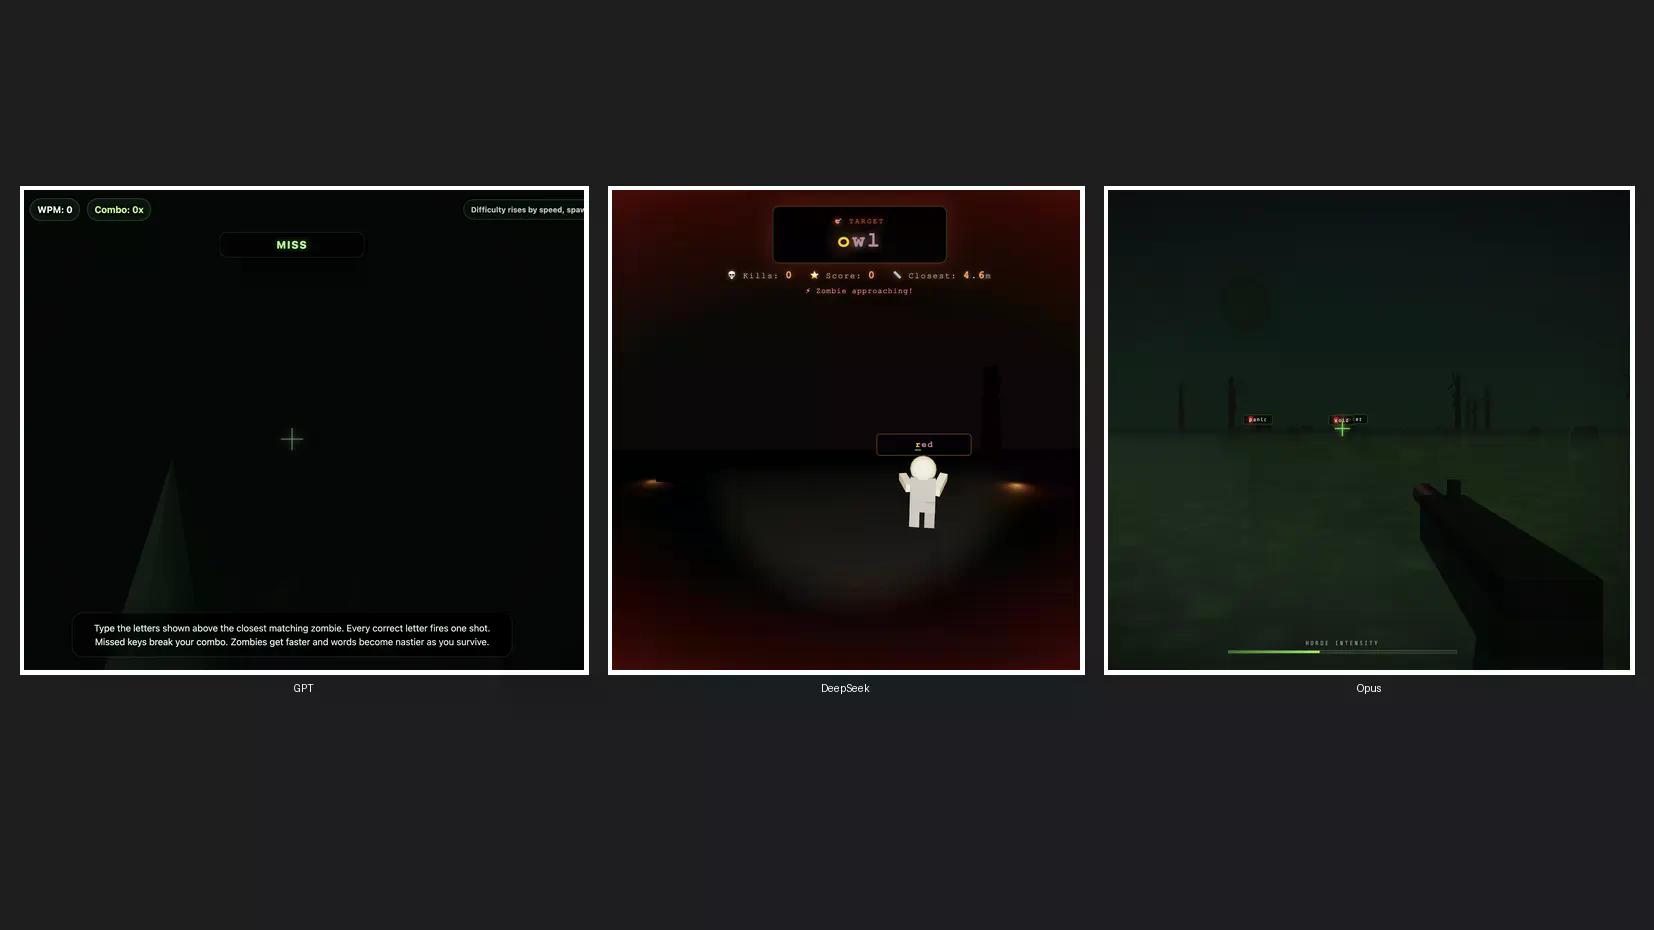
Am efectuat un test rapid de programare pentru a crea un joc 3D cu zombie, pentru a vedea cum se compară Claude Opus 4.8 cu ChatGPT și DeepSeek, probabil cei mai populari concurenți ai săi din SUA și China. Am setat Opus 4.8 pe modul implicit "high", GPT-5.5 pe "high effort" și DeepSeek V4 Pro pe "high effort" – trei modele, o singură solicitare, fără reîncercări.
GPT-5.5 a terminat primul. Jocul său nu avea imagini cu zombie și nici efecte sonore. A fost rapid, desigur, dar a ratat complet cerințele.
DeepSeek V4 Pro a venit pe locul doi, cu mișcare de mouse, personaje zombie reale, efecte sonore, mecanici solide și o estetică curată. Nicio plângere acolo.
Opus 4.8 a durat aproximativ de trei ori mai mult decât GPT-5.5, dar a oferit cel mai bun ecran de întâmpinare, cele mai bune designuri de zombie, cele mai bune mecanici de joc și efecte sonore decente. A fost cel mai lent, dar a avut cel mai bun rezultat. Totuși, asta probabil nu este suficient pentru a justifica utilizarea sa în detrimentul DeepSeek, având în vedere diferența de cost.
Toate jocurile sunt disponibile pe profilul nostru Itch.io. GPT-5.5 a generat Zombie Typing, Opus a generat Typing Dead, iar DeepSeek v4 Pro a generat un joc fără nume care te aruncă direct în acțiune. Să-i spunem TypeSeek.
O recenzie comparativă completă urmează să apară. Deocamdată: Claude Opus 4.8 codează mai bine decât GPT-5.5 și Opus 4.7 pentru acest tip de sarcină, la același preț pe care Anthropic l-a practicat de la 4.7. Dezvoltatorii care plăteau deja 5 dolari pe milion de tokeni au primit gratuit un model mai bun.








