

A DeepSeek está de volta, e apareceu poucas horas depois de a OpenAI lançar o GPT-5.5. Coincidência? Talvez. Mas se você é um laboratório chinês de IA que o governo dos EUA tem tentado desacelerar com proibições de exportação de chips nos últimos três anos, seu senso de timing fica bem aguçado.
O laboratório com sede em Hangzhou lançou hoje versões de pré-visualização do DeepSeek-V4-Pro e DeepSeek-V4-Flash, ambos de pesos abertos, ambos com janelas de contexto de um milhão de tokens. Isso significa que você pode basicamente trabalhar com um contexto do tamanho da trilogia "O Senhor dos Anéis" antes que o modelo colapse. Ambos também têm preços bem abaixo de qualquer coisa comparável no Ocidente, e ambos são gratuitos para aqueles capazes de rodar localmente.
A última grande disrupção da DeepSeek — o R1 em janeiro de 2025 — eliminou US$ 600 bilhões do valor de mercado da Nvidia em um único dia, à medida que investidores questionavam se as empresas americanas realmente precisavam de investimentos tão grandes para produzir resultados que um pequeno laboratório chinês alcançou com uma fração do custo. O V4 é um tipo diferente de movimento: mais silencioso, mais técnico e mais focado na eficiência para qualquer um que realmente esteja construindo com IA.
Dos dois novos modelos, o V4-Pro da DeepSeek é o grande, com 1,6 trilhão de parâmetros totais. Para colocar isso em perspectiva, parâmetros são as "configurações" internas ou "células cerebrais" que um modelo usa para armazenar conhecimento e reconhecer padrões — quanto mais parâmetros um modelo tem, mais informações complexas ele pode teoricamente conter. Isso o torna o maior modelo de código aberto no mercado de LLMs até o momento. O tamanho pode parecer ridículo até você descobrir que ele ativa apenas 49 bilhões deles por passagem de inferência.
Este é o truque de "Mistura de Especialistas" que a DeepSeek refinou desde o V3: O modelo completo está lá, mas apenas a fatia relevante dele é ativada para qualquer solicitação. Mais conhecimento, o mesmo custo computacional.
“DeepSeek-V4-Pro-Max, o modo de esforço máximo de raciocínio do DeepSeek-V4-Pro, avança significativamente as capacidades de conhecimento dos modelos de código aberto, estabelecendo-se firmemente como o melhor modelo de código aberto disponível hoje”, escreveu a Deepseek no cartão oficial do modelo no Huggingface. “Ele alcança desempenho de ponta em benchmarks de codificação e reduz significativamente a lacuna com os principais modelos de código fechado em tarefas de raciocínio e de agente.”
O V4-Flash é o prático: 284 bilhões de parâmetros totais, 13 bilhões ativos. Ele foi projetado para ser mais rápido, mais barato e, de acordo com os próprios benchmarks da DeepSeek, “atinge desempenho de raciocínio comparável à versão Pro quando recebe um orçamento de pensamento maior.”
Ambos suportam um milhão de tokens de contexto. Isso é aproximadamente 750.000 palavras — praticamente a trilogia inteira de “O Senhor dos Anéis” e um pouco mais. E isso é um recurso padrão, não um nível premium.
Aqui está a parte técnica para nerds ou para aqueles interessados na magia que impulsiona o modelo. A Deepseek não esconde seus segredos, e tudo está disponível gratuitamente — o artigo completo está disponível no Github.
A atenção padrão da IA — o mecanismo que permite a um modelo entender as relações entre as palavras — tem um problema brutal de escalabilidade. Cada vez que você dobra o tamanho do contexto, o custo computacional quadruplica. Assim, rodar um modelo em um milhão de tokens não é apenas duas vezes mais caro que 500.000 tokens. É quatro vezes mais caro. É por isso que o contexto longo tem sido historicamente uma caixa de seleção que os laboratórios adicionam e depois silenciosamente limitam por meio de limites de taxa.
A DeepSeek inventou dois novos tipos de atenção para contornar isso. O primeiro, Atenção Esparsa Comprimida, funciona em duas etapas. Primeiro, comprime grupos de tokens — digamos, a cada 4 tokens — em uma única entrada. Em seguida, em vez de focar em todas essas entradas comprimidas, usa um "Indexador Relâmpago" para selecionar apenas os resultados mais relevantes para uma determinada consulta. Seu modelo passa de focar em um milhão de tokens para focar em um conjunto muito menor dos fragmentos mais importantes, como um bibliotecário que não lê todos os livros, mas sabe exatamente qual prateleira verificar.
A segunda, Atenção Altamente Comprimida, é mais agressiva. Ela colapsa a cada 128 tokens em uma única entrada — sem seleção esparsa, apenas compressão brutal. Você perde detalhes finos, mas obtém uma visão global extremamente barata. Os dois tipos de atenção são executados em camadas alternadas, então o modelo obtém tanto o detalhe quanto a visão geral.
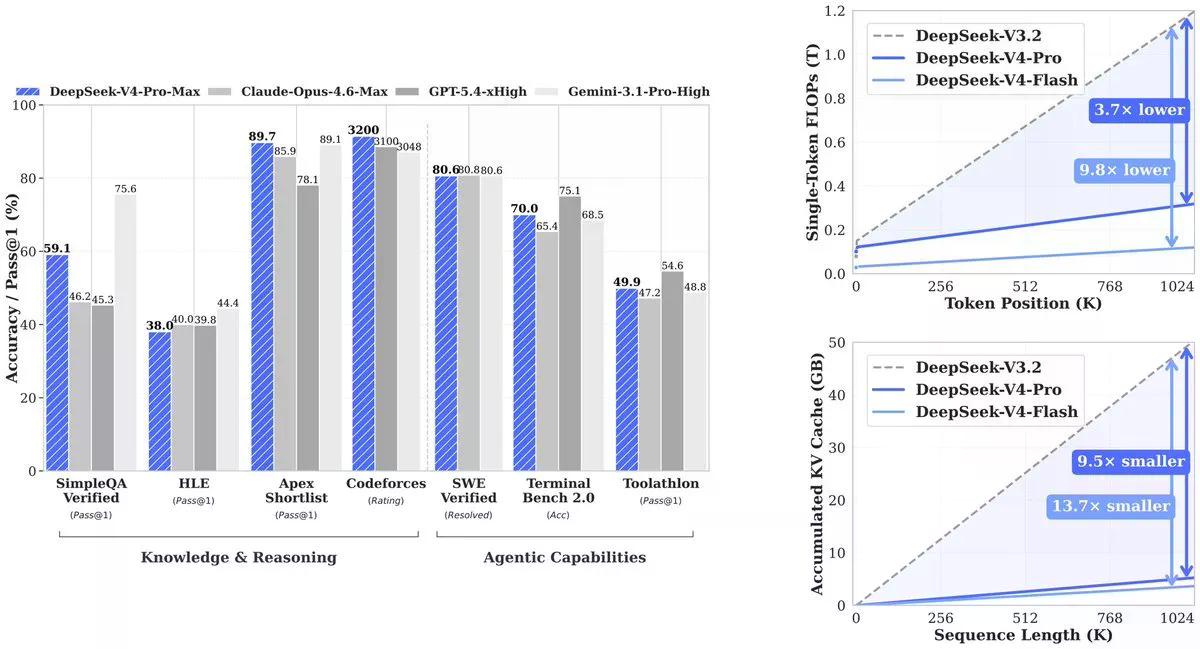
O resultado, do artigo técnico: Com um milhão de tokens, o V4-Pro usa 27% do poder computacional que seu predecessor (V3.2) precisava. O cache KV — a memória que o modelo precisa para rastrear o contexto — cai para apenas 10% do V3.2. O V4-Flash vai além: 10% do poder computacional, 7% da memória.
E isso resultou na Deepseek ser capaz de oferecer um preço por token muito mais barato do que seus concorrentes, ao mesmo tempo em que oferece resultados comparáveis. Para colocar isso em termos de dólares: o GPT-5.5 foi lançado ontem a US$ 5 de entrada e US$ 30 de saída por milhão de tokens, com o GPT-5.5 Pro custando US$ 30 por milhão de tokens de entrada e US$ 180 por milhão de tokens de saída.
Deepseek V4-Pro custa US$ 1,74 de entrada e US$ 3,48 de saída. V4-Flash custa US$ 0,14 de entrada e US$ 0,28 de saída. O CEO da Cline, Saoud Rizwan, apontou que se a Uber tivesse usado DeepSeek em vez de Claude, seu orçamento de IA para 2026 — supostamente suficiente para quatro meses de uso — teria durado sete anos.
deepseek v4 is now the cheapest sota model available at 1/20th the cost of opus 4.7.
for perspective, if uber used deepseek instead of claude their 2026 ai budget would have lasted 7 years instead of only 4 months. pic.twitter.com/i9rJZzvRBV
— Saoud Rizwan (@sdrzn) April 24, 2026
A DeepSeek faz algo incomum em seu relatório técnico: publica as lacunas. A maioria dos lançamentos de modelos seleciona os benchmarks nos quais eles vencem. A DeepSeek executou a comparação completa contra o GPT-5.4 e o Gemini-3.1-Pro, descobriu que o raciocínio do V4-Pro está atrasado em relação a esses modelos em cerca de três a seis meses, e ainda assim o publicou.
Onde o V4-Pro-Max realmente vence: Codeforces, benchmark de programação competitiva, classificado como xadrez humano. O V4-Pro obteve 3.206 pontos, o que o coloca em cerca de 23º lugar entre os participantes humanos reais da competição. No Apex Shortlist, um conjunto selecionado de problemas difíceis de matemática e STEM, ele obteve uma taxa de aprovação de 90,2% contra 85,9% do Opus 4.6 e 78,1% do GPT-5.4. No SWE-Verified, que mede se um modelo pode resolver problemas reais do GitHub extraídos de repositórios de código aberto reais, ele obteve 80,6% — igualando o Claude Opus 4.6.
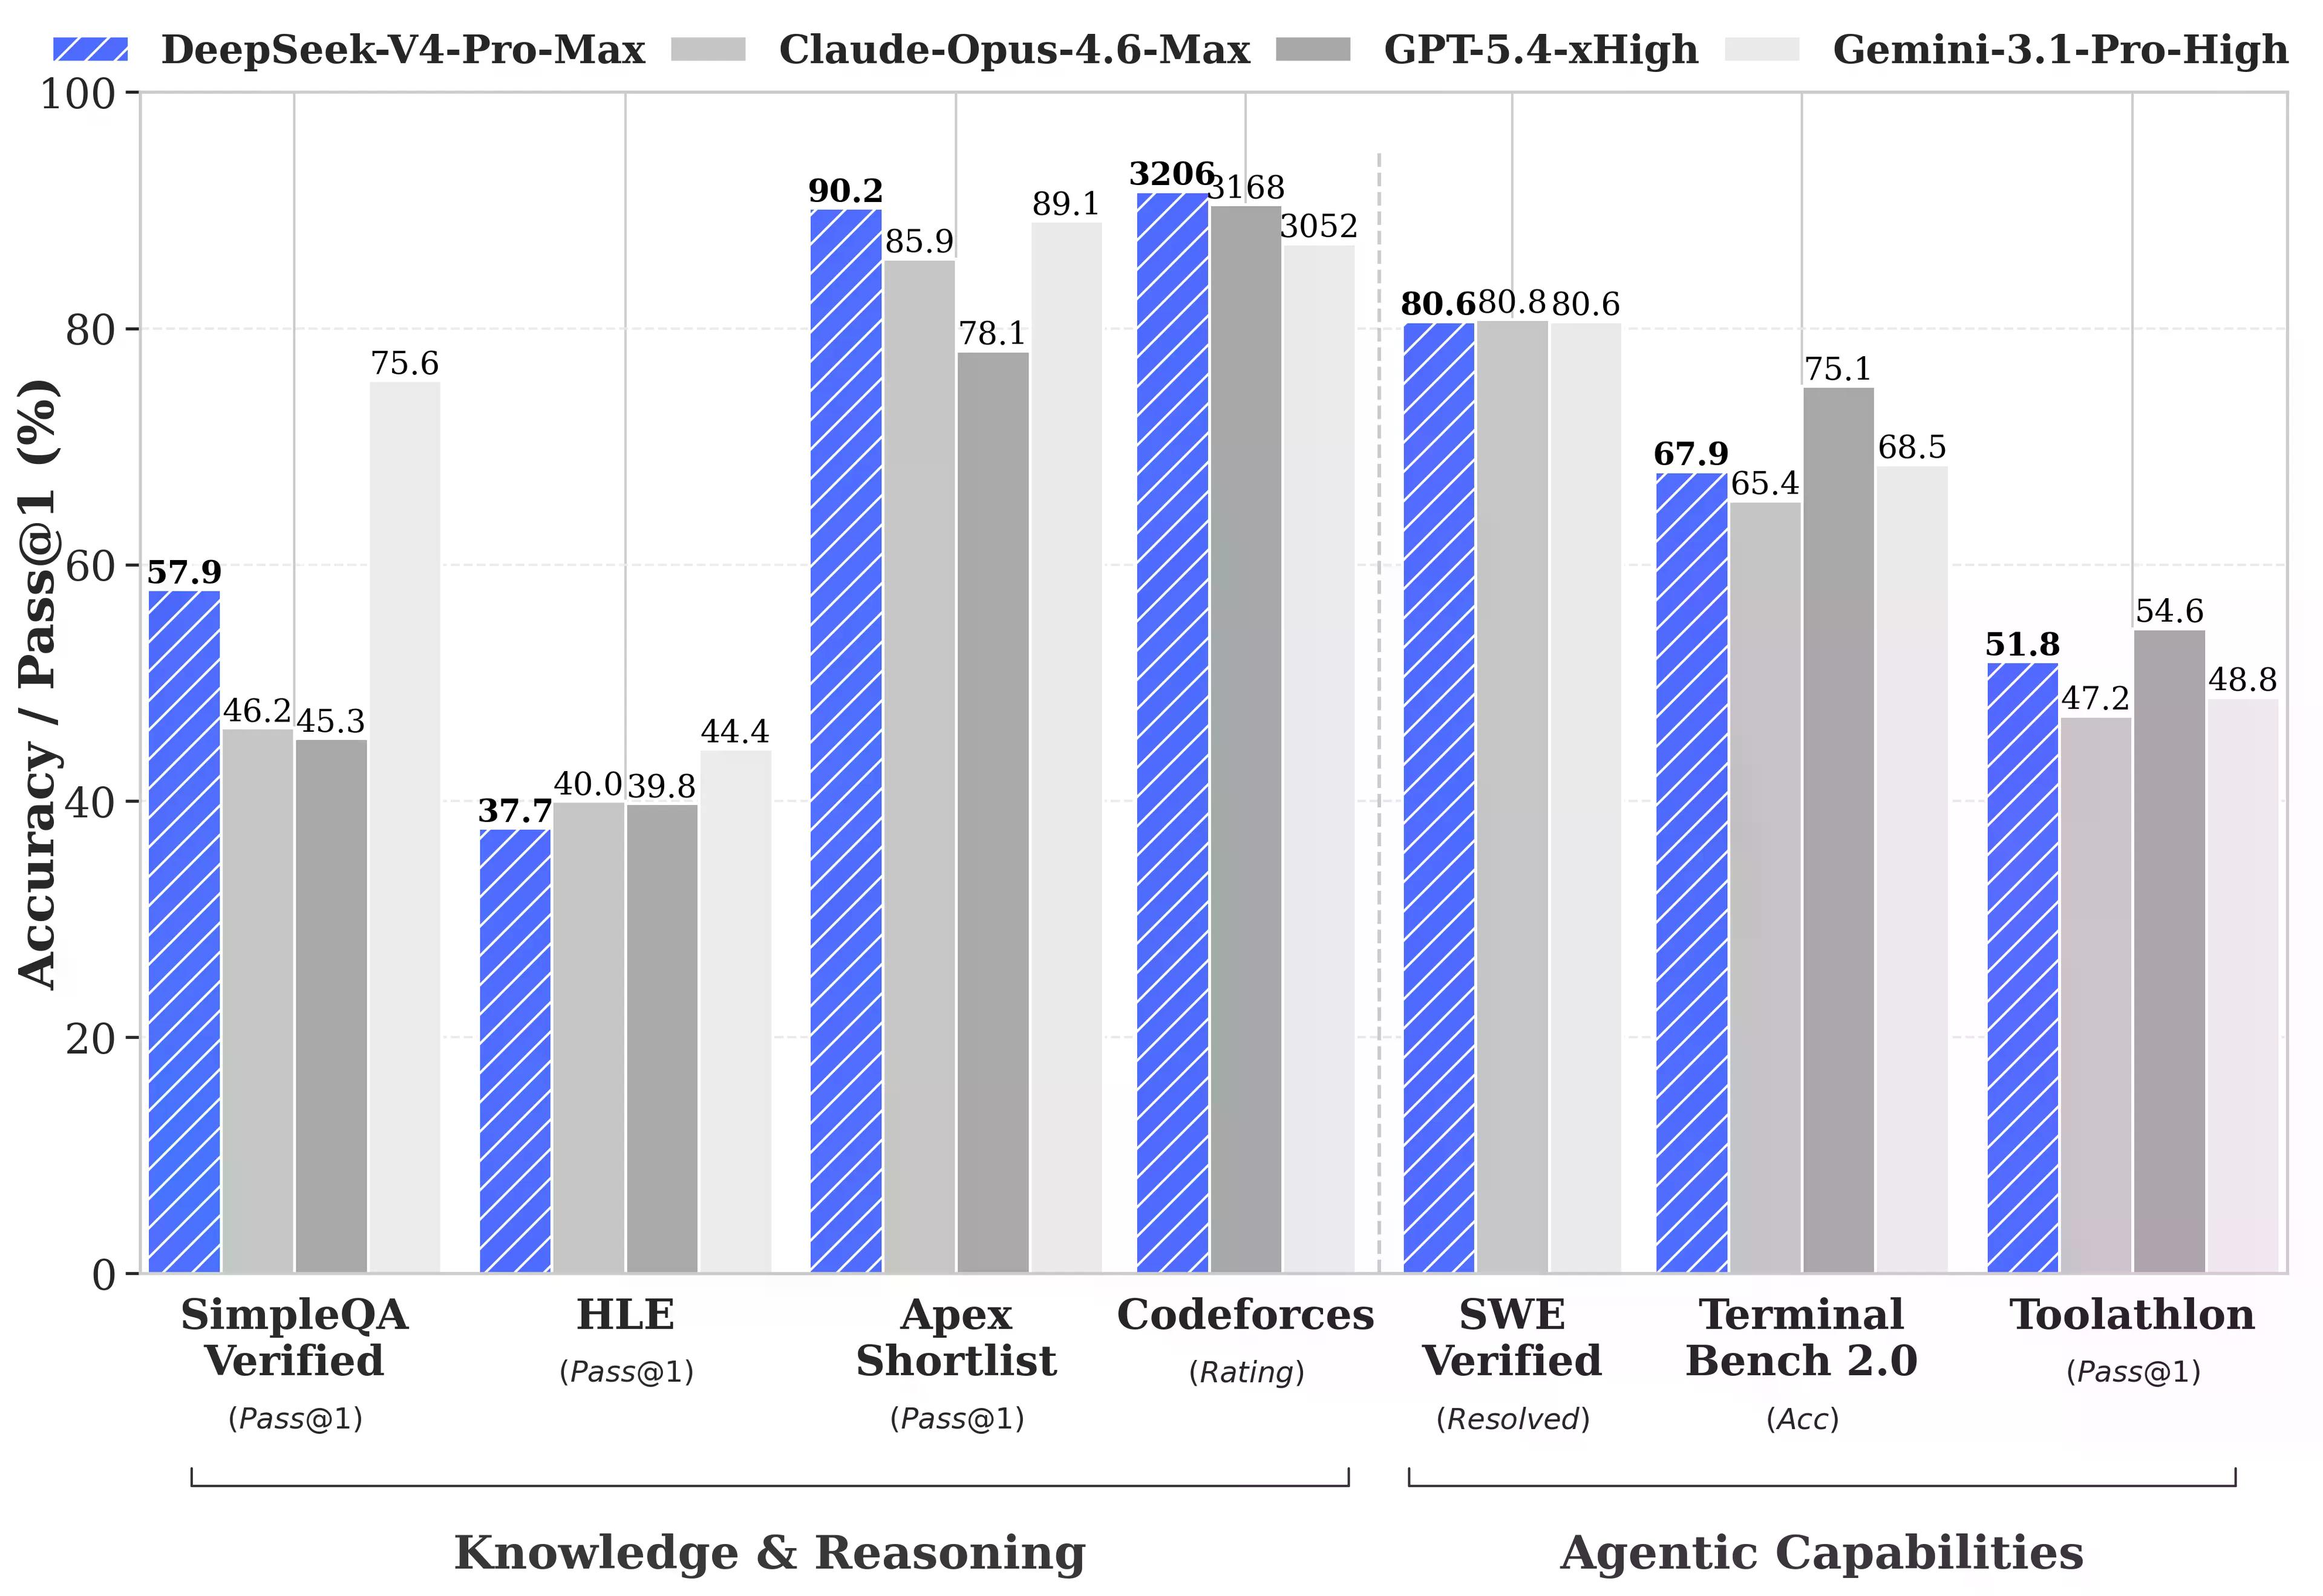
Onde ele fica para trás: no benchmark multitarefa MMLU-Pro (Gemini-3.1-Pro com 91,0% vs V4-Pro com 87,5%), no benchmark de conhecimento especializado GPQA Diamond (Gemini 94.3 vs V4-Pro 90.1) e no Humanity's Last Exam, um benchmark de nível de pós-graduação onde 44,4% do Gemini-3.1-Pro ainda supera os 37,7% do V4-Pro.
Especificamente no contexto longo, o V4-Pro lidera os modelos de código aberto e supera o Gemini-3.1-Pro no benchmark CorpusQA (um teste que simula a análise de documentos reais em um milhão de tokens), mas perde para o Claude Opus 4.6 no MRCR — um teste que mede o quão bem um modelo recupera "agulhas" específicas enterradas profundamente em um "palheiro" muito longo.
A parte de agente é onde este lançamento se torna interessante para desenvolvedores que realmente estão lançando produtos.
O V4-Pro pode ser executado no Claude Code, OpenCode e outras ferramentas de codificação de IA. De acordo com a pesquisa interna da DeepSeek com 85 desenvolvedores que usaram o V4-Pro como seu principal agente de codificação, 52% disseram que ele estava pronto para ser seu modelo padrão, 39% tenderam a dizer sim, e menos de 9% disseram não. Funcionários internos disseram que ele supera o Claude Sonnet e se aproxima do Claude Opus 4.5 em tarefas de codificação de agente.
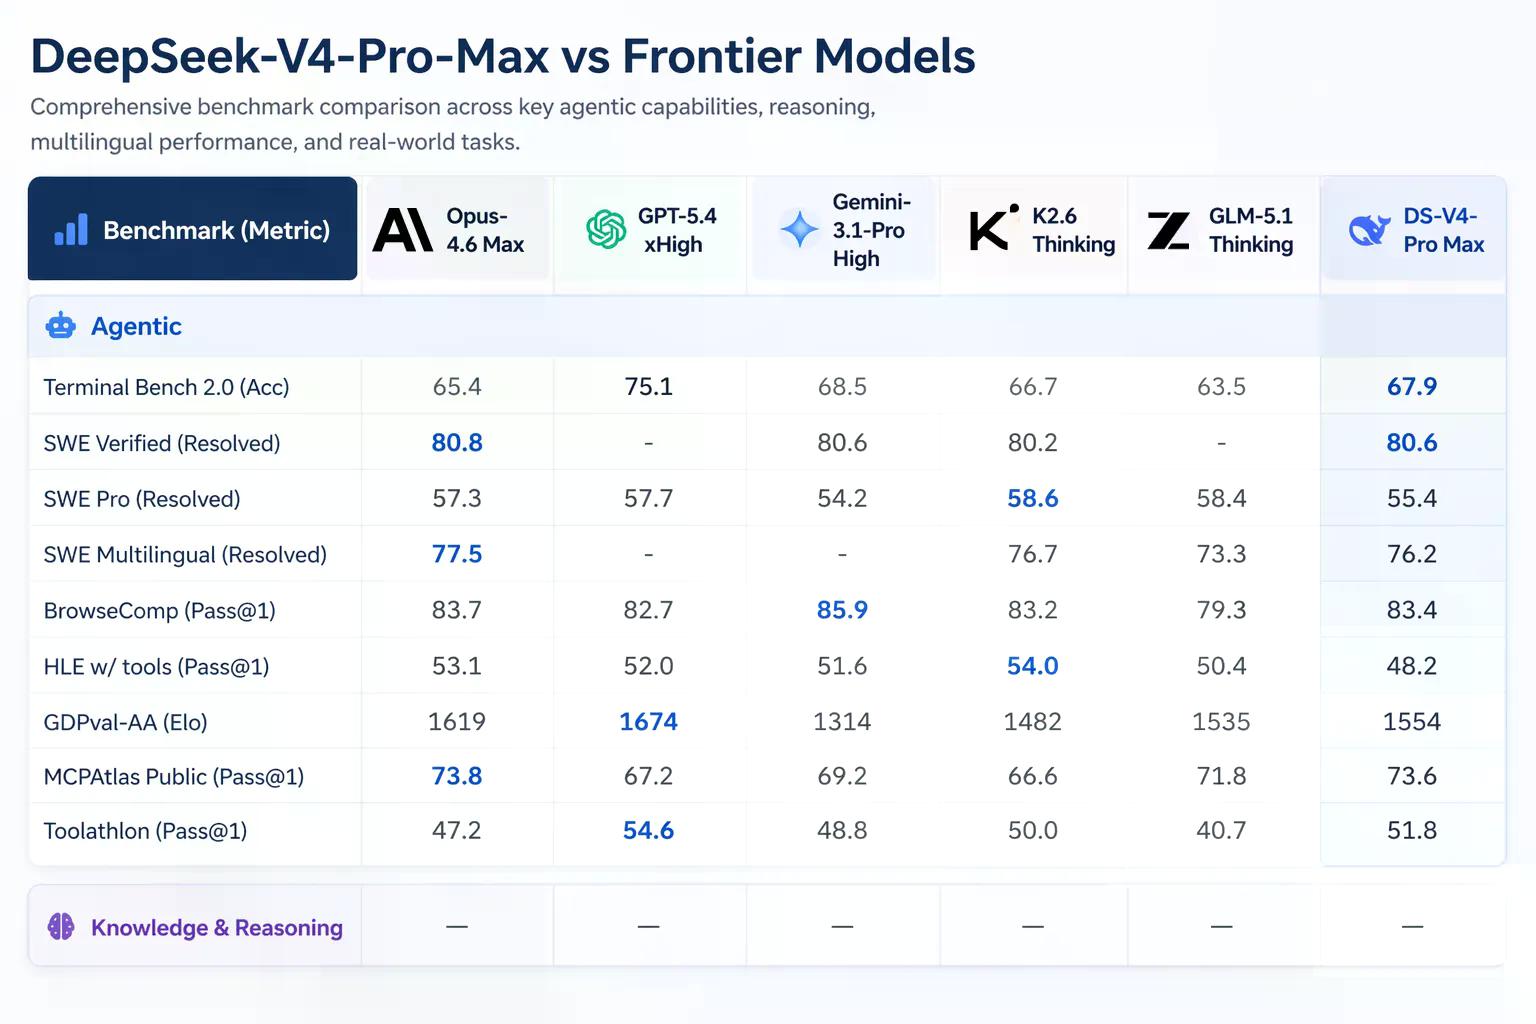
Artificial Analysis, que realiza avaliações independentes de modelos de IA em tarefas do mundo real, classificou o V4-Pro em primeiro lugar entre todos os modelos de pesos abertos no GDPval-AA — um benchmark que testa o trabalho de conhecimento economicamente valioso em finanças, direito e pesquisa, pontuado via Elo. O V4-Pro-Max obteve 1.554 Elo, à frente do GLM-5.1 (1.535) e do M2.7 da MiniMax (1.514). Para referência, o Claude Opus 4.6 obtém 1.619 no mesmo benchmark — ainda à frente, mas a diferença está diminuindo.
DeepSeek V4 Pro is the #1 open weights model on GDPval-AA, our agentic real-world work tasks evaluation@deepseek_ai has released V4 Pro (1.6T total / 49B active) and V4 Flash (284B total / 13B active). V4 is DeepSeek's first new size since V3, with all intermediate models… pic.twitter.com/2kJWVrKQjF
— Artificial Analysis (@ArtificialAnlys) April 24, 2026
O V4 da Deepseek também introduz algo chamado “pensamento intercalado”. Em modelos anteriores, se você estivesse executando um agente que fazia múltiplas chamadas de ferramentas — digamos, ele pesquisava na web, depois executava algum código, depois pesquisava novamente — o contexto de raciocínio do modelo era limpo entre as rodadas. A cada nova etapa, o modelo tinha que reconstruir seu modelo mental do zero. O V4 retém a cadeia de pensamento completa entre as chamadas de ferramentas, então um fluxo de trabalho de agente de 20 etapas não sofre de amnésia no meio do caminho. Isso importa mais do que parece para quem executa pipelines automatizados complexos.
Os EUA têm restringido as exportações de chips Nvidia de alta qualidade para a China desde 2022. O objetivo declarado era desacelerar o desenvolvimento de IA chinesa, mas a proibição de chips não impediu a DeepSeek e, em vez disso, os fez inventar uma arquitetura mais eficiente e construir uma oferta de hardware doméstico.
A DeepSeek não lançou o V4 no vácuo — o espaço da IA tem estado cheio de atividade ultimamente: a Anthropic lançou o Claude Opus 4.7 em 16 de abril — um modelo que a Decrypt testou e considerou forte em codificação e raciocínio, com uso de tokens notavelmente alto. No dia anterior, a Anthropic também estava trabalhando no Claude Mythos, um modelo de cibersegurança que ela afirma não poder lançar publicamente porque é muito bom em ataques de rede autônomos.
A Xiaomi lançou o MiMo V2.5 Pro em 22 de abril, tornando-se totalmente multimodal — imagem, áudio, vídeo. Custa US$ 1 de entrada e US$ 3 de saída por milhão de tokens. Ele se equipara ao Opus 4.6 na maioria dos benchmarks de codificação. Três meses atrás, ninguém falava da Xiaomi como uma empresa de IA de fronteira. Agora ela está lançando modelos competitivos mais rapidamente do que a maioria dos laboratórios ocidentais.
O GPT-5.5 da OpenAI foi lançado ontem com custos que chegam a US$ 180 por milhão de tokens de saída na versão Pro. Ele supera o V4-Pro no Terminal Bench 2.0 (82,7% vs 70,0%), que testa fluxos de trabalho de agente de linha de comando complexos. Mas custa consideravelmente mais que o V4-Pro para tarefas equivalentes. No mesmo dia, a Tencent lançou o Hy3, outro modelo de última geração focado na eficiência.
Com tantos modelos novos disponíveis, a pergunta que os desenvolvedores estão realmente fazendo é: quando o preço premium vale a pena?
Para as empresas, a matemática pode ter mudado. Um modelo que lidera os benchmarks de código aberto a US$ 1,74 por milhão de tokens de entrada significa que o processamento de documentos em larga escala, a revisão jurídica ou os pipelines de geração de código que eram caros há seis meses agora são muito mais baratos. O contexto de um milhão de tokens significa que você pode alimentar bases de código inteiras ou documentos regulatórios em uma única solicitação, em vez de dividi-los em várias chamadas.
Além disso, sua natureza de código aberto significa que ele não apenas pode ser executado gratuitamente em hardware local, mas também pode ser personalizado e aprimorado com base nas necessidades e casos de uso da empresa.
Para desenvolvedores e construtores solo, o V4-Flash é o que deve ser observado. A US$ 0,14 de entrada e US$ 0,28 de saída, ele é mais barato do que modelos que eram considerados opções de baixo custo há um ano — e lida com a maioria das tarefas que a versão Pro gerencia. Os endpoints existentes deepseek-chat e deepseek-reasoner da DeepSeek já roteiam para o V4-Flash nos modos sem pensamento e com pensamento, respectivamente, então se você está na API, já está usando-o.
Os modelos são apenas texto por enquanto. A DeepSeek disse que está trabalhando em capacidades multimodais, o que significa que outros grandes laboratórios, da Xiaomi à OpenAI, ainda têm essa vantagem. Ambos os modelos são licenciados sob MIT e estão disponíveis no Hugging Face hoje. Os antigos endpoints deepseek-chat e deepseek-reasoner serão desativados em 24 de julho de 2026.





