


A Z.ai lançou o GLM-5.2 em 16 de junho, prometendo desempenhos de alto nível, superando seu já avançado GLM 5.1.
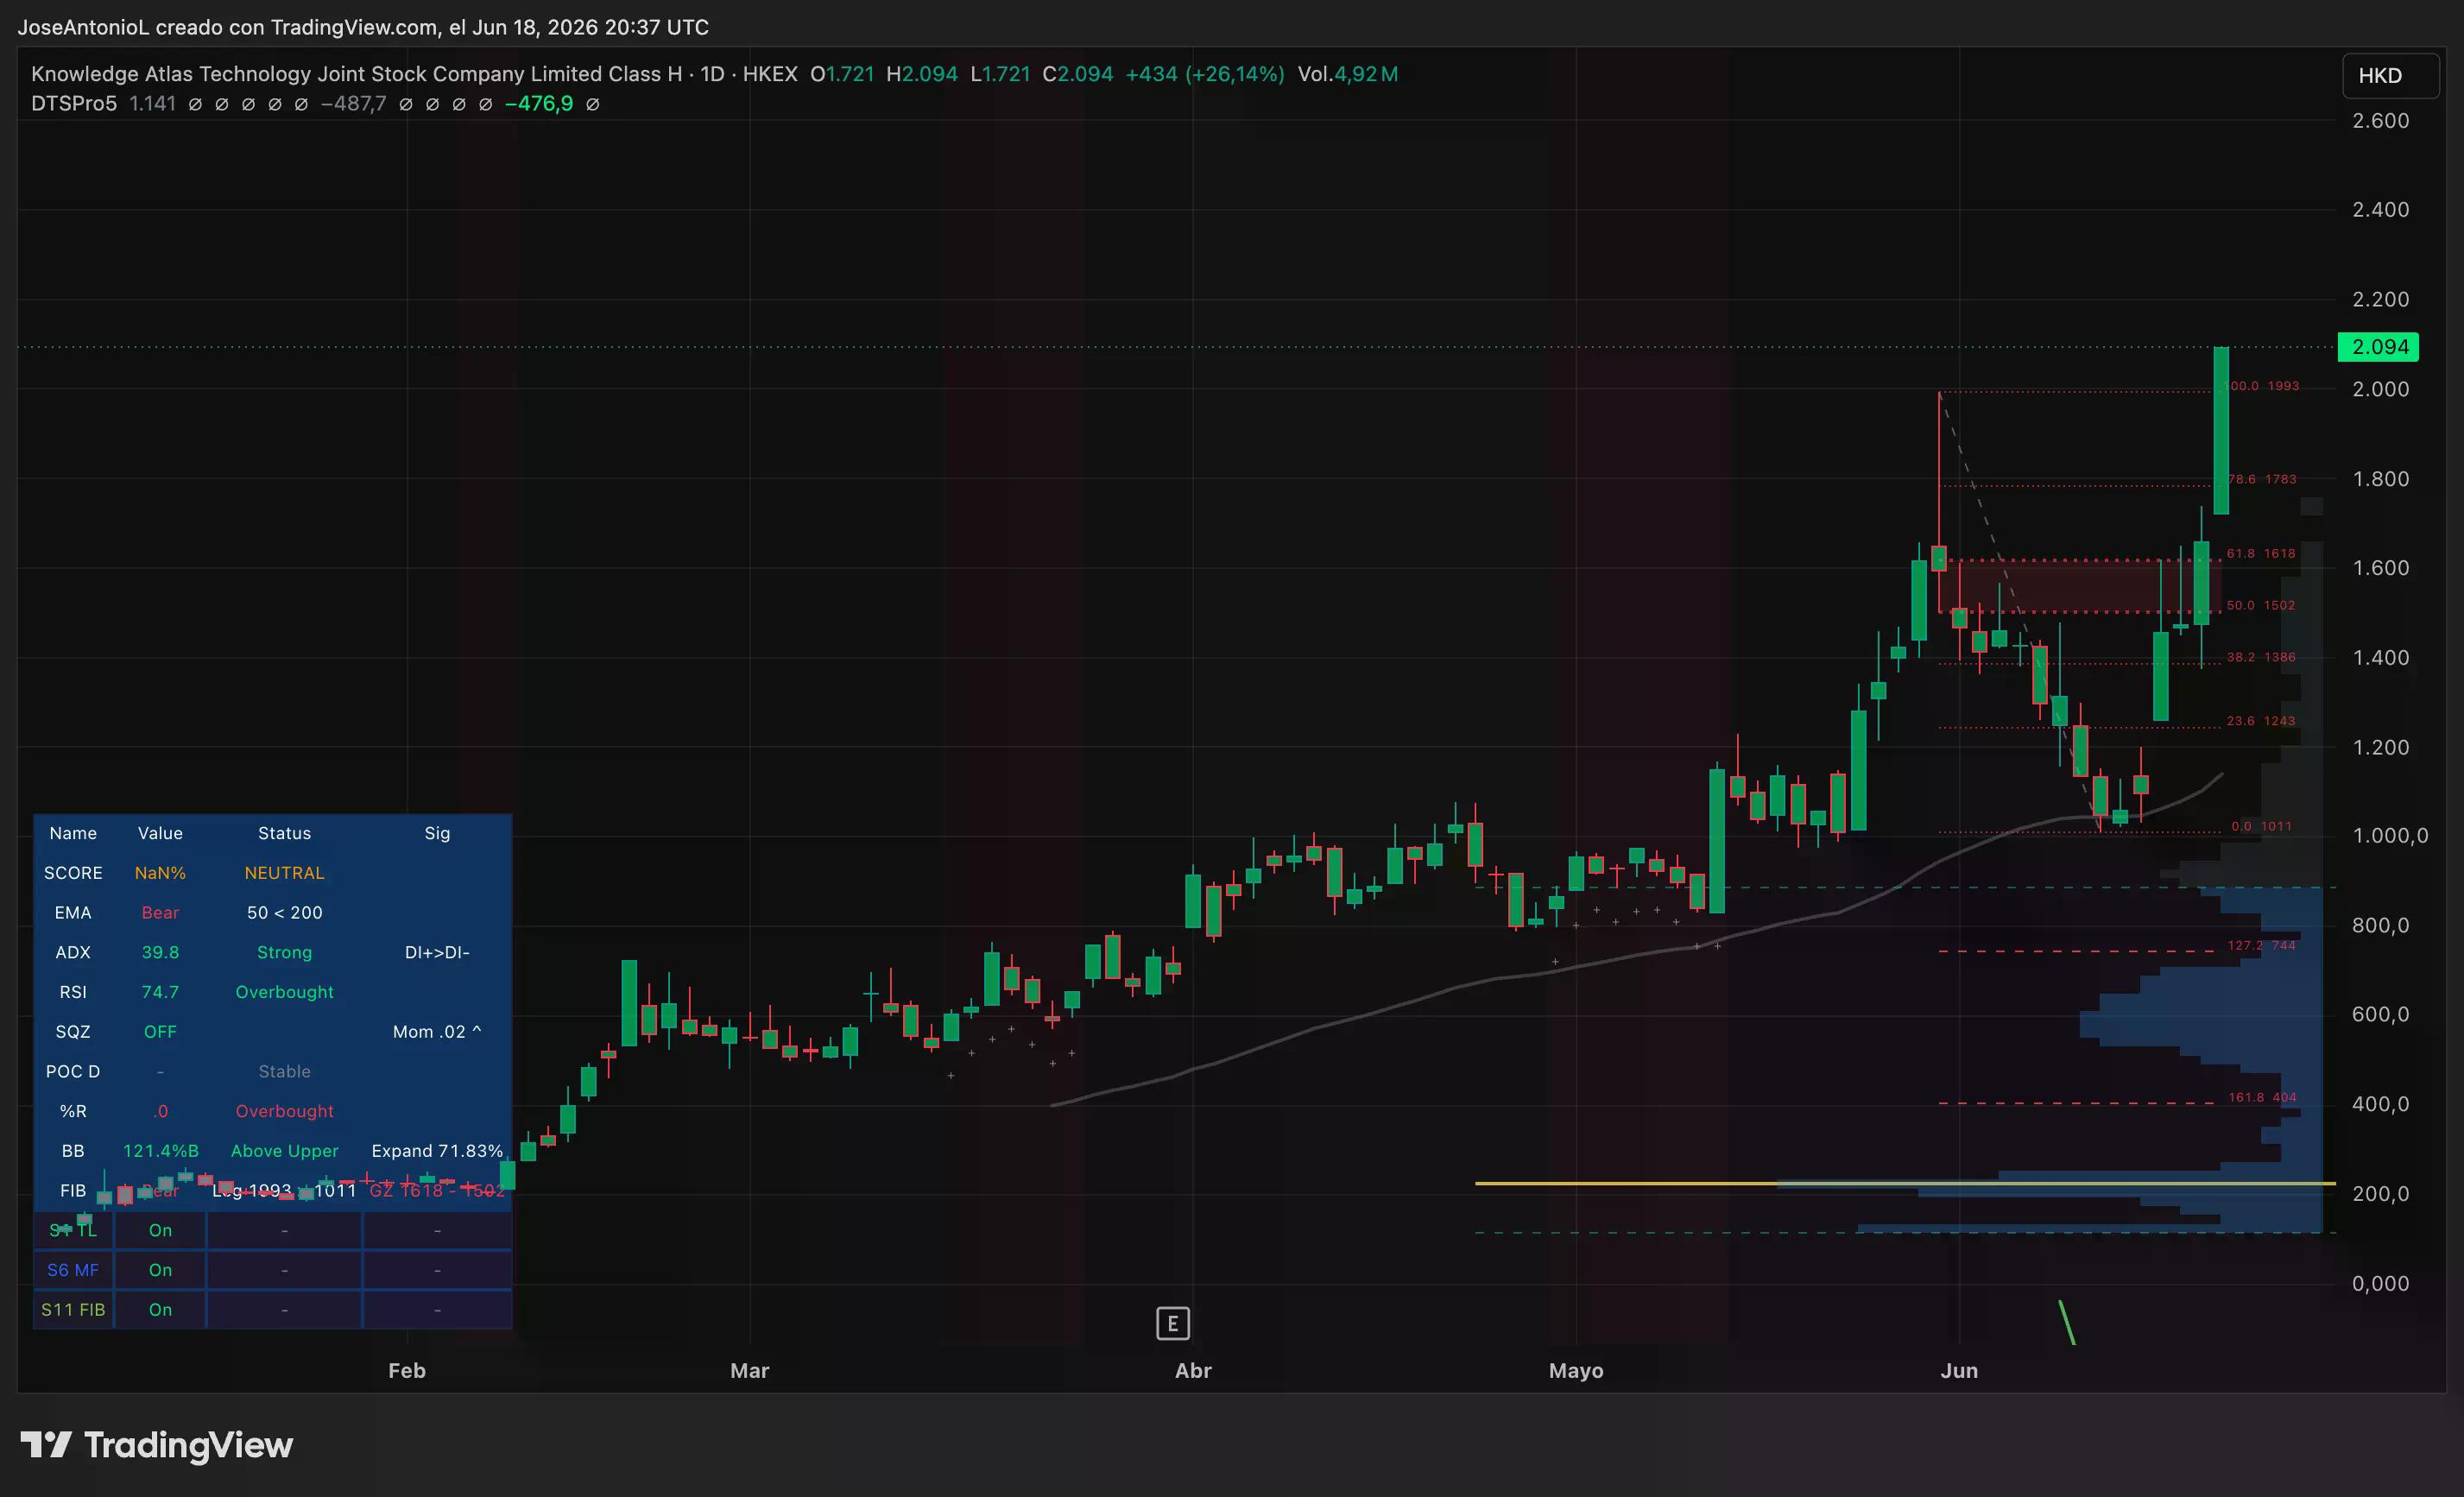
O laboratório com sede em Pequim, que está na Lista de Entidades dos EUA desde janeiro de 2025, parece estar se beneficiando das crescentes preocupações com a abordagem dos Estados Unidos à IA. Na última semana, a proibição do Anthropic Fable e o lançamento deste novo modelo ajudaram a impulsionar as ações da zAI em 90%, levando-as a um novo recorde histórico.
O GLM 5.2 tem os números para justificar o alarido.
No FrontierSWE—um benchmark que avalia se um agente de IA consegue concluir projetos técnicos abertos medidos em horas, cobrindo otimização de sistemas, construção de código em larga escala e pesquisa de ML aplicada, pontuado pela taxa de dominância—o GLM-5.2 atingiu 74.4 contra 75.1 do Claude Opus 4.8. Ele superou o GPT-5.5 com 72.6. No SWE-bench Pro, que testa a resolução autônoma de problemas reais do GitHub pontuados como taxa de aprovação, o GLM-5.2 marcou 62.1 contra 58.6 do GPT-5.5—e superou seu predecessor GLM-5.1 de 58.4 por uma ampla margem.
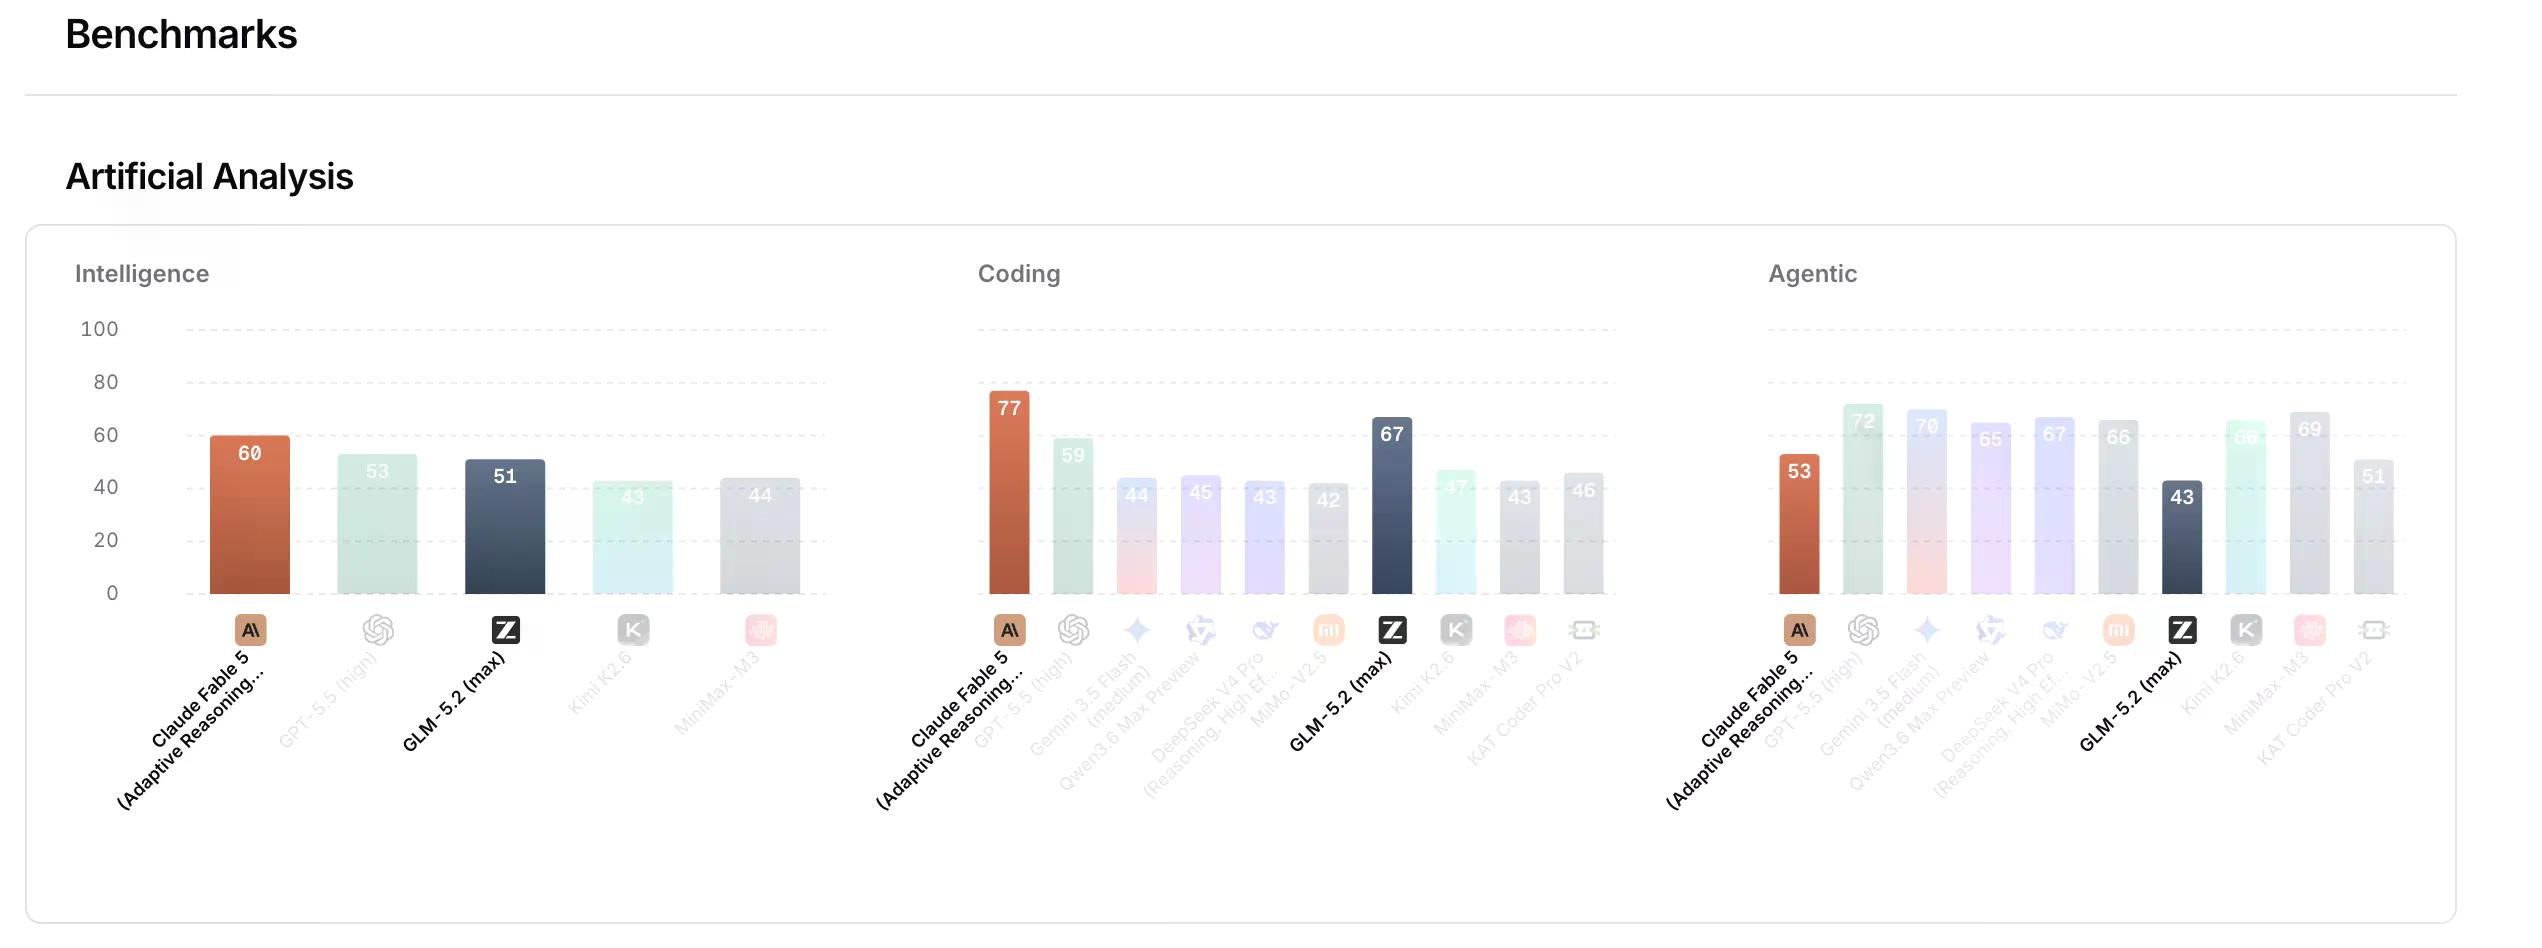
O salto de qualidade o torna o melhor modelo de código aberto até o momento no Índice de Inteligência de Análise Artificial, que agrega os resultados de 9 pontuações diferentes para avaliar a qualidade geral de um modelo de IA. Os benchmarks da OpenRouter o colocam na mesma categoria do agora banido Claude Fable 5.
O hardware utilizado para alcançar este feito é outra parte interessante da história. O GLM-5.2 foi treinado em chips Huawei Ascend—sem Nvidia em nenhuma parte do processo. Emad Mostaque, fundador da Stability AI, estimou os custos totais de treinamento em cerca de US$ 25 milhões, 80% disso em pós-treinamento, o que o tornaria extremamente barato em comparação com seus concorrentes.
Como Decrypt relatou no início deste ano, a Z.ai já estava treinando modelos de imagem nos servidores Ascend Atlas da Huawei sem um único chip americano. O GLM-5.2 leva essa infraestrutura adiante—um modelo de mistura de especialistas com 744 bilhões de parâmetros com uma janela de contexto genuína de 1 milhão de tokens, cinco vezes o limite de 200 mil do GLM-5.1, e uma licença MIT que significa que nenhuma diretriz governamental pode desativar o acesso.
Tokens são os fragmentos de texto que um modelo pode ler e gerar, enquanto Parâmetros são o número de configurações e valores internos que determinam como um modelo processa informações e gera respostas.
Para desenvolvedores, a janela de contexto é a mudança operacional. Navegação de repositório completo, refatoração de múltiplos arquivos e longos pipelines agentivos que antes exigiam segmentação tornam-se fluxos de trabalho de chamada única. Os preços da API são de US$ 1,40 por milhão de tokens de entrada e US$ 4,40 por milhão de saída—contra US$ 5 de entrada e US$ 25 de saída do Claude Opus 4.8. O Plano de Codificação começa em cerca de US$ 18 por mês e funciona diretamente dentro do Claude Code, Cline, Kilo Code e a maioria dos ambientes agentivos populares.
A implantação local também é tecnicamente possível. A Unsloth AI lançou quantizações GGUF de 2 bits que comprimem o modelo de 1,51TB para 238GB, mantendo aproximadamente 82% de precisão.
Não se empolgue muito, porém. Isso ainda significa que ele exige 256GB de memória unificada ou uma combinação correspondente de RAM/VRAM—um Mac Studio M4 Ultra com capacidade máxima ou uma workstation com uma GPU de médio porte e 256GB de RAM do sistema com descarregamento de mistura de especialistas. Ainda é muito dinheiro, mas pelo menos algo que você pode comprar e executar em sua casa se realmente quiser.
Fizemos um teste rápido, pedindo ao GLM-5.2 para construir nosso jogo padrão que mistura mecânicas de digitação com um jogo de tiro. A interface não era a mais bonita—outros modelos geraram interfaces com uma aparência mais polida, mas a experiência foi a mais variada: diferentes cenários em ondas, tipos de inimigos que mudavam, chefes aparecendo mais tarde na jogada.
Ele gerou estados de jogo mais diversos do que qualquer outra coisa que testamos para a mesma tarefa em uma configuração de zero-shot.
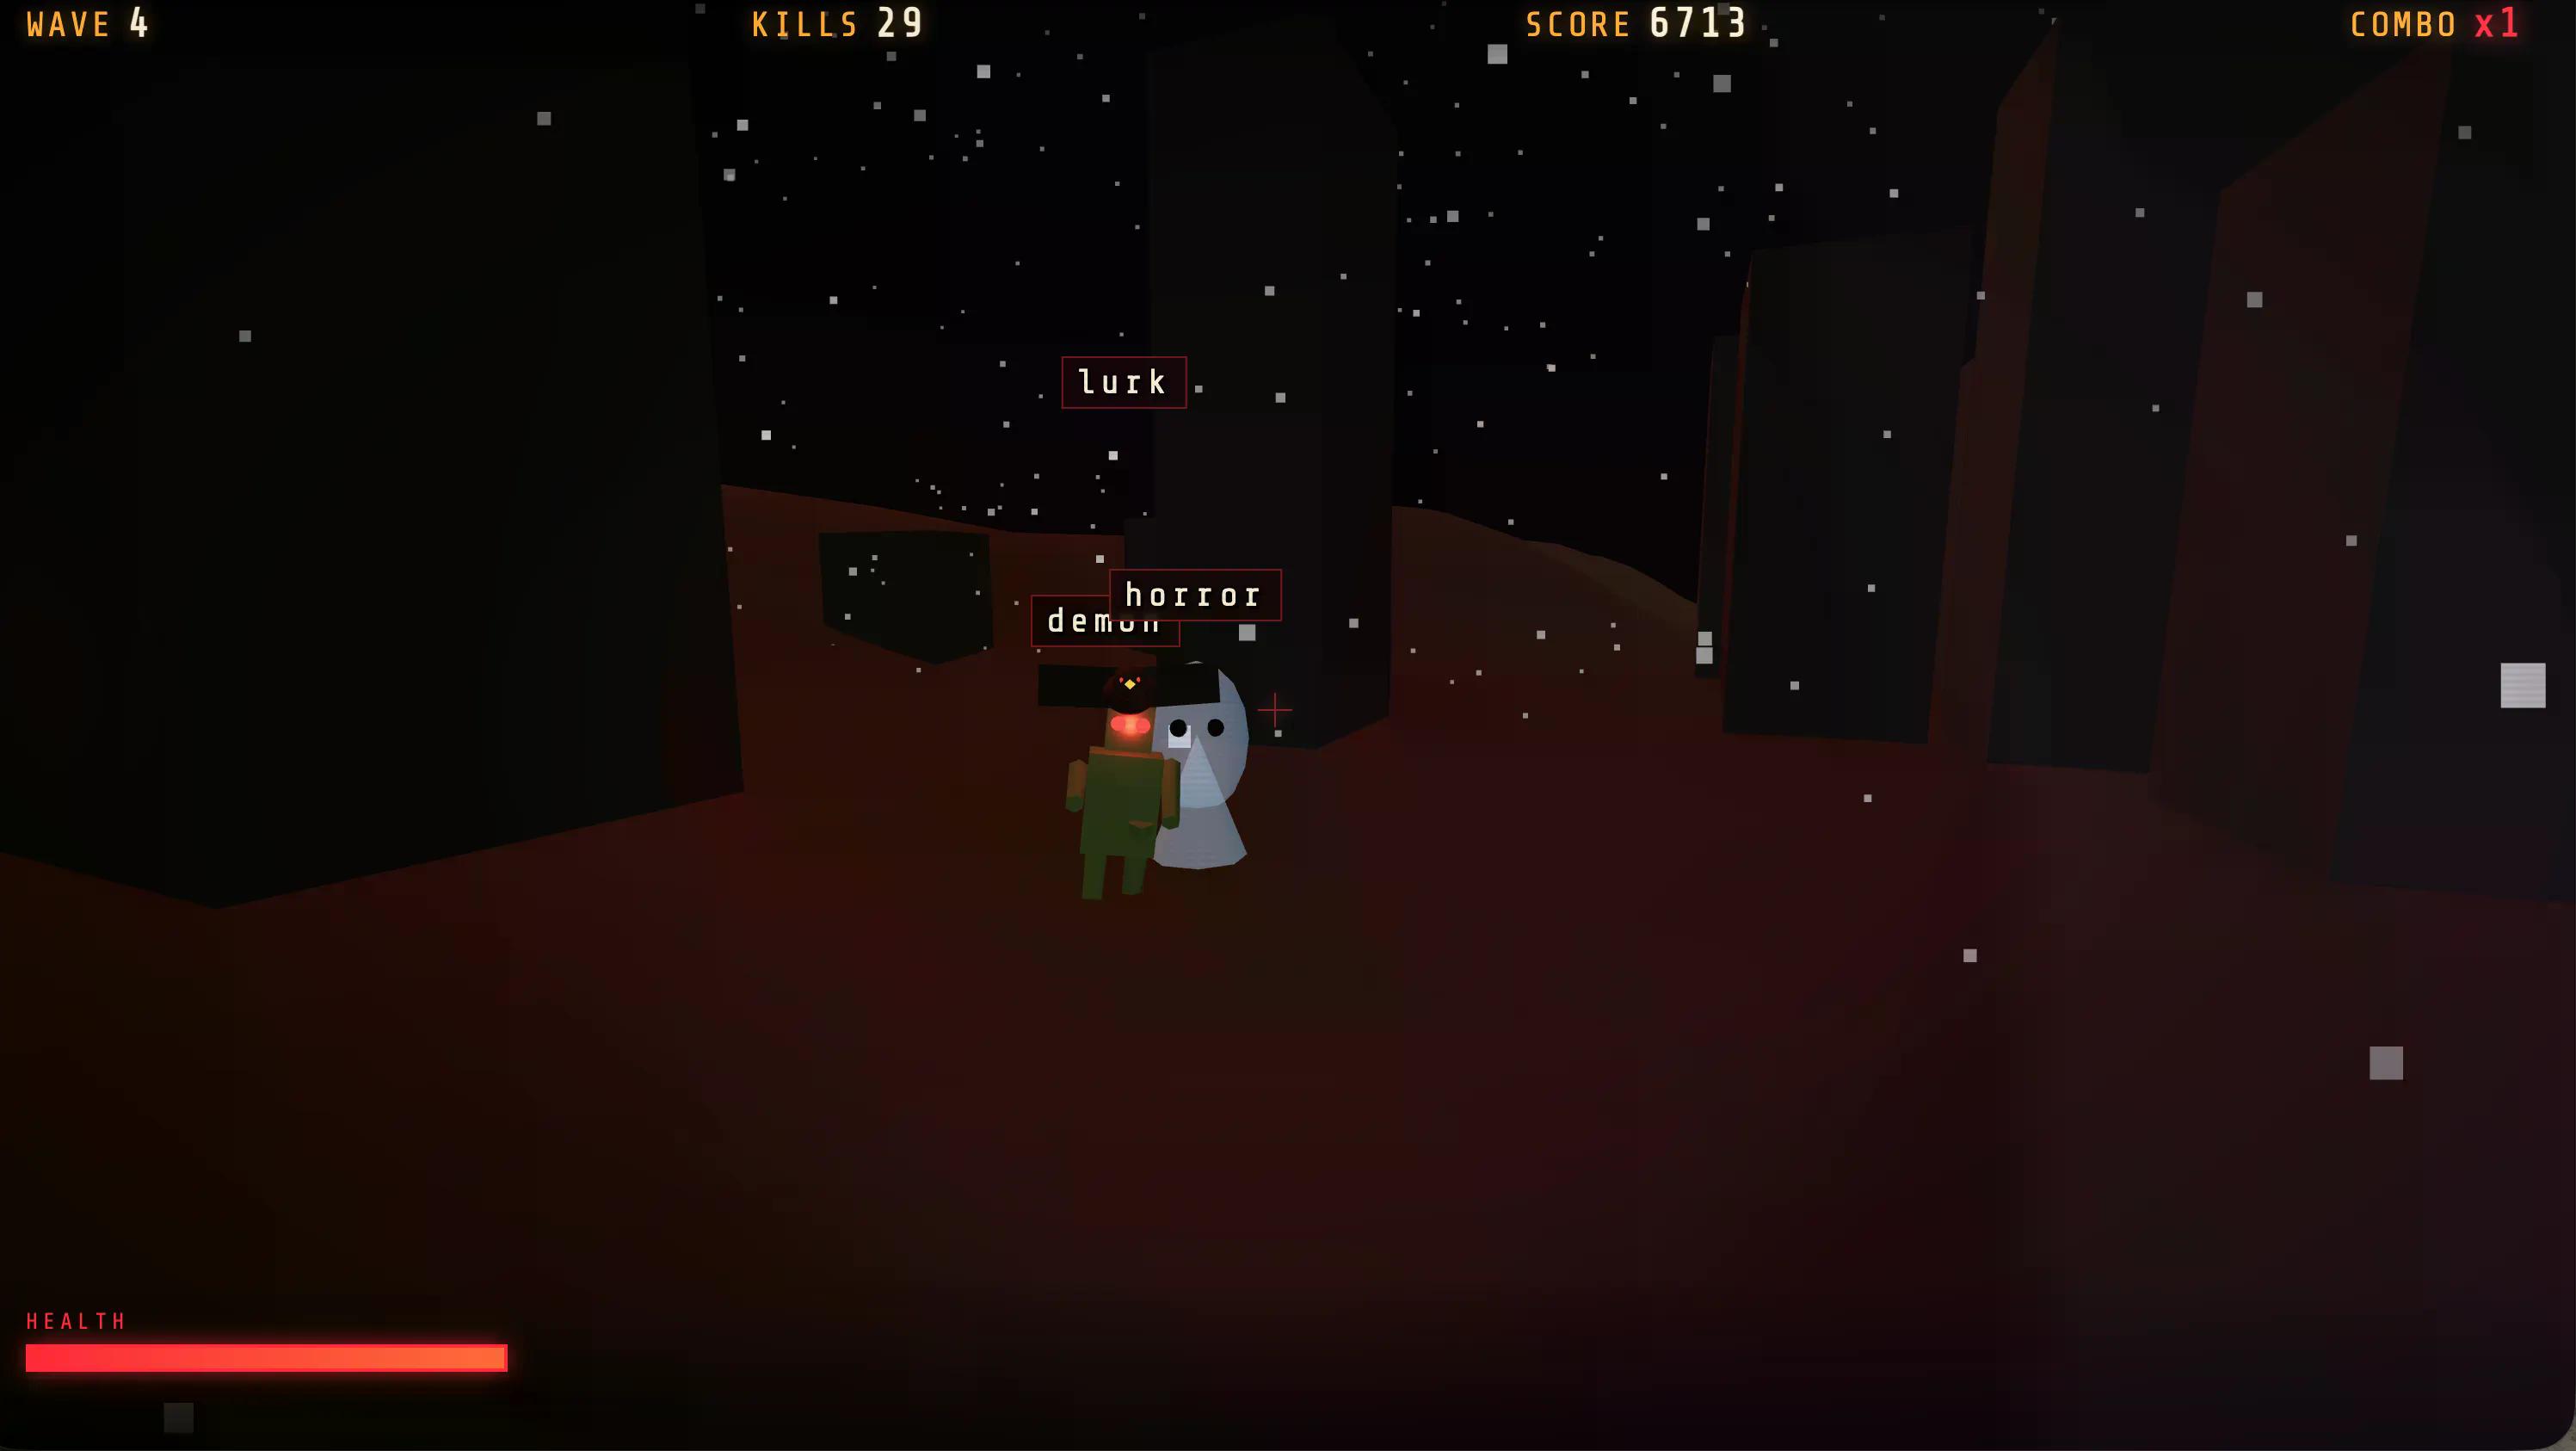
Se você quiser jogar, ele está disponível em nosso perfil do Itch.io.
Essa variação aponta para onde o GLM-5.2 faz mais sentido econômico. Para fluxos de trabalho de geração multi-shot e pipelines agentivos onde a diversidade de saída importa mais do que o polimento, a matemática nos níveis de preço de código aberto é difícil de argumentar. Para as tarefas sustentadas mais difíceis—SWE-Marathon, onde ele pontua 13.0 contra 26.0 do Opus 4.8—a lacuna para a fronteira fechada ainda é real, e de 13 pontos.
Os pesos de código aberto estão disponíveis no HuggingFace sob a licença MIT. Os pesos quantizados também estão disponíveis no HuggingFace. Os assinantes do GLM Coding Plan podem mudar agora com a string do modelo GLM-5.2, e ele também está disponível para testes gratuitos na z.AI com algumas restrições de uso.





