


xAI milik Elon Musk merilis Grok 4.7 pada Senin sore, model terbaiknya hingga saat ini, dan menyebutnya sebagai "peningkatan signifikan dibanding Grok 4.6 pada harga dan kecepatan yang sama."
Rilis ini hadir setelah beberapa penundaan yang tampak jelas. Musk setidaknya lima kali memundurkan jadwal sejak akhir Juli: "empat minggu lagi", lalu "beberapa minggu", kemudian "3 hingga 4 minggu", lalu "10 hari" pada 1 September, kemudian "butuh beberapa hari lagi untuk dimatangkan" pada 11 September.
xAI mengatakan model ini menghabiskan waktu lebih lama untuk mengerjakan persoalan sulit dan lebih sering memeriksa ulang jawabannya sendiri dibanding Grok 4.6, bersamaan dengan apa yang disebut perusahaan sebagai guardrail keamanan terkuatnya sejauh ini.
Musk kemudian menindaklanjuti di X, menyebut Grok 4.7 sebagai "kombinasi kuat antara kecerdasan, kecepatan & biaya rendah." Kali ini tidak ada daftar tunggu—model ini sudah live sekarang di aplikasi Grok, Cursor, Grok Build, dan API xAI.
Grok 4.7 hadir.
Ini merupakan peningkatan signifikan dibanding Grok 4.6 pada harga dan kecepatan yang sama. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 September 2026
Grok 4.7 mengusung 2,1 triliun parameter, naik 40% dari 1,5 triliun pada Grok 4.6, yang sendiri merupakan penyempurnaan dari Grok 4.5. Biayanya adalah $2 per satu juta token input dan $6 per satu juta token output. Parameter adalah pengaturan internal yang disesuaikan model selama pelatihan, dan jumlah yang lebih besar umumnya berarti kapasitas yang lebih tinggi untuk mempelajari pola, sementara token adalah unit dasar informasi yang dapat diproses atau dihasilkan oleh model AI.
xAI juga memasukkan data pelatihan tambahan yang diambil dari SpaceX, perusahaan roket milik Musk: telemetri satelit Starlink, catatan manufaktur, dan log kegagalan rekayasa. Nilai jualnya adalah model yang dapat bernalar lebih baik tentang hardware dan sistem fisik dibanding apa pun yang dilatih murni dari teks internet.
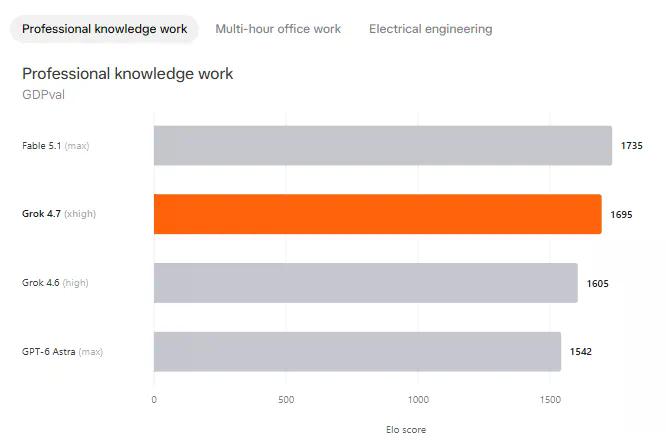
Meski begitu, skor benchmark menceritakan kisah yang familiar. GDPval mengukur bagaimana performa sebuah model pada pekerjaan pengetahuan nyata yang bernilai ekonomi—memo hukum, spreadsheet, dek presentasi—menggunakan tugas yang telah diverifikasi oleh para profesional aktif di masing-masing bidang, lalu memberinya skor dalam bentuk rating Elo, sistem peringkat head-to-head yang sama seperti di catur.
Grok 4.7 mencetak 1695 di GDPval. Claude Fable 5.1 memuncaki daftar dengan 1735.
AA-Briefcase, yang dibuat oleh Artificial Analysis, menguji pekerjaan kantor multi-jam yang merangkai riset, analisis, dan produksi dokumen menjadi satu tugas panjang, juga dinilai dengan skala Elo. Grok 4.7 mencatat 1657 berbanding 1678 milik Fable 5.1. Hasil sama, uji berbeda.
CursorBench 4.0, benchmark milik Cursor untuk tugas coding nyata di dalam editornya, memetakan akurasi terhadap biaya dan jumlah token yang dihabiskan tiap tugas. Grok 4.7 berada di tengah: biaya per tugas lebih mahal daripada penerus GPT-5.6 Sol, yakni GPT-6 Astra, dan Claude Sonnet 5, tetapi masih tertinggal dari Fable 5.1, yang unggul di setiap titik harga pada grafik.
Ini bukan pola baru bagi xAI. Grok 4.5 meluncur pada Juli dengan klaster pelatihan terbesar di industri dan skor peringkat ketiga di belakang model Claude dan OpenAI. Sebelumnya, Grok 4.20 mengorbankan reliabilitas demi kecepatan dan kepribadian. Grok 4.6 juga tertinggal dari kelompok terdepan dalam otonomi coding.
Semua ini tidak membuat Grok 4.7 menjadi produk yang buruk bagi jutaan orang yang berbicara dengannya melalui X, aplikasi standalone, atau dashboard Tesla mereka. Artinya, model yang kemungkinan besar akan menjawab pertanyaan Anda, atau menggerakkan asisten suara mobil Anda, berjalan di atas sistem yang menurut benchmark buatan perusahaannya sendiri berada satu tingkat di bawah puncak tangga.
Kesenjangan itulah yang membuat label harga lebih penting daripada posisi di leaderboard bagi kebanyakan orang. xAI secara konsisten menawarkan biaya per token yang lebih murah daripada Anthropic dan OpenAI meski tertinggal dalam kapabilitas mentah, dengan bertaruh bahwa "cukup bagus, murah, dan ada di mana-mana" akan mengalahkan "terbaik, tetapi lebih mahal" untuk sebagian besar penggunaan sehari-hari.
Musk sudah menurunkan ekspektasi beberapa hari sebelum peluncuran, dengan menulis bahwa Grok 4.7 seharusnya berada "kurang lebih setara dengan" Claude Opus 5.0 milik Anthropic, bukan Opus 5.1 yang lebih baru, sementara performa multimodal masih perlu pembenahan.
Dalam postingan yang sama, ia juga menggambarkan tiga model berikutnya: Grok 4.8 sebagai lompatan berarti, Grok 4.9 di "kelas Astra/Fable", dan Grok 5 sebagai calon pemimpin frontier. Upgrade tersebut belum memiliki tanggal rilis. "Kita lihat saja nanti," tulisnya.







