

Anthropic merilis Claude Opus 5.5 pada Selasa, model pertama dalam keluarga yang oleh perusahaan disebut sebagai lini Claude 5.5. Anthropic mengatakan model baru ini memiliki performa setara Claude Fable 5.1, model flagship termahalnya, pada sebagian besar tugas.
Yang menarik, biaya operasional model ini 20% lebih rendah dibanding Opus 5, model yang digantikannya, dan 60% lebih murah dibanding Fable 5.1, penawaran paling mutakhir dari perusahaan.
Model ini, tampaknya, sangat mumpuni. Ini adalah model paling canggih baik dari sisi versi (5.5 dibanding 5.1 milik Fable) maupun keluarga model (Opus adalah model terbesar yang tersedia untuk publik, disusul Sonnet, dengan Haiku sebagai yang paling kecil).
Anthropic mengakui selisih antara Fable dan Opus lebih sempit daripada yang ditunjukkan skor benchmark-nya, tetapi karena tersedia untuk publik dalam paket langganan dan lebih murah per token, model ini menjadi pilihan paling masuk akal bagi sebagian besar pengguna Claude.
Opus 5 diluncurkan pada Juli dengan harga lebih murah dan skor lebih tinggi daripada Fable 5 di sebagian besar benchmark, lalu Fable 5.1 hadir pada awal September dan membalik keadaan dengan mengungguli Opus 5 pada setiap benchmark yang dipublikasikan Anthropic.
Opus 5.5 kembali mempersempit jarak, kali ini dari sisi harga, bukan skor mentah. Lovable, sebuah platform pengembang yang menguji Opus 5 lewat tes coding internalnya pada Juli lalu, mengatakan dalam pernyataan yang dibagikan Anthropic bahwa model sebelumnya “lebih stabil, dengan variasi antarrun yang jauh lebih kecil” dibanding pendahulunya—narasi efisiensi yang kembali diusung Anthropic sekarang.
Opus 5.5 juga merupakan model pertama yang dirilis Anthropic sejak CEO Dario Amodei menerbitkan esai yang menyerukan agar industri melambat, dengan argumen bahwa peningkatan kapabilitas AI melaju lebih cepat daripada pengujian keselamatan yang dirancang untuk mengendalikannya. “Kita harus memperlambat laju peningkatan kapabilitas model AI,” tulis Amodei awal bulan ini.
Anthropic mengukur sebagian besar kemajuan ini melalui agentic coding—pekerjaan yang dilakukan oleh agen AI, yakni model yang dapat mengambil tindakan multilangkah secara mandiri alih-alih sekadar menjawab satu prompt.
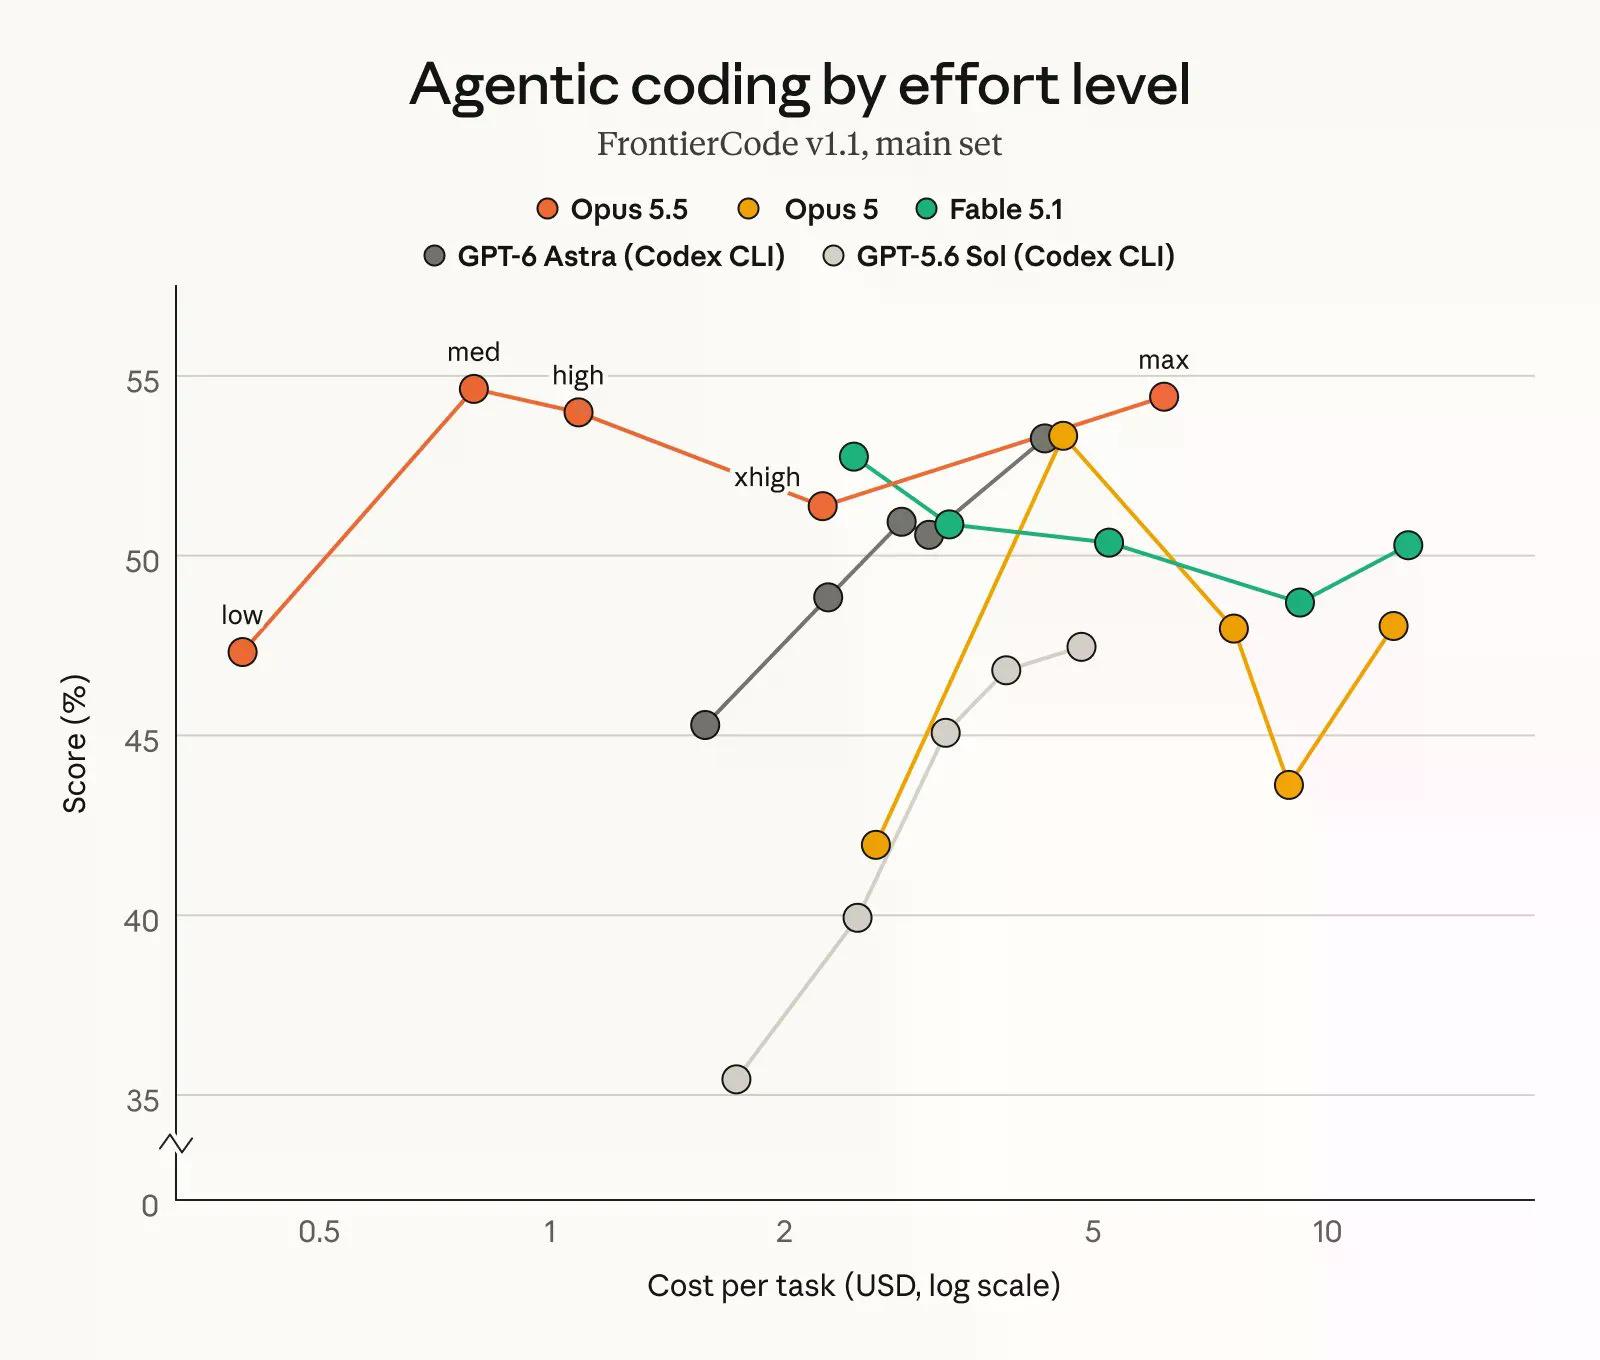
Pada Terminal-Bench 4.0, yang menguji apakah sebuah agen dapat menyelesaikan tugas profesional kompleks di dalam antarmuka command-line dan memberi skor berdasarkan persentase tugas yang berhasil diselesaikan, Opus 5.5 mencatat 66,4%, unggul atas Fable 5.1 yang mencetak 55,8% dan GPT-6 Astra di 57,9%. FrontierCode, yang memeriksa apakah perubahan kode dari sebuah agen benar-benar akan digabungkan ke pipeline engineering nyata dengan metode penilaian pass-rate yang sama, menempatkan Opus 5.5 di 54,4% dibanding Fable 5.1 di 50,3%.
Pada GDPval-AA v2.1, yang menilai pekerjaan profesional dunia nyata di 44 profesi menggunakan Elo—sistem peringkat ala catur yang dipakai untuk mengukur keterampilan relatif, bukan persentase datar—Opus 5.5 mencetak skor 1846, dibanding Fable 5.1 di 1735 dan Opus 5 di 1708.
Meski begitu, Opus 5.5 tidak unggul di semua lini. Pada AutomationBench, benchmark buatan Zapier yang menilai apakah sebuah agen dapat menjalankan alur kerja bisnis penuh dari awal hingga akhir tanpa bantuan manusia, GPT-6 Astra dengan 41,4% sedikit unggul atas Opus 5.5 yang mencetak 40,0%.
Pada Terminal-Bench-Science 0.1, yang menguji riset ilmiah agentic yang dilakukan dalam lingkungan command-line menggunakan metode pass-rate yang sama, Astra dengan 64,6% mengalahkan Opus 5.5 yang mencetak 58,7% dengan selisih yang lebih lebar.
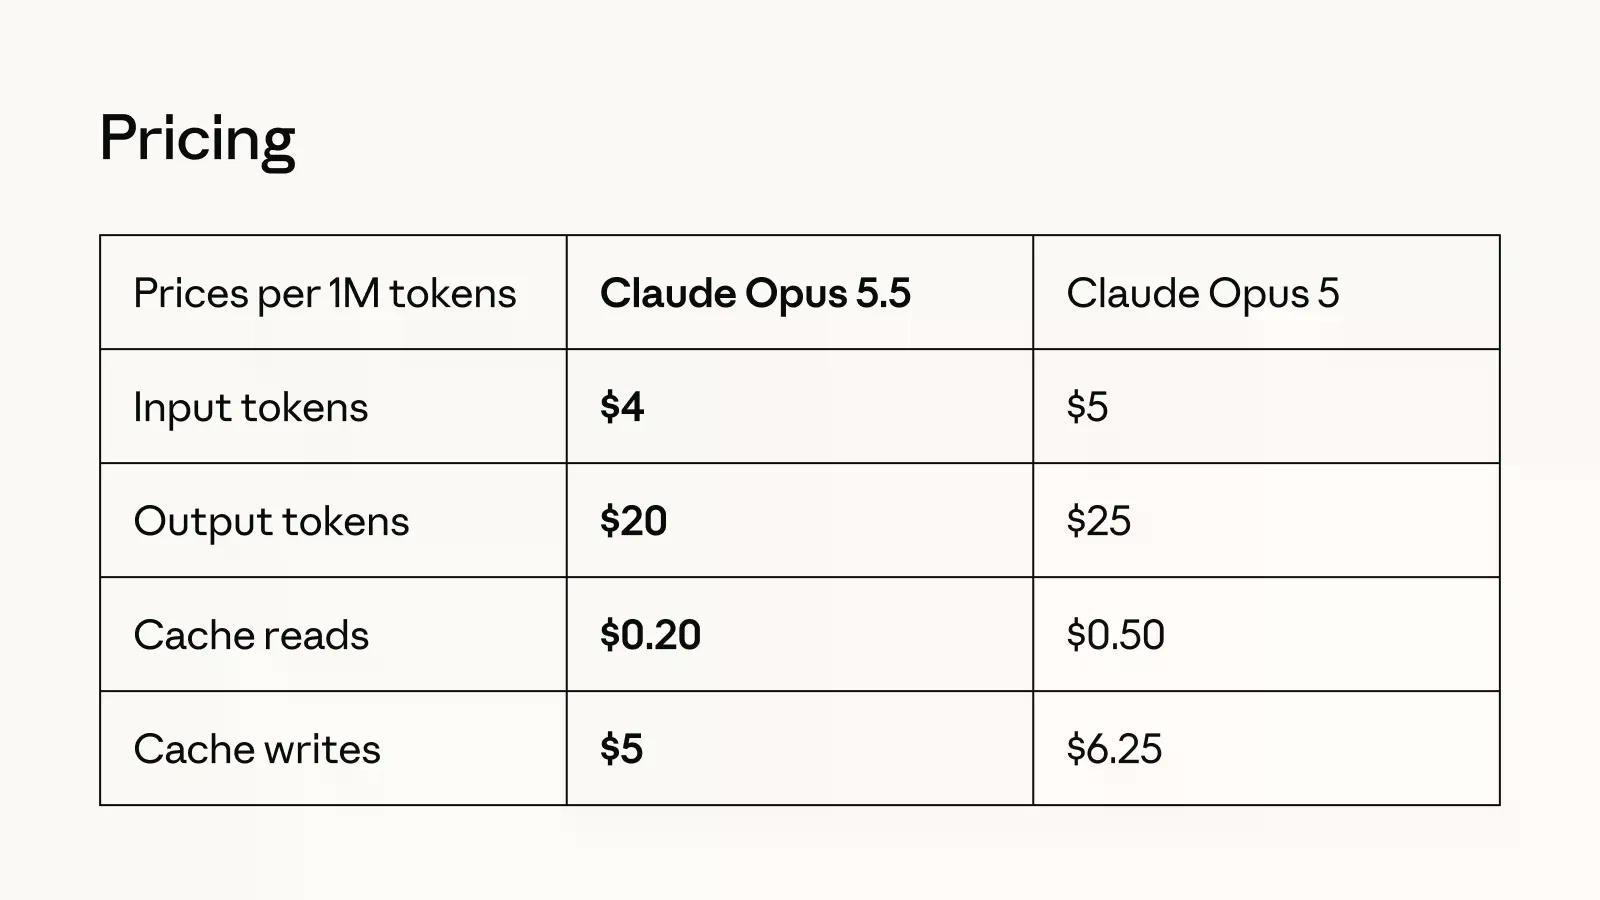
Nilai jual yang lebih besar adalah biaya. Token input—potongan teks yang dibaca dan ditulis model, dengan harga per satu juta—kini dibanderol $4 untuk Opus 5.5 dibanding $5 untuk Opus 5, sementara token output turun menjadi $20 dari sebelumnya $25. Cache read, yang berarti menggunakan ulang konteks yang sudah diproses model alih-alih memproses ulang dari nol dan menjadi pendorong utama biaya pada sesi agentic coding yang panjang, turun 60% menjadi $0,20 per satu juta token.
Karena Opus 5.5 menyamai model kelas Mythos milik Anthropic—tier paling ketat milik perusahaan, yang dicadangkan untuk peneliti keamanan siber dan biologi yang telah diverifikasi—dalam dua kapabilitas tersebut, model ini diluncurkan dengan perlindungan yang sama seperti Fable 5.1.
Sebagian besar tugas keamanan siber akan otomatis dialihkan ke Opus 4.8 yang lebih lama, sesuatu yang sebelumnya banyak dikeluhkan oleh developer dan pengguna.
Opus 5.5 kini sudah live di seluruh platform Anthropic, termasuk Amazon Web Services, Google Cloud, dan Microsoft Azure. Sonnet 5.5 dan Haiku 5.5 akan menyusul dalam beberapa pekan mendatang, kata Anthropic, dengan pemangkasan harga yang sama untuk sisa lini produknya.







