


Ini adalah akhir dari anonimitas internet seperti yang kita kenal, menurut banyak pengguna media sosial yang panik setelah baru mengetahui studi terkait AI ini hari ini.
Makalah riset yang kembali ramai beredar di X dan Reddit hari ini berasal dari studi pada Februari, dan inti temuannya membuat para akun anonim internet di mana-mana ketakutan: AI bisa mengetahui siapa Anda sebenarnya dari sebuah akun anonim.
Makalah itu berjudul "Large-scale online deanonymization with LLMs," dan berasal dari para peneliti di ETH Zurich serta grup keselamatan AI MATS, bekerja bersama Nicholas Carlini, peneliti di Anthropic, perusahaan di balik Claude.
Para peneliti mengklaim bahwa large language model, sistem AI di balik Claude, ChatGPT, dan Gemini, dapat membaca postingan anonim seseorang dan mengetahui siapa mereka di dunia nyata. Bukan dengan meretas apa pun, melainkan hanya dengan membaca, mencari, dan bernalar—hal yang sama yang sudah dilakukan chatbot ini untuk jutaan tugas membosankan setiap hari.
Para peneliti membangun AI yang bisa melakukan doxxing terhadap akun reddit "anonim" mana pun dalam waktu kurang dari satu menit dengan biaya $2.
eth zurich dan anthropic menerbitkan makalah mengerikan yang membuktikan bahwa "anonimitas praktis" di internet secara resmi sudah mati.
mereka membangun pipeline ai sepenuhnya otonom yang mengambil... pic.twitter.com/XMeXifhDf3
— Superman (@thesupermannx) 23 September 2026
“Hasil kami menunjukkan bahwa kekaburan praktis yang melindungi pengguna pseudonim secara online tidak lagi berlaku dan model ancaman terhadap privasi online perlu dipertimbangkan ulang,” tulis makalah tersebut.
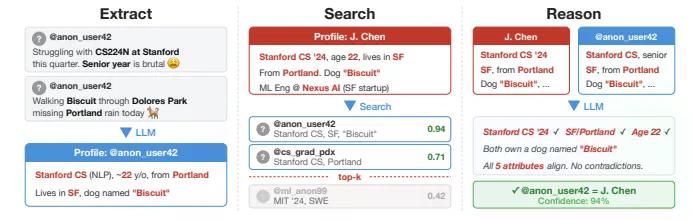
Para peneliti membagi serangan ini menjadi empat langkah yang mereka sebut Extract, Search, Reason, dan Calibrate.
“Extract” berarti memasukkan postingan seseorang ke AI dan memintanya merangkum orang tersebut: di mana mereka mungkin tinggal, pekerjaannya, hobinya, bahkan ciri kecil seperti ejaan British atau nama anjing yang disebut sekilas.
“Search” mengubah ringkasan itu menjadi embedding, yaitu rangkaian angka yang bisa digunakan komputer untuk secara instan menemukan profil yang terdengar mirip di antara ribuan kandidat.
“Reason” adalah tahap ketika model yang lebih kuat melihat beberapa kecocokan terbaik dan menimbang mana yang benar-benar sesuai, memeriksa silang detail seperti yang dilakukan penyelidik manusia, hanya saja jauh lebih cepat.
“Calibrate” membuat AI menilai tingkat keyakinannya sendiri, sehingga ia hanya menebak saat cukup yakin dan diam jika tidak.
Dalam satu pengujian, tim mengumpulkan 338 pengguna forum Hacker News yang sebagian besar menggunakan pseudonim dan pernah menautkan profil LinkedIn mereka di bio, menghapus semua hal yang mengidentifikasi, lalu meminta agen AI mencari tahu siapa mereka hanya dengan pencarian web. AI itu berhasil menyebutkan 226 dari mereka dengan benar, atau 67%, dan salah pada sekitar satu dari 10 tebakan yang benar-benar dibuatnya.
Dalam pengujian terpisah terhadap transkrip riset wawancara milik Anthropic sendiri dengan 125 ilmuwan, AI tersebut berhasil mengidentifikasi setidaknya 9 orang hanya dari cara mereka menggambarkan pekerjaan mereka.
Biaya untuk melakukan semua ini adalah temuan utama yang sebenarnya. Menjalankan satu pencarian seperti ini memerlukan biaya antara $1 hingga $4 dalam bentuk biaya langganan AI, menurut makalah tersebut.
Ini juga tidak memerlukan kebocoran data, peretasan, atau akses orang dalam. Ia menggunakan kemampuan pencarian web dan peringkasan yang sama yang sudah tertanam di chatbot biasa. Para peneliti berargumen justru itulah alasan mengapa hal ini sulit diblokir: tidak ada satu tombol “deanonimkan orang ini” yang bisa dimatikan, hanya rangkaian tugas yang secara individual terlihat tidak berbahaya.
Ini bukan pertama kalinya segelintir detail berhasil membuka identitas seseorang. Pada 2008, peneliti membobol dataset rating film Netflix yang konon anonim dengan mencocokkannya dengan ulasan IMDb yang bersifat publik. Bedanya sekarang, AI melakukan pencocokan itu pada teks yang berantakan dan tidak terstruktur—lelucon, komentar, penyebutan sambil lalu—bukan spreadsheet yang rapi, dan melakukannya secara mandiri.
Angka-angka paling menakutkan dalam makalah ini datang dengan catatan penting. Untuk mengukur keberhasilan, para peneliti membutuhkan subjek yang identitas aslinya sudah mereka ketahui, sehingga mereka memilih akun yang sebelumnya sudah menautkan LinkedIn, atau membagi riwayat posting seseorang sendiri menjadi dua bagian lalu menyembunyikan keterkaitannya.
Itu adalah pengaturan terkontrol dalam skenario terbaik, bukan bukti bahwa akun pseudonim acak mana pun bisa dibongkar hari ini.
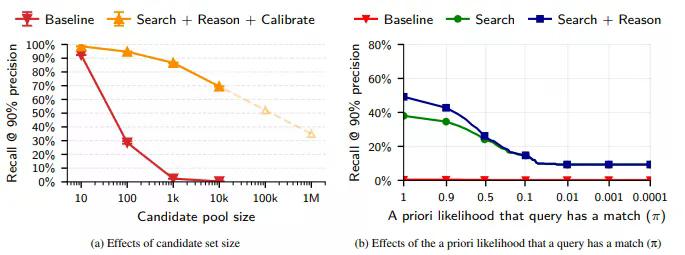
Skala juga menahan angka-angka paling mengerikan dari studi ini. Semakin besar tumpukan kandidat yang mungkin, semakin sulit menemukan jarumnya. Dengan kumpulan 89.000 kandidat, metode AI terkuat pun hanya berhasil menangkap sekitar setengah dari kecocokan yang benar pada presisi 90%. Presisi berarti seberapa sering tebakannya benar, sedangkan recall berarti seberapa banyak kecocokan nyata yang benar-benar berhasil ditemukan.
Para peneliti juga tidak memublikasikan alat, prompt, maupun nama asli siapa pun yang mereka temukan, dan studi ini melewati dewan tinjauan etika sebelum dirilis. Mereka tidak sedang membagikan kit doxxing kepada siapa pun. Mereka mendokumentasikan kapabilitas yang, menurut para penulis, sudah ada di model AI saat ini, dengan atau tanpa makalah tersebut.
Mengapa ini penting bahkan jika Anda belum pernah posting di Reddit
Pengguna kripto sudah sangat akrab dengan ketakutan ini. Gelombang doxxing dan upaya penculikan setelah kebocoran data Coinbase 2025, di antara banyak insiden lainnya, menunjukkan betapa cepat identitas yang bocor berubah menjadi alamat nyata di depan pintu seseorang.
Deanonimisasi berbasis AI adalah ancaman yang sama, hanya tanpa unsur kebocoran data: ia bekerja dari apa yang sudah Anda posting secara publik, tanpa perlu ada data yang bocor.
Ini juga muncul beberapa bulan setelah Anthropic mengungkap bahwa peretas yang didukung negara menggunakan Claude untuk menjalankan sebagian besar kampanye spionase siber secara mandiri, pengingat bahwa riset penyalahgunaan AI terus melampaui pagar pengaman yang dibuat untuk menahannya.
Bagi siapa pun yang memposting dengan pseudonim karena aktivisme, kekerasan, seksualitas, status imigrasi, atau pekerjaan yang tidak menyukai opini publik, ini berarti kota asal, pemberi kerja, bahkan nama hewan peliharaan, yang tersebar di komentar lama selama bertahun-tahun, bisa terakumulasi menjadi sidik jari identitas. Itu selalu mungkin terjadi—AI hanya membuatnya lebih cepat dan lebih murah dilakukan.
Namun jika jenis doxxing seperti itu menjadi kekhawatiran, solusinya bukan panik, melainkan kebiasaan: kurangi detail spesifik yang dapat mengidentifikasi dan terikat pada satu pseudonim, dan untuk hal-hal yang benar-benar sensitif, gunakan alat yang dirancang agar sama sekali tidak menyimpan data Anda.






 COIN

