

Inilabas ng xAI ni Elon Musk ang Grok 4.7 noong Lunes ng hapon, ang pinakamahusay nitong model hanggang sa ngayon, at tinawag itong "isang kapansin-pansing pagbuti kumpara sa Grok 4.6 sa kaparehong presyo at bilis."
Dumating ang release matapos ang ilang tila pagkaantala. Hindi bababa sa limang beses binawi ni Musk ang timeline mula noong huling bahagi ng Hulyo: "apat na linggo na lang," pagkatapos ay "ilang linggo," pagkatapos ay "3 hanggang 4 na linggo," pagkatapos ay "10 araw" noong Setyembre 1, at pagkatapos ay "kailangan pa ng ilang araw para mas maluto" noong Setyembre 11.
Ayon sa xAI, mas matagal na gumugugol ang model sa pagresolba ng mahihirap na problema at mas madalas nitong dini-double check ang sarili nitong mga sagot kaysa sa Grok 4.6, kasabay ng tinatawag ng kumpanya na pinakamatitibay nitong safety guardrails sa ngayon.
Nag-follow up si Musk sa X, at tinawag ang Grok 4.7 na "isang malakas na kumbinasyon ng intelligence, speed at mababang gastos." Wala nang waitlist sa pagkakataong ito—live na ito ngayon sa Grok app, Cursor, Grok Build, at xAI API.
Narito na ang Grok 4.7.
Isa itong kapansin-pansing pagbuti kumpara sa Grok 4.6 sa kaparehong presyo at bilis. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) Setyembre 21, 2026
May 2.1 trilyong parameters ang Grok 4.7, mas mataas ng 40% mula sa 1.5 trilyon ng Grok 4.6, na isa ring refinement ng Grok 4.5. Ang gastos ay $2 kada isang milyong input tokens at $6 kada isang milyong output tokens. Ang parameters ang mga internal na setting na ina-adjust ng isang model habang sinasanay ito, at mas marami nito ay karaniwang nangangahulugan ng mas malaking kapasidad na matuto ng mga pattern, habang ang tokens naman ang batayang yunit ng impormasyong maaaring tanggapin o buuin ng isang AI model.
Isinama rin ng xAI ang karagdagang training data mula sa SpaceX, ang rocket company ni Musk: telemetry ng Starlink satellites, manufacturing records, at engineering failure logs. Ang pangunahing pitch nito ay isang model na mas mahusay mag-reason tungkol sa hardware at pisikal na mga sistema kaysa sa anumang sinanay lamang sa internet text.
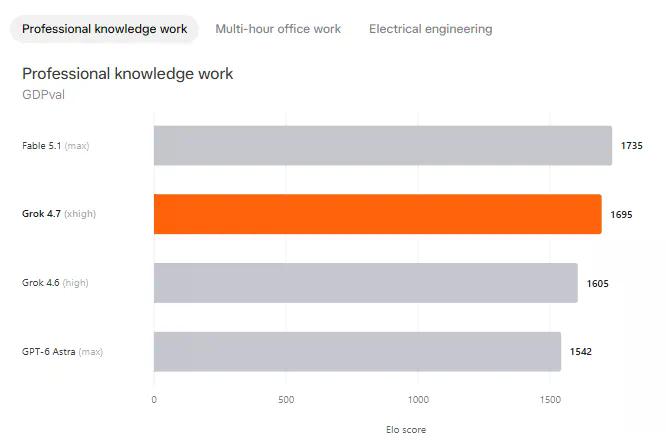
Gayunpaman, pamilyar ang kuwentong sinasabi ng mga benchmark score. Sinusukat ng GDPval kung paano nagpe-perform ang isang model sa totoong knowledge work na may ekonomikong halaga—mga legal memo, spreadsheet, slide deck—gamit ang mga gawaing beripikado ng mga propesyonal na aktibong nagtatrabaho sa bawat larangan, at binibigyan ito ng Elo rating, ang parehong head-to-head ranking system na ginagamit sa chess.
Umabot ang Grok 4.7 sa 1695 sa GDPval. Nanguna sa chart ang Claude Fable 5.1 na may 1735.
Ang AA-Briefcase, na binuo ng Artificial Analysis, ay sumusubok sa maraming oras na office work na pinagsasama ang research, analysis, at paggawa ng dokumento sa iisang mahabang task, at naka-score rin sa Elo scale. Nagtala ang Grok 4.7 ng 1657 laban sa 1678 ng Fable 5.1. Parehong resulta, ibang test lang.
Ang CursorBench 4.0, benchmark ng Cursor para sa totoong coding tasks sa loob ng editor nito, ay nagmamapa ng accuracy laban sa gastos at dami ng token na nauubos ng bawat task. Nasa gitna ang Grok 4.7: mas mahal kada task kaysa sa GPT-6 Astra, na sumunod sa GPT-5.6 Sol, at sa Claude Sonnet 5, ngunit kapos pa rin sa Fable 5.1, na nananalo sa bawat price point sa chart.
Hindi na bago ang pattern na ito para sa xAI. Inilunsad ang Grok 4.5 noong Hulyo na may pinakamalaking training cluster sa industriya at may pangatlong puwesto na scores sa likod ng Claude at mga model ng OpenAI. Bago iyon, ipinagpalit ng Grok 4.20 ang reliability kapalit ng bilis at personality. Nahuli rin ang Grok 4.6 sa frontier pack pagdating sa coding autonomy.
Wala sa mga ito ang nangangahulugang masamang produkto ang Grok 4.7 para sa milyun-milyong taong gumagamit nito sa pamamagitan ng X, standalone app, o dashboard ng kanilang Tesla. Ang ibig sabihin nito, ang model na pinakamalamang na sasagot sa iyong mga tanong, o magpapagana sa voice assistant ng iyong sasakyan, ay tumatakbo sa sistemang ayon mismo sa benchmarks ng gumawa nito ay isang baitang sa ibaba ng pinakatuktok.
Ang agwat na iyon ang dahilan kung bakit mas mahalaga ang presyo kaysa posisyon sa leaderboard para sa karamihan ng tao. Palagiang mas mababa ang singil ng xAI kaysa Anthropic at OpenAI sa cost per token kahit na nahuhuli ito sa raw capability, dahil tumataya ito na ang "sapat na maganda, mura, at nasa lahat ng lugar" ay mas mananaig kaysa "pinakamahusay, pero mas mahal" para sa karamihan ng pang-araw-araw na gamit.
Ibina na ni Musk ang expectations ilang araw bago ang launch, at isinulat na ang Grok 4.7 ay dapat na maging "halos kapantay" ng Claude Opus 5.0 ng Anthropic, hindi ng mas bagong Opus 5.1, habang kailangan pa ring pagbutihin ang multimodal performance.
Sa parehong post, inilatag niya ang susunod na tatlong model: ang Grok 4.8 bilang isang makabuluhang hakbang pataas, ang Grok 4.9 sa "Astra/Fable class," at ang Grok 5 bilang posibleng frontier leader. Wala pang release date ang mga upgrade na iyon. “Titingnan natin,” ang isinulat niya.







