Mag-sign upMag-sign up
Deposito
Kumonekta
 Paglipat
Ang OpenDesign, ang kumpanyang nasa likod ng benchmark site na OpenDesign Arena, ay nagpatakbo ng 13 AI models sa parehong batch ng mga design task ngayong linggo. Ang nangunguna ay ang GPT-6 Astra ng OpenAI. Ngunit ang pinakabagong modelo ng DeepSeek, ang V4.1 Flash, ay umabot sa 98% ng pinakamataas na score na iyon habang naniningil ng humigit-kumulang 1.4% ng pinakamataas na presyo.
Binibigyan ng puntos ng OpenDesign Arena ang mga modelo sa pang-araw-araw na gawaing disenyo—pagbuo ng mga web app, dashboard, mobile screen, at landing page—mula sa 100 puntos. Tatlumpu sa mga puntos na iyon ang sumusuri kung ang output ay talagang tumutugma sa brief; ang natitirang 70 ay nagmamarka ng kalidad ng disenyo sa layout, hierarchy, kulay, at pagiging angkop ng estilo.
Ito ay binuo upang sagutin ang isang mas tiyak na tanong kaysa sa karaniwang itinatanong ng karamihan sa mga AI leaderboard: Aling modelo ang dapat na gamitin ng isang nagtatrabahong web designer bukas.
Sa sukatan na iyon, ang GPT-6 Astra ay nag-average ng 82.7 puntos, kumukuha ng 11.1 minuto at $1.61 bawat natapos na disenyo. Ang DeepSeek V4.1 Flash ay nakakuha ng 81.2, natapos ang trabaho sa 5.3 minuto, at nagkakahalaga ng $0.023. Ang Claude Fable 5.1 ay nakakuha ng 80.3, kinuha ang 12.8 minuto, at nagkakahalaga ng $3.66.
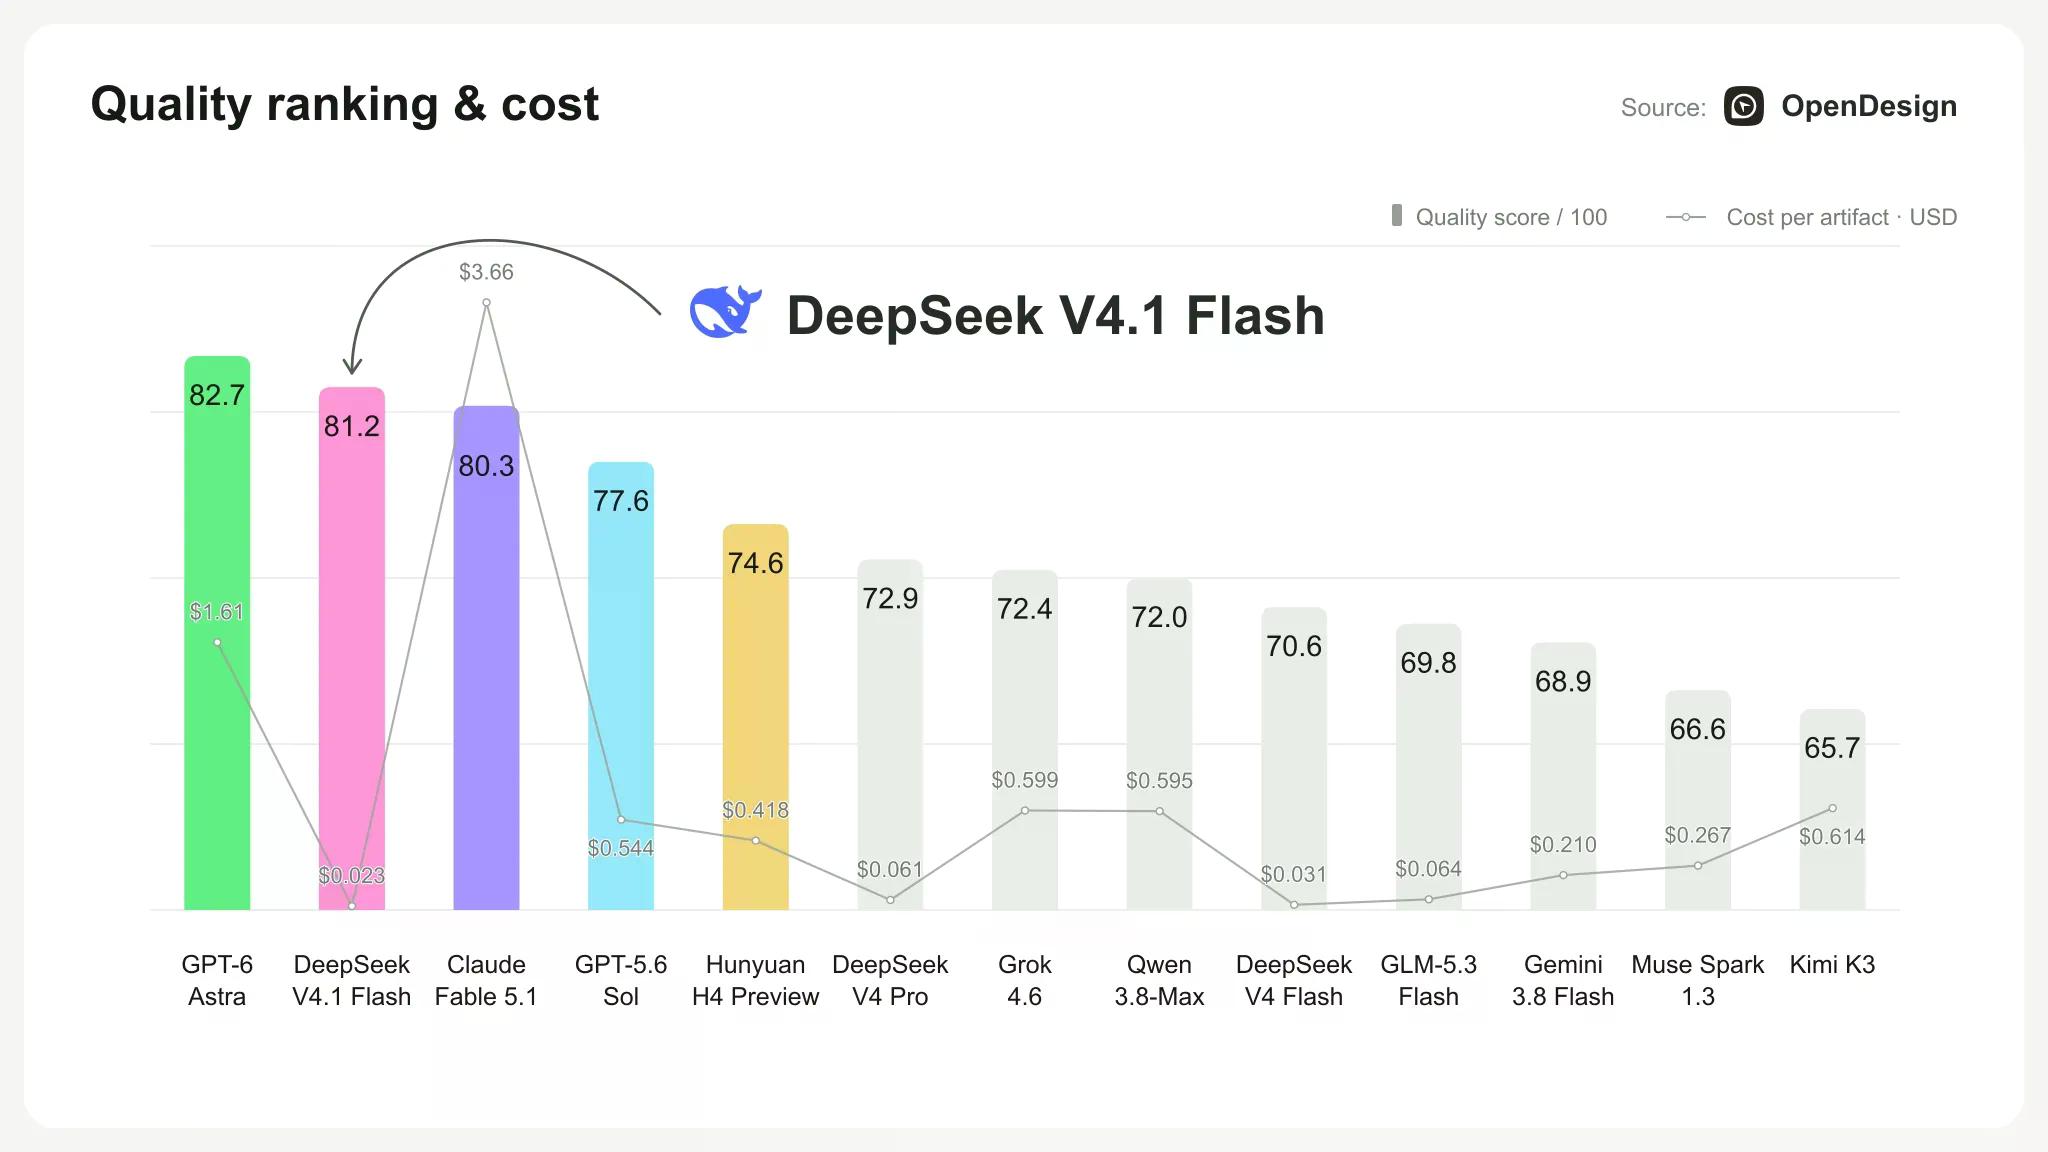
Bawat iba pang modelong sinubukan ng OpenDesign—Grok 4.6, Qwen 3.8-Max, Kimi K3, GLM-5.3 Flash, at Gemini 3.8 Flash kabilang sa mga ito—ay nakakuha ng mas mababang marka kaysa sa DeepSeek V4.1 Flash at mas mahal ang patakbuhin. Iyon ay 11 sa 13 modelong sinubukan. Tanging ang GPT-6 Astra lamang ang nakatalo dito, at sa isang punto at kalahati lamang.
Ipinaliwanag ng teknikal na ulat ng DeepSeek para sa V4.1 Flash kung saan nagmumula ang pagtitipid. Ang modelo ay may kabuuang 552 bilyong parameters—ang panloob na mga setting na inaayos ng isang modelo sa panahon ng pagsasanay upang itago ang natutunan nito—ngunit nagigising lamang ng 8 bilyon sa mga ito upang basahin ang isang papasok na prompt at 16 bilyon upang isulat ang tugon. Tinatawag ito ng DeepSeek na isang Causal Encoder-Decoder design, at ito ang parehong trick sa likod ng mabilis na oras ng pagkumpleto ng modelo.
Hindi ito ang unang pagtatangka ng DeepSeek na isara ang agwat ng kakayahan sa murang halaga. Ilang linggo bago nito, ang modelong V4 Pro ng kumpanya ay lumapag sa loob ng 5% ng Claude Fable 5 sa isang hiwalay na paghahambing ng benchmark habang naniningil ng isang bahagi ng rate ng Fable. Nagre-recruit din ang DeepSeek ng mga inhinyero sa Beijing upang buuin ang sarili nitong Code Harness, na naglalayong pagmamay-ari ang buong agentic stack sa halip na magbigay lamang ng modelo sa ilalim nito.
Pinapaliit ng pagsubok ng OpenDesign kung ano ang mapapatunayan ng mga numerong ito. Ang output ng isang modelo ay makakapuntos lamang kung ito ay nagre-render bilang isang gumaganang webpage sa una; anumang blangko, sira, o putol ay makakakuha ng zero at hindi na susubukan muli. Nangangahulugan iyon na sinusukat ng benchmark ang maaasahan, pang-araw-araw na output ng disenyo, hindi ang pangkalahatang pangangatwiran o kasanayan sa coding.
Ang GPT-6 Astra, na inilabas ng OpenAI noong Setyembre 3, ay may reputasyon na sa paggawa ng iba't ibang bagay—pag-layout ng circuit board, pagbalangkas ng tax return, pagbuo ng 3D scene—ngunit itinuring ng mga naunang tagasubok na mas mahina itong manunulat kaysa sa modelong pinalitan nito. Ang presyo at bilis nito sa tsart ng OpenDesign ay akma sa parehong pangkalahatang disenyo: mas mabagal at mas mahal kaysa sa mas murang entry ng DeepSeek, ngunit ito pa rin ang pinakamataas na nakakuha ng marka sa larangan.
Ang delivery rate ng DeepSeek V4.1 Flash—ang bahagi ng mga output na itinuring ng OpenDesign na handa nang ibigay nang walang rebisyon—ay umabot sa 57.7%. Ang delivery rate ng GPT-6 Astra ay 60%. Ang Claude Fable 5.1 ay 56.7%.