

Inilabas ng Anthropic ang Claude Opus 5.5 noong Martes, ang unang modelo sa tinatawag ng kumpanya na Claude 5.5 family. Ayon sa Anthropic, ang bagong modelong ito ay gumaganap sa antas ng Claude Fable 5.1, ang pinakamahal nitong flagship, sa karamihan ng mga gawain.
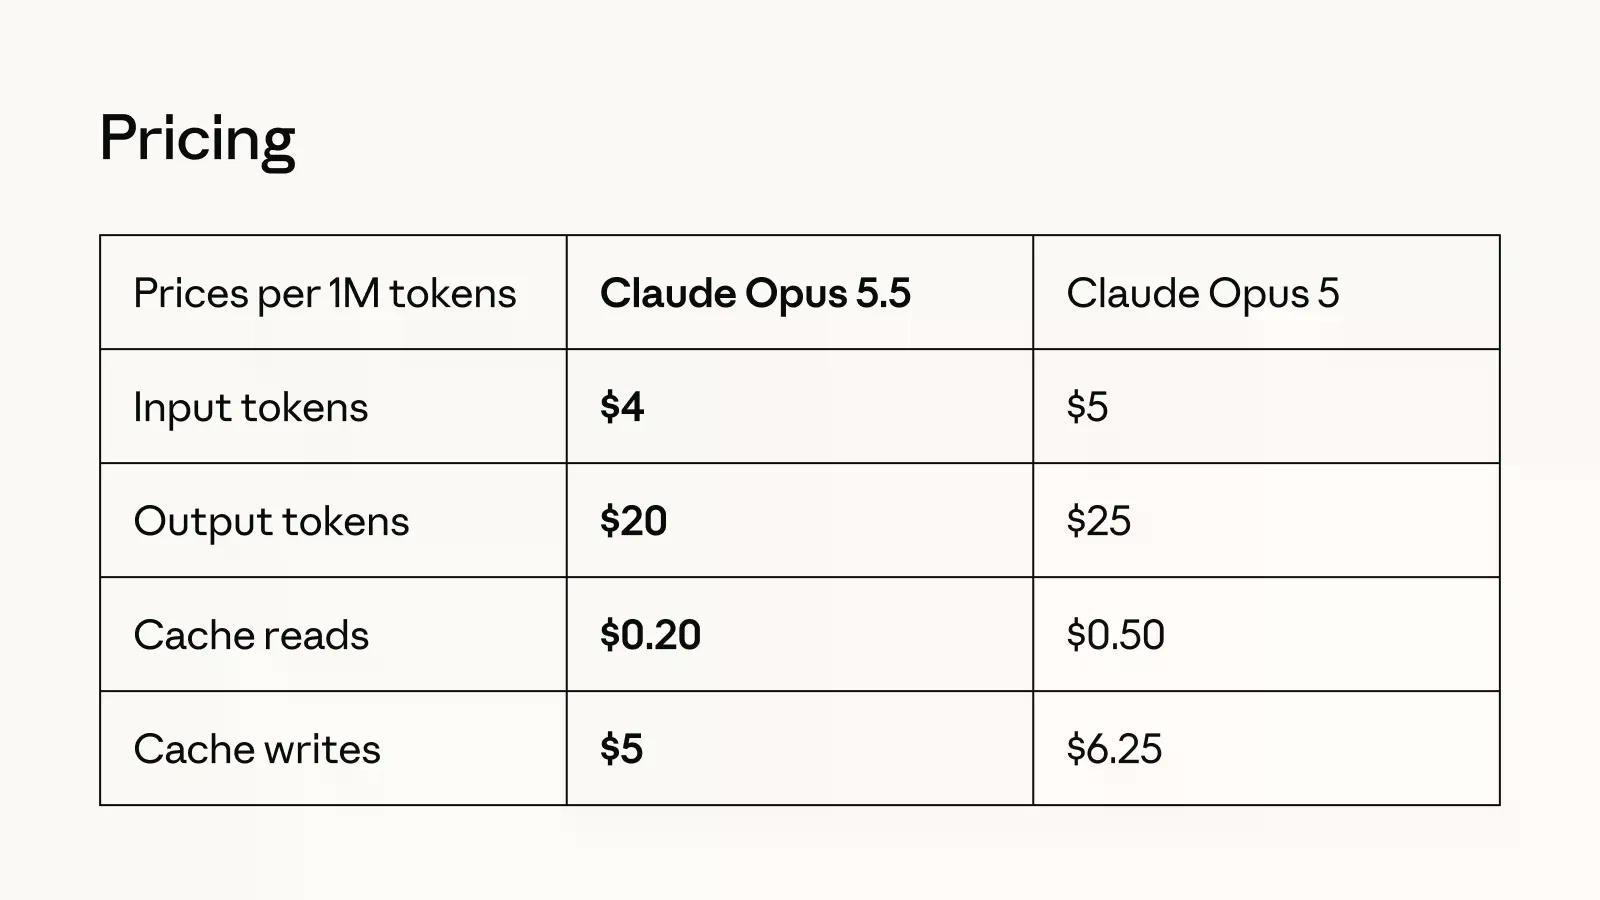
Ang pinaka-kakaiba rito ay 20% na mas mababa ang gastos sa pagpapatakbo nito kumpara sa Opus 5, ang modelong pinapalitan nito, at 60% din itong mas mura kaysa Fable 5.1, ang pinaka-advanced na alok ng kumpanya.
Mukhang napakalakas ng modelong ito. Ito ang pinaka-advanced na modelo kapwa sa bersyon (5.5 kumpara sa 5.1 ng Fable) at sa family nito (ang Opus ang pinakamalaking modelong available sa publiko, kasunod ang Sonnet, habang ang Haiku ang pinakamaliit).
Inaamin ng Anthropic na mas makitid ang agwat sa pagitan ng Fable at Opus kaysa ipinahihiwatig ng benchmark scores nito, ngunit dahil publicly available ito sa plan at mas mura kada token, malinaw na ito ang pinaka-lohikal na piliin para sa karamihan ng mga gumagamit ng Claude.
Inilunsad ang Opus 5 noong Hulyo na mas mura at mas mataas ang marka kaysa Fable 5 sa karamihan ng benchmarks, at dumating ang Fable 5.1 noong unang bahagi ng Setyembre at binaligtad iyon, tinalo ang Opus 5 sa bawat benchmark na inilathala ng Anthropic.
Muling pinaliliit ng Opus 5.5 ang agwat, ngunit sa pagkakataong ito ay sa presyo imbes na sa raw scores. Ang Lovable, isang developer platform na sumubok sa Opus 5 gamit ang sarili nitong coding tests noong Hulyo, ay nagsabi sa isang pahayag na ibinahagi ng Anthropic na ang naunang modelo ay “mas steady, na may mas mababang variance sa bawat run” kumpara sa mga nauna rito—ang parehong efficiency pitch na muling itinutulak ngayon ng Anthropic.
Ang Opus 5.5 rin ang unang modelong inilabas ng Anthropic mula nang maglathala si CEO Dario Amodei ng isang sanaysay na nananawagan sa industriya na maghinay-hinay, iginiit na ang pag-angat ng kakayahan ng AI ay mas mabilis kaysa sa safety testing na dapat sana’y pumipigil dito. “Kailangan nating pabagalin ang bilis ng pagpapahusay natin sa mga kakayahan ng AI models,” isinulat ni Amodei nitong unang bahagi ng buwan.
Sinusukat ng Anthropic ang karamihan ng pag-unlad na ito sa pamamagitan ng agentic coding—trabahong isinasagawa ng isang AI agent, isang modelong nagsasagawa ng maraming hakbang nang kusa sa halip na simpleng sumagot lang sa iisang prompt.
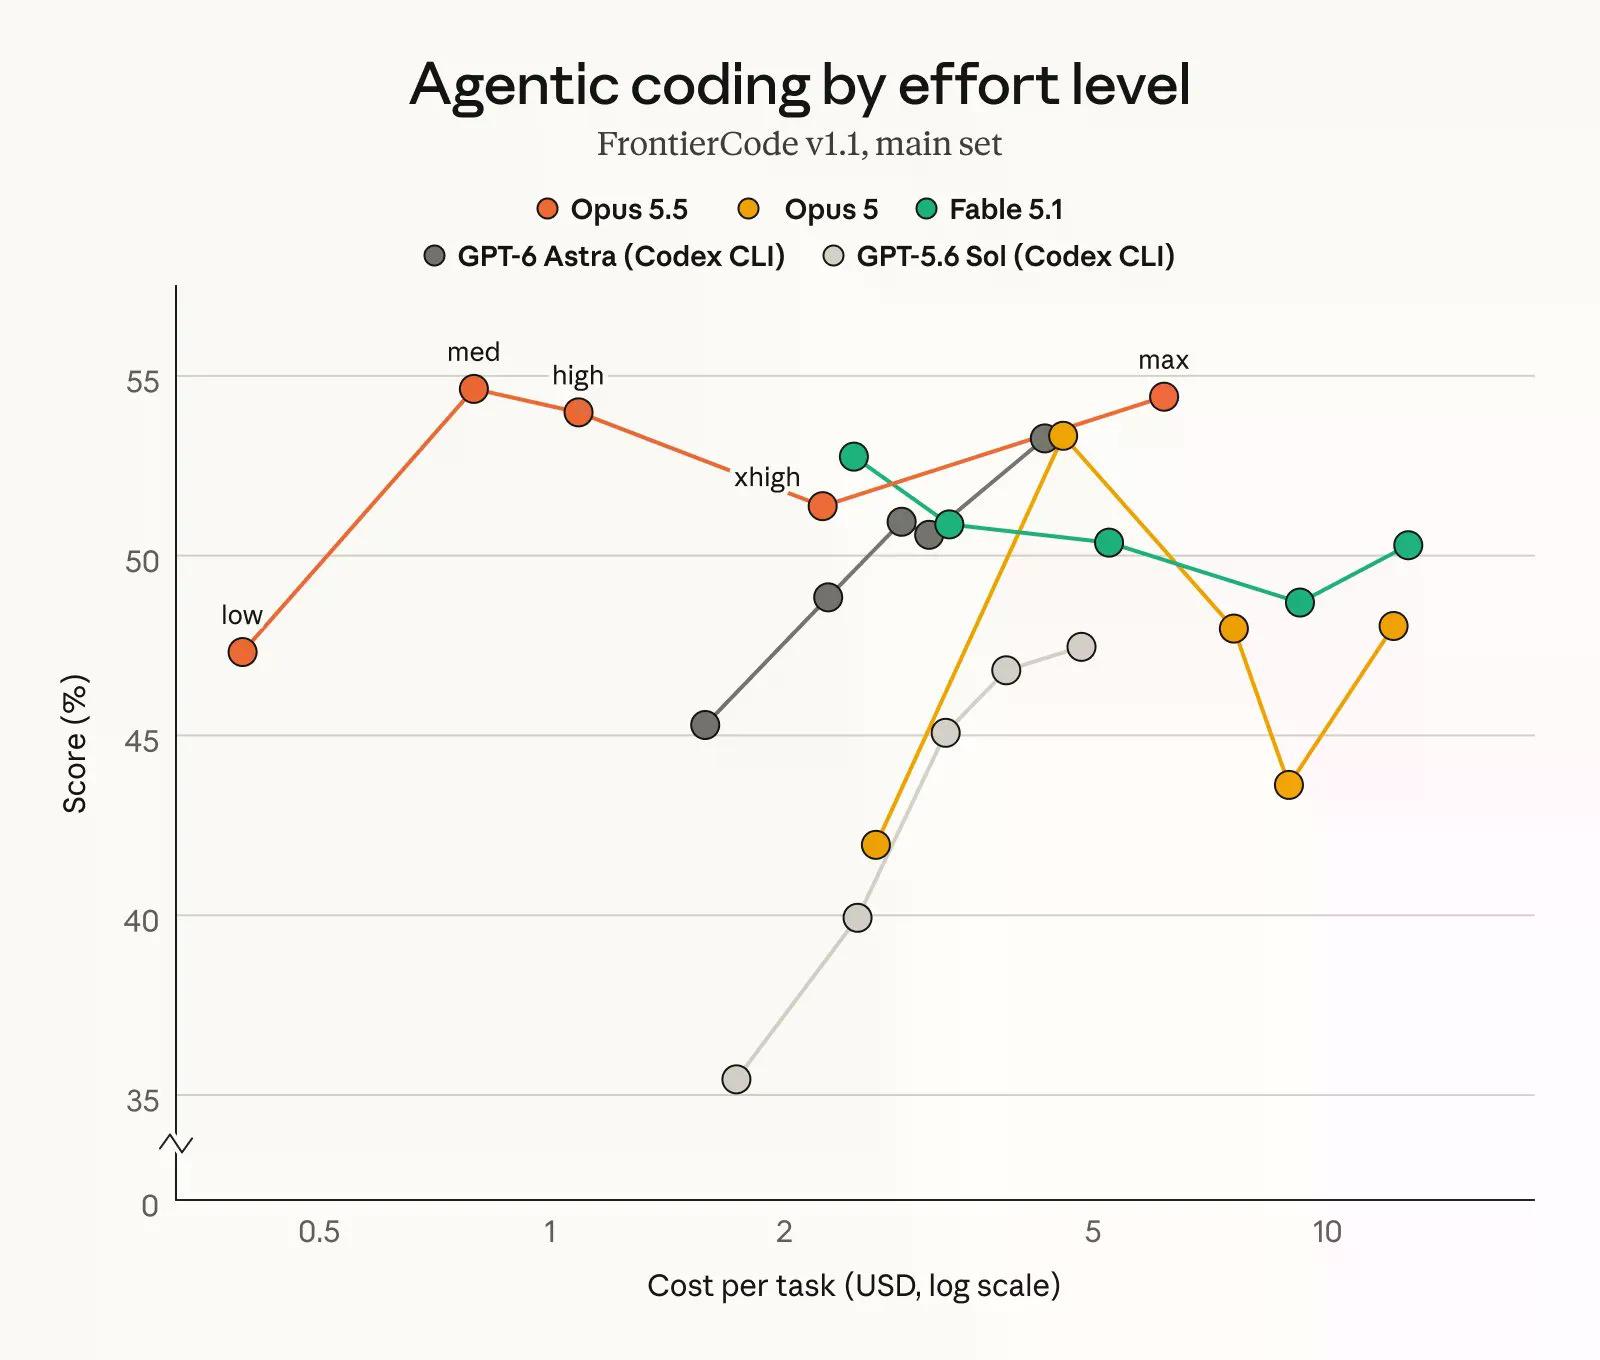
Sa Terminal-Bench 4.0, na sumusubok kung kayang tapusin ng isang agent ang komplikadong propesyonal na gawain sa loob ng isang command-line interface at nagmamarka batay sa porsiyento ng mga natapos na task, umabot ang Opus 5.5 sa 66.4%, mas mataas sa 55.8% ng Fable 5.1 at 57.9% ng GPT-6 Astra. Sa FrontierCode, na sumusuri kung ang mga pagbabago sa code ng isang agent ay talagang maa-merge sa isang totoong engineering pipeline gamit ang kaparehong pass-rate scoring, umiskor ang Opus 5.5 ng 54.4% kumpara sa 50.3% ng Fable 5.1.
Sa GDPval-AA v2.1, na sumusukat sa totoong propesyonal na trabaho sa 44 na okupasyon gamit ang Elo—ang kaparehong chess-style ranking system na ginagamit para sukatin ang relatibong husay sa halip na simpleng porsiyento—umiskor ang Opus 5.5 ng 1846 kumpara sa 1735 ng Fable 5.1 at 1708 ng Opus 5.
Gayunman, hindi nangunguna ang Opus 5.5 sa lahat ng sukatan. Sa AutomationBench, isang benchmark na binuo ng Zapier na sumusukat kung kayang kumpletuhin ng isang agent ang buong business workflow mula simula hanggang dulo nang walang tulong ng tao, bahagyang lamang ang 41.4% ng GPT-6 Astra sa 40.0% ng Opus 5.5.
Sa Terminal-Bench-Science 0.1, na sumusubok sa agentic scientific research na isinasagawa sa loob ng isang command-line environment gamit ang kaparehong pass-rate method, mas malinaw ang lamang ng Astra na 64.6% laban sa 58.7% ng Opus 5.5.
Ang mas malaking selling point ay ang gastos. Ang input tokens—mga piraso ng text na binabasa at sinusulat ng isang modelo, na pinipresyuhan kada milyon—ay nagkakahalaga na ngayon ng $4 para sa Opus 5.5 kumpara sa $5 para sa Opus 5, at bumaba ang output tokens sa $20 mula $25. Ang cache reads, na nangangahulugang muling paggamit ng context na naproseso na ng modelo sa halip na iproseso itong muli mula sa simula at siyang bumubuo sa malaking bahagi ng gastos sa mahahabang agentic coding sessions, ay bumaba ng 60% tungo sa $0.20 kada milyong token.
Dahil kapantay ng Opus 5.5 ang mga Mythos-class model ng Anthropic—ang pinaka-restricted na tier ng kumpanya, na nakalaan para sa mga na-verify na cybersecurity at biology researchers—sa dalawang kakayahang iyon, inilulunsad ito na may kaparehong safeguards gaya ng Fable 5.1.
Karamihan sa mga cybersecurity task ay awtomatikong nirere-route sa mas lumang Opus 4.8, isang bagay na dati nang inireklamo ng maraming devs at users.
Live na ngayon ang Opus 5.5 sa iba’t ibang platform ng Anthropic, kabilang ang Amazon Web Services, Google Cloud, at Microsoft Azure. Susunod sa mga darating na linggo ang Sonnet 5.5 at Haiku 5.5, ayon sa Anthropic, at dadalhin din ng mga ito ang kaparehong price cuts sa natitirang lineup.






