


xAI, la firma de Elon Musk, lanzó Grok 4.7 el lunes por la tarde, su mejor modelo hasta la fecha, y lo describió como "una mejora notable frente a Grok 4.6 al mismo precio y velocidad".
El lanzamiento llega tras varios aparentes retrasos. Musk aplazó el calendario al menos cinco veces desde finales de julio: "faltan cuatro semanas", luego "unas pocas semanas", después "de 3 a 4 semanas", más tarde "10 días" el 1 de septiembre, y finalmente "necesita unos días más de cocción" el 11 de septiembre.
xAI afirma que el modelo dedica más tiempo a resolver problemas complejos y verifica sus propias respuestas con más frecuencia que Grok 4.6, junto con lo que la compañía describe como sus controles de seguridad más sólidos hasta ahora.
Musk amplió luego el anuncio en X, calificando a Grok 4.7 como "una sólida combinación de inteligencia, velocidad y bajo costo". Esta vez no hay lista de espera: ya está disponible en la app de Grok, Cursor, Grok Build y la API de xAI.
Grok 4.7 ya está aquí.
Es una mejora notable frente a Grok 4.6 al mismo precio y velocidad. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 de septiembre de 2026
Grok 4.7 incorpora 2,1 billones de parámetros, un aumento del 40% frente a los 1,5 billones de Grok 4.6, que a su vez era un refinamiento de Grok 4.5. Los costos son de 2 dólares por millón de tokens de entrada y 6 dólares por millón de tokens de salida. Los parámetros son los ajustes internos que un modelo calibra durante el entrenamiento, y una mayor cantidad suele implicar más capacidad para aprender patrones, mientras que los tokens son la unidad básica de información que un modelo de IA puede procesar o generar.
xAI también incorporó datos de entrenamiento suplementarios extraídos de SpaceX, la compañía aeroespacial de Musk: telemetría de satélites Starlink, registros de manufactura y bitácoras de fallos de ingeniería. La propuesta es un modelo que razona mejor sobre hardware y sistemas físicos que cualquier otro entrenado únicamente con texto de internet.
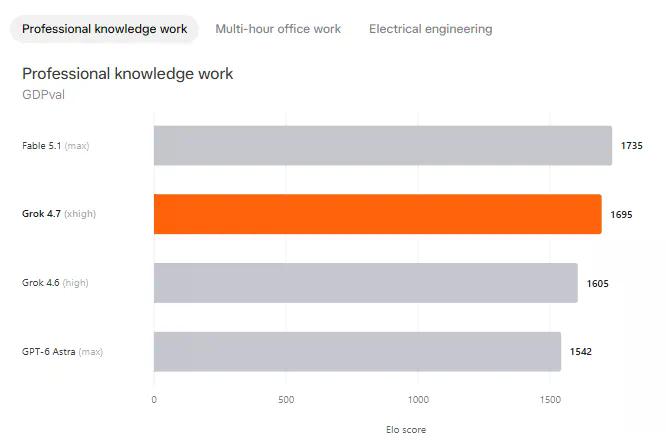
Dicho eso, los resultados en benchmarks cuentan una historia conocida. GDPval mide cómo se desempeña un modelo en trabajo de conocimiento real y económicamente valioso —memorandos legales, hojas de cálculo, presentaciones— usando tareas validadas por profesionales en activo de cada sector, y lo puntúa con una calificación Elo, el mismo sistema de ranking cara a cara que usa el ajedrez.
Grok 4.7 obtuvo 1695 en GDPval. Claude Fable 5.1 encabezó la tabla con 1735.
AA-Briefcase, desarrollado por Artificial Analysis, evalúa trabajo de oficina de varias horas que encadena investigación, análisis y producción documental en una sola tarea larga, también puntuado en la escala Elo. Grok 4.7 registró 1657 frente a los 1678 de Fable 5.1. Mismo resultado, prueba distinta.
CursorBench 4.0, el benchmark de Cursor para tareas reales de programación dentro de su editor, traza la precisión frente al costo y la cantidad de tokens que consume cada tarea. Grok 4.7 queda en la mitad: más caro por tarea que GPT-6 Astra, sucesor de GPT-5.6 Sol, y que Claude Sonnet 5, pero todavía por debajo de Fable 5.1, que gana en todos los niveles de precio del gráfico.
Este no es un patrón nuevo para xAI. Grok 4.5 se lanzó en julio con el mayor clúster de entrenamiento de la industria y puntuaciones de tercer lugar, por detrás de Claude y de los modelos de OpenAI. Antes de eso, Grok 4.20 sacrificó fiabilidad a cambio de velocidad y personalidad. Grok 4.6 también quedó rezagado frente al grupo de vanguardia en autonomía para programación.
Nada de esto convierte a Grok 4.7 en un mal producto para los millones de personas que interactúan con él a través de X, la app independiente o el panel de control de su Tesla. Lo que significa es que el modelo con más probabilidades de responder a tus preguntas, o de impulsar el asistente de voz de tu auto, corre sobre un sistema que, según los propios benchmarks de su fabricante, está un peldaño por debajo de la cima.
Esa brecha explica por qué, para la mayoría, el precio importa más que la posición en la clasificación. xAI ha mantenido de forma consistente precios por token inferiores a los de Anthropic y OpenAI, incluso quedando por detrás de ellos en capacidad bruta, apostando a que "suficientemente bueno, barato y en todas partes" vence a "el mejor, pero más caro" para la mayor parte del uso cotidiano.
Musk ya había rebajado las expectativas días antes del lanzamiento, al escribir que Grok 4.7 debería ubicarse "más o menos a la par" de Claude Opus 5.0 de Anthropic, no del más reciente Opus 5.1, y que el rendimiento multimodal aún necesita trabajo.
En esa misma publicación esbozó los próximos tres modelos: Grok 4.8 como un avance significativo, Grok 4.9 en la "clase Astra/Fable", y Grok 5 como un posible líder de frontera. Esas actualizaciones aún no tienen fecha de lanzamiento. "Ya veremos", escribió.







