

Anthropic lanzó Claude Opus 5.5 el martes, el primer modelo de lo que la compañía denomina su familia Claude 5.5. Anthropic asegura que el nuevo modelo rinde al nivel de Claude Fable 5.1, su buque insignia más costoso, en la mayoría de las tareas.
La novedad es que el modelo cuesta 20% menos de ejecutar que Opus 5, el modelo al que reemplaza, y es 60% más barato que Fable 5.1, la oferta más avanzada de la compañía.
Al parecer, el modelo es muy capaz. Es el modelo más avanzado tanto por versión (5.5 frente al 5.1 de Fable) como por familia (Opus es el modelo más grande disponible públicamente, seguido por Sonnet, mientras que Haiku es el más pequeño).
Anthropic admite que la brecha entre Fable y Opus es más estrecha de lo que sugieren sus puntuaciones de benchmark, pero al estar disponible públicamente en plan y ser más barato por token, se convierte en la opción obvia para la mayoría de los usuarios de Claude.
Opus 5 se lanzó en julio con un precio más bajo y mejores resultados que Fable 5 en la mayoría de los benchmarks, y Fable 5.1 llegó a principios de septiembre y revirtió esa situación, superando a Opus 5 en todos los benchmarks publicados por Anthropic.
Opus 5.5 vuelve a cerrar la brecha, esta vez en precio más que en puntuaciones brutas. Lovable, una plataforma para desarrolladores que sometió a Opus 5 a sus propias pruebas de programación en julio, dijo en una declaración compartida por Anthropic que el modelo anterior era "más estable, con mucha menos variación de una ejecución a otra" que lo que existía antes; el mismo argumento de eficiencia que Anthropic vuelve a presentar ahora.
Opus 5.5 también es el primer modelo que Anthropic lanza desde que el CEO Dario Amodei publicara un ensayo pidiendo a la industria que baje el ritmo, argumentando que las mejoras en capacidades de IA están superando las pruebas de seguridad destinadas a mantenerlas bajo control. "Debemos ralentizar el ritmo al que mejoramos las capacidades de los modelos de IA", escribió Amodei a principios de este mes.
Anthropic mide la mayor parte de este progreso a través de la programación agéntica: trabajo realizado por un agente de IA, un modelo que ejecuta acciones de varios pasos por sí solo en lugar de limitarse a responder a un único prompt.
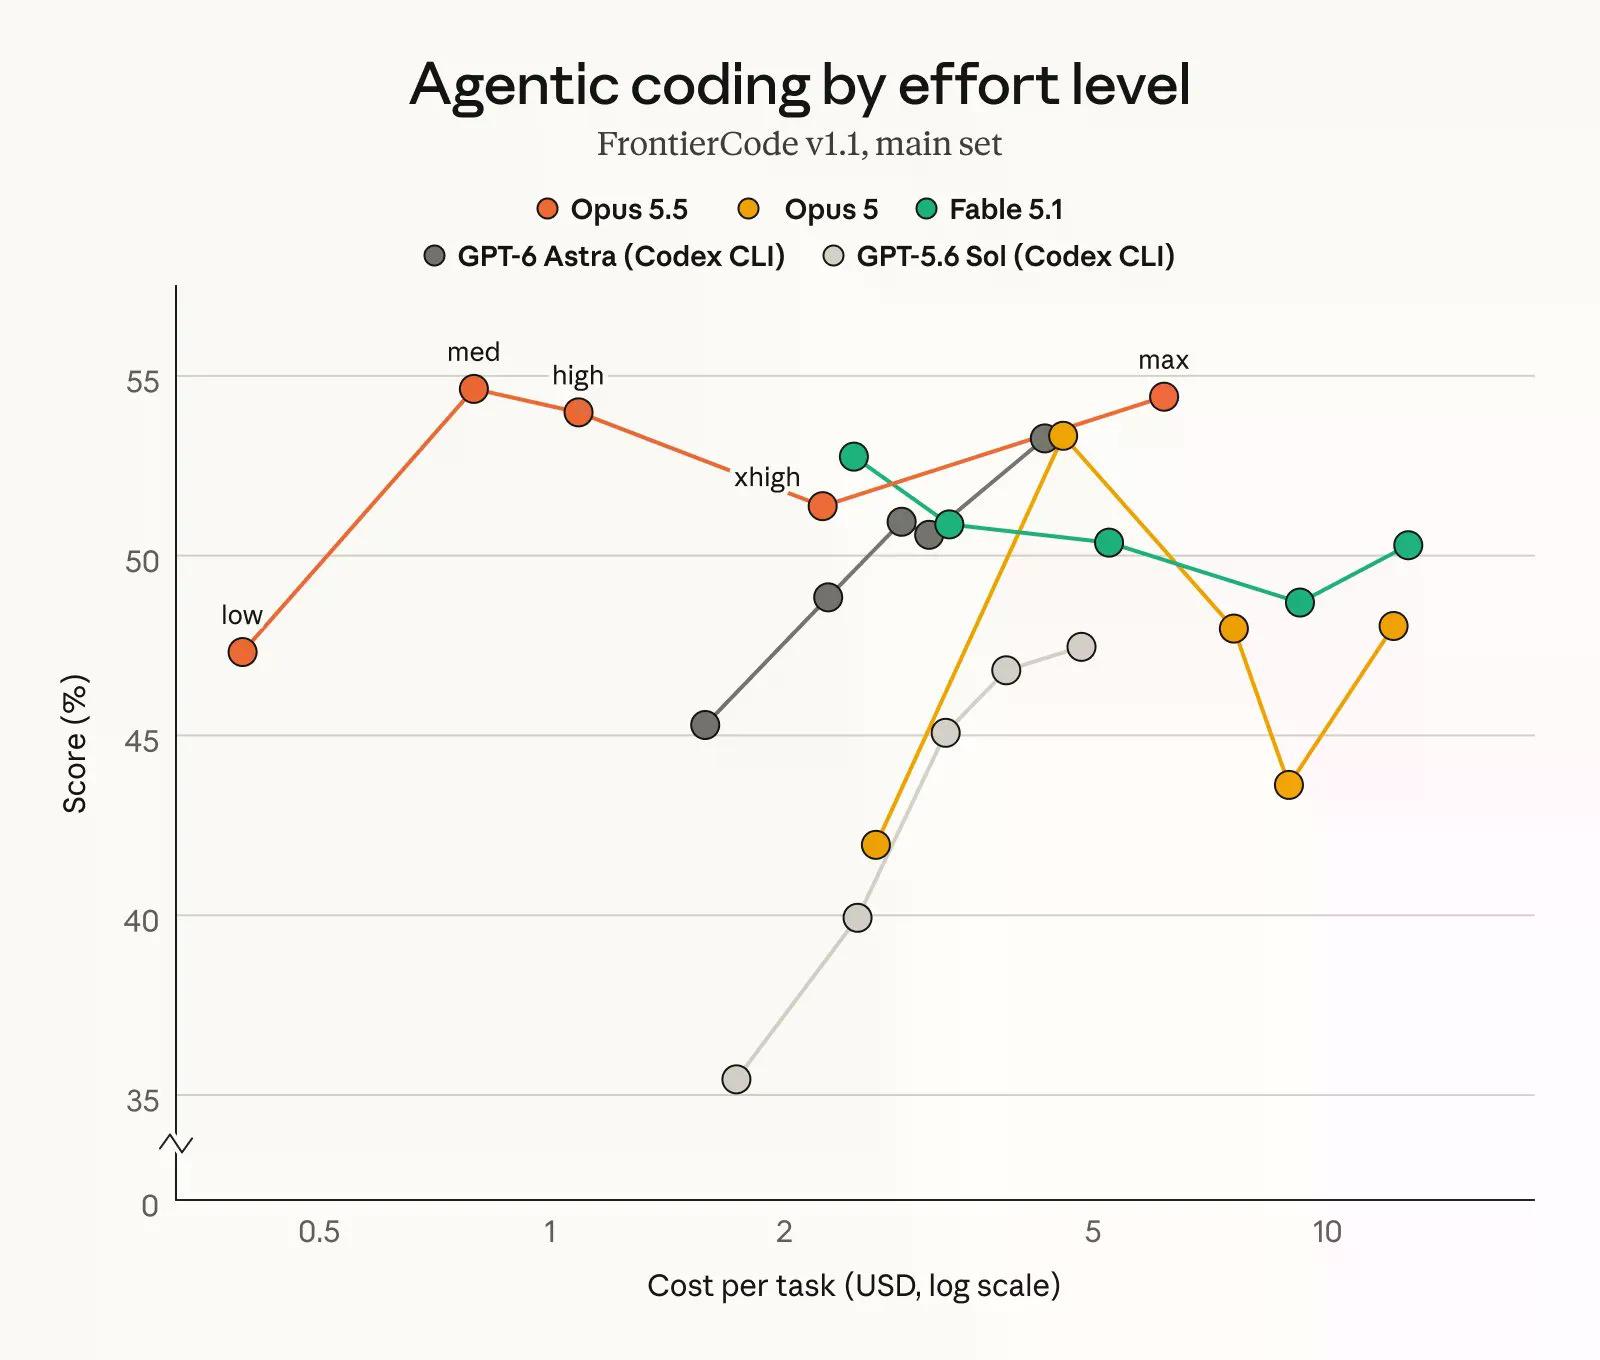
En Terminal-Bench 4.0, que evalúa si un agente puede completar tareas profesionales complejas dentro de una interfaz de línea de comandos y puntúa el resultado como porcentaje de tareas completadas, Opus 5.5 alcanzó 66.4%, por delante del 55.8% de Fable 5.1 y del 57.9% de GPT-6 Astra. FrontierCode, que verifica si los cambios de código de un agente realmente se fusionarían en un pipeline de ingeniería real usando esa misma métrica de tasa de aprobación, situó a Opus 5.5 en 54.4% frente al 50.3% de Fable 5.1.
En GDPval-AA v2.1, que califica trabajo profesional del mundo real en 44 ocupaciones utilizando Elo —el mismo sistema de clasificación estilo ajedrez usado para medir habilidad relativa en lugar de un porcentaje fijo—, Opus 5.5 obtuvo 1846 frente a los 1735 de Fable 5.1 y los 1708 de Opus 5.
Sin embargo, Opus 5.5 no lidera en todo. En AutomationBench, un benchmark desarrollado por Zapier que mide si un agente puede ejecutar un flujo de trabajo empresarial completo de principio a fin sin ayuda humana, el 41.4% de GPT-6 Astra supera por poco el 40.0% de Opus 5.5.
En Terminal-Bench-Science 0.1, que evalúa investigación científica agéntica realizada dentro de un entorno de línea de comandos usando el mismo método de tasa de aprobación, el 64.6% de Astra supera al 58.7% de Opus 5.5 por un margen más amplio.
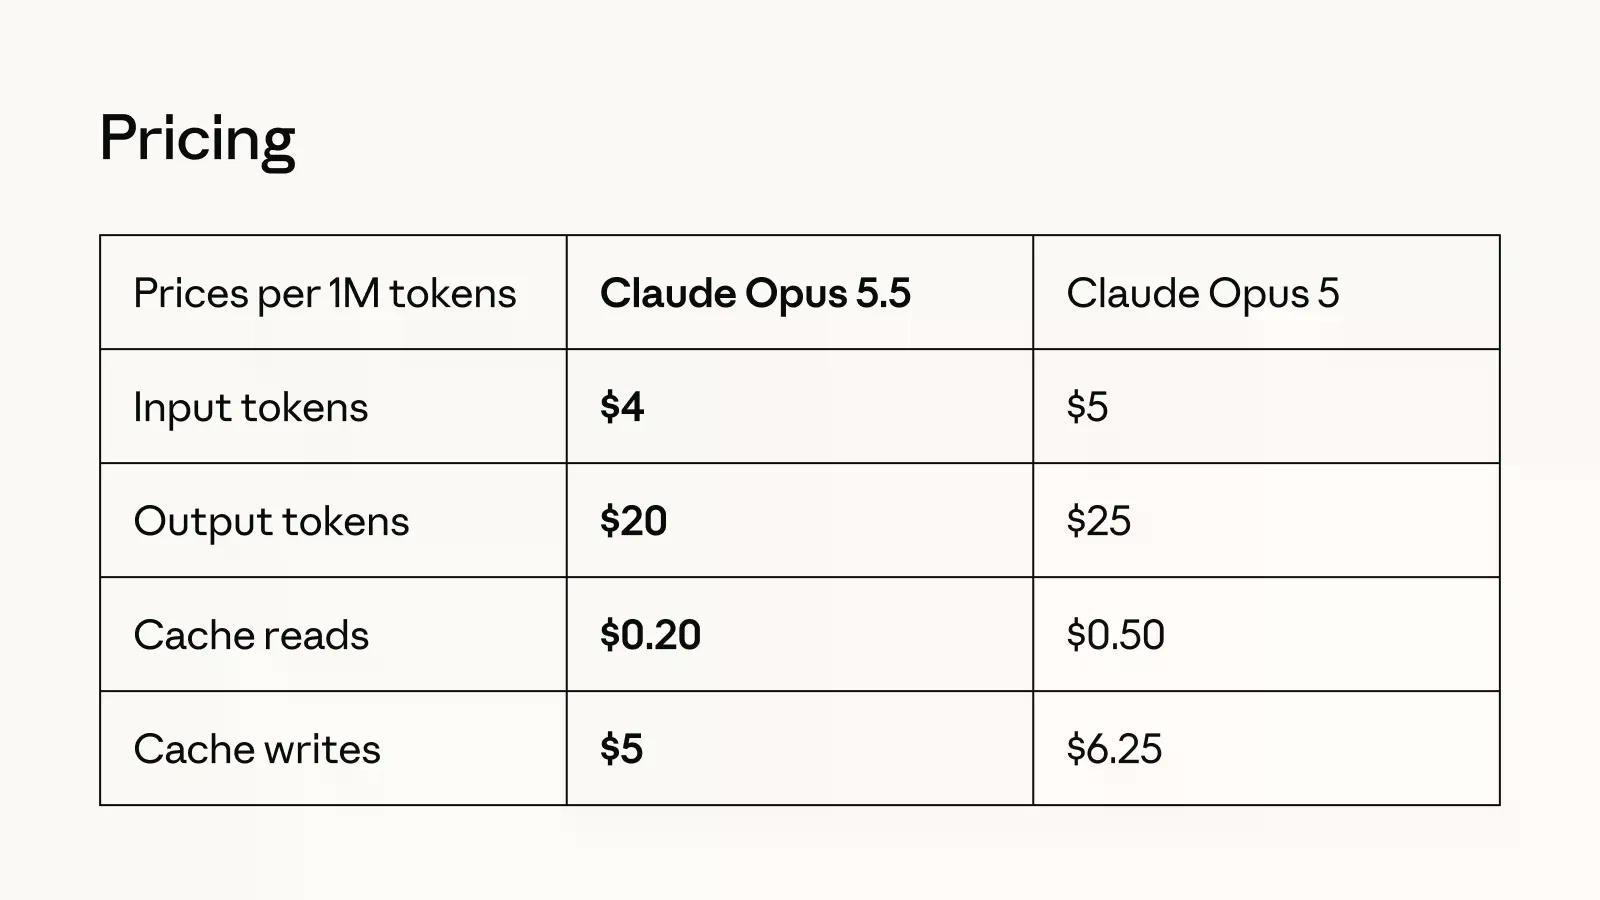
El argumento de venta más fuerte es el costo. Los tokens de entrada —los fragmentos de texto que un modelo lee y escribe, con precio por millón— ahora cuestan $4 para Opus 5.5 frente a $5 para Opus 5, y los tokens de salida bajan de $25 a $20. Las lecturas de caché, que implican reutilizar contexto que un modelo ya procesó en lugar de volver a procesarlo desde cero y que representan la mayor parte del costo en sesiones largas de programación agéntica, caen 60% hasta $0.20 por millón de tokens.
Debido a que Opus 5.5 iguala a los modelos de clase Mythos de Anthropic —el nivel más restringido de la compañía, reservado para investigadores verificados en ciberseguridad y biología— en esas dos capacidades, se lanza con las mismas salvaguardas que Fable 5.1.
La mayoría de las tareas de ciberseguridad se redirigen automáticamente al anterior Opus 4.8, algo de lo que muchos desarrolladores y usuarios ya se habían quejado previamente.
Opus 5.5 ya está disponible en todas las plataformas de Anthropic, incluidas Amazon Web Services, Google Cloud y Microsoft Azure. Sonnet 5.5 y Haiku 5.5 llegarán en las próximas semanas, según Anthropic, con los mismos recortes de precio para el resto de la gama.







