

أطلقت أنثروبيك Claude Opus 5.5 يوم الثلاثاء، وهو أول نموذج ضمن ما تسميه الشركة عائلة Claude 5.5. وتقول أنثروبيك إن النموذج الجديد يقدّم أداءً بمستوى Claude Fable 5.1، وهو منتجها الرئيسي الأعلى سعرًا، في معظم المهام.
لكن المفارقة أن تشغيل النموذج أقل تكلفة بنسبة 20% مقارنةً بـ Opus 5، النموذج الذي يحل محله، كما أنه أرخص بنسبة 60% من Fable 5.1، وهو العرض الأكثر تقدمًا لدى الشركة.
ويبدو أن النموذج يتمتع بقدرات عالية جدًا. فهو الأكثر تقدمًا سواء من حيث الإصدار (5.5 مقابل 5.1 لدى Fable) أو من حيث الفئة (Opus هو أكبر نموذج متاح للعامة، يليه Sonnet، بينما يعد Haiku الأصغر).
وتقر أنثروبيك بأن الفجوة بين Fable وOpus أضيق مما توحي به درجات المقاييس المرجعية، لكن كونه متاحًا للعامة ضمن الخطة، وكونه أقل تكلفة لكل رمز، يجعله الخيار الواضح لمعظم مستخدمي Claude.
وكان Opus 5 قد أُطلق في يوليو بسعر أقل ودرجات أعلى من Fable 5 في معظم المقاييس المرجعية، ثم وصل Fable 5.1 في أوائل سبتمبر ليعكس المشهد، متفوقًا على Opus 5 في كل معيار نشرته أنثروبيك.
ويقلّص Opus 5.5 الفجوة مجددًا، لكن هذه المرة من ناحية السعر لا الدرجات الخام. وقالت Lovable، وهي منصة للمطورين أجرت اختبارات برمجية خاصة بها على Opus 5 في يوليو، في بيان شاركته أنثروبيك، إن النموذج السابق كان "أكثر ثباتًا، مع تباين أقل بكثير من تشغيل إلى آخر" مقارنةً بما سبقه، وهي الحجة نفسها المتعلقة بالكفاءة التي تروّج لها أنثروبيك مجددًا الآن.
كما أن Opus 5.5 هو أول نموذج تطلقه أنثروبيك منذ أن نشر الرئيس التنفيذي داريو أمودي مقالًا دعا فيه القطاع إلى التباطؤ، معتبرًا أن مكاسب قدرات الذكاء الاصطناعي تتجاوز سرعة اختبارات السلامة المفترض أن تُبقيها تحت السيطرة. وكتب أمودي في وقت سابق من هذا الشهر: "يجب أن نبطئ الوتيرة التي نحسّن بها قدرات نماذج الذكاء الاصطناعي".
وتقيس أنثروبيك معظم هذا التقدم عبر البرمجة الوكيلة—أي العمل الذي ينفذه وكيل ذكاء اصطناعي، وهو نموذج يتخذ إجراءات متعددة الخطوات من تلقاء نفسه بدلًا من مجرد الإجابة عن مطالبة واحدة.
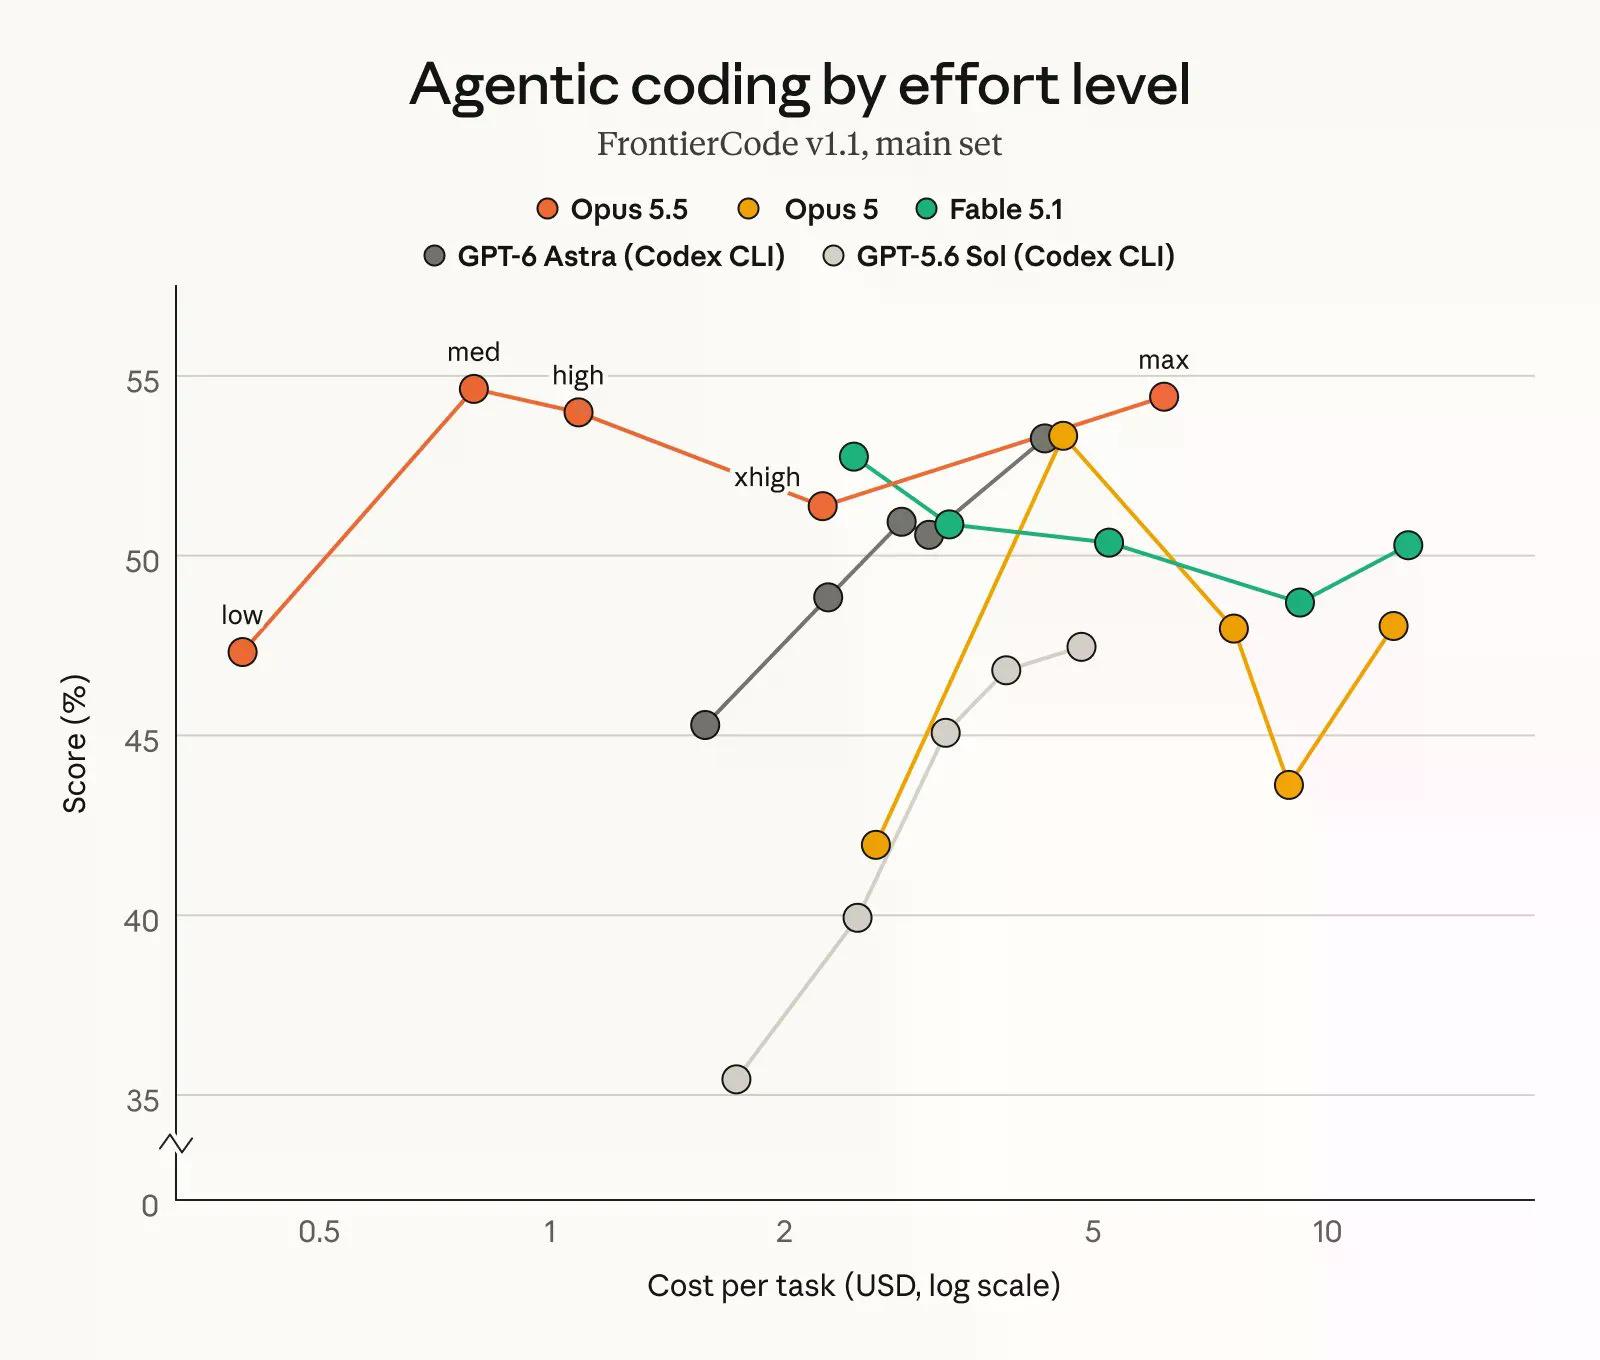
وفي Terminal-Bench 4.0، الذي يختبر ما إذا كان الوكيل قادرًا على إنجاز مهام مهنية معقدة داخل واجهة سطر الأوامر ويقيّم النتيجة كنسبة مئوية من المهام المكتملة، سجل Opus 5.5 نسبة 66.4%، متقدمًا على Fable 5.1 الذي سجل 55.8% وGPT-6 Astra الذي سجل 57.9%. أما FrontierCode، الذي يتحقق مما إذا كانت التعديلات البرمجية التي يجريها الوكيل ستُدمج فعليًا في مسار هندسي حقيقي باستخدام منهجية النجاح نفسها، فقد منح Opus 5.5 نسبة 54.4% مقابل 50.3% لـ Fable 5.1.
وفي GDPval-AA v2.1، الذي يقيّم العمل المهني في العالم الحقيقي عبر 44 مهنة باستخدام نظام Elo—وهو نظام تصنيف شبيه بالشطرنج يُستخدم لقياس المهارة النسبية بدلًا من نسبة مئوية ثابتة—سجل Opus 5.5 درجة 1846 مقابل 1735 لـ Fable 5.1 و1708 لـ Opus 5.
لكن Opus 5.5 لا يتصدر في كل شيء. ففي AutomationBench، وهو معيار طورته Zapier ويقيس ما إذا كان الوكيل قادرًا على تنفيذ سير عمل تجاري كامل من البداية إلى النهاية من دون مساعدة بشرية، تفوق GPT-6 Astra بنسبة 41.4% على Opus 5.5 الذي سجل 40.0%.
وفي Terminal-Bench-Science 0.1، الذي يختبر البحث العلمي الوكيلي المنفذ داخل بيئة سطر أوامر باستخدام منهجية معدل النجاح نفسها، تفوق Astra بنسبة 64.6% على Opus 5.5 الذي سجل 58.7% وبفارق أوسع.
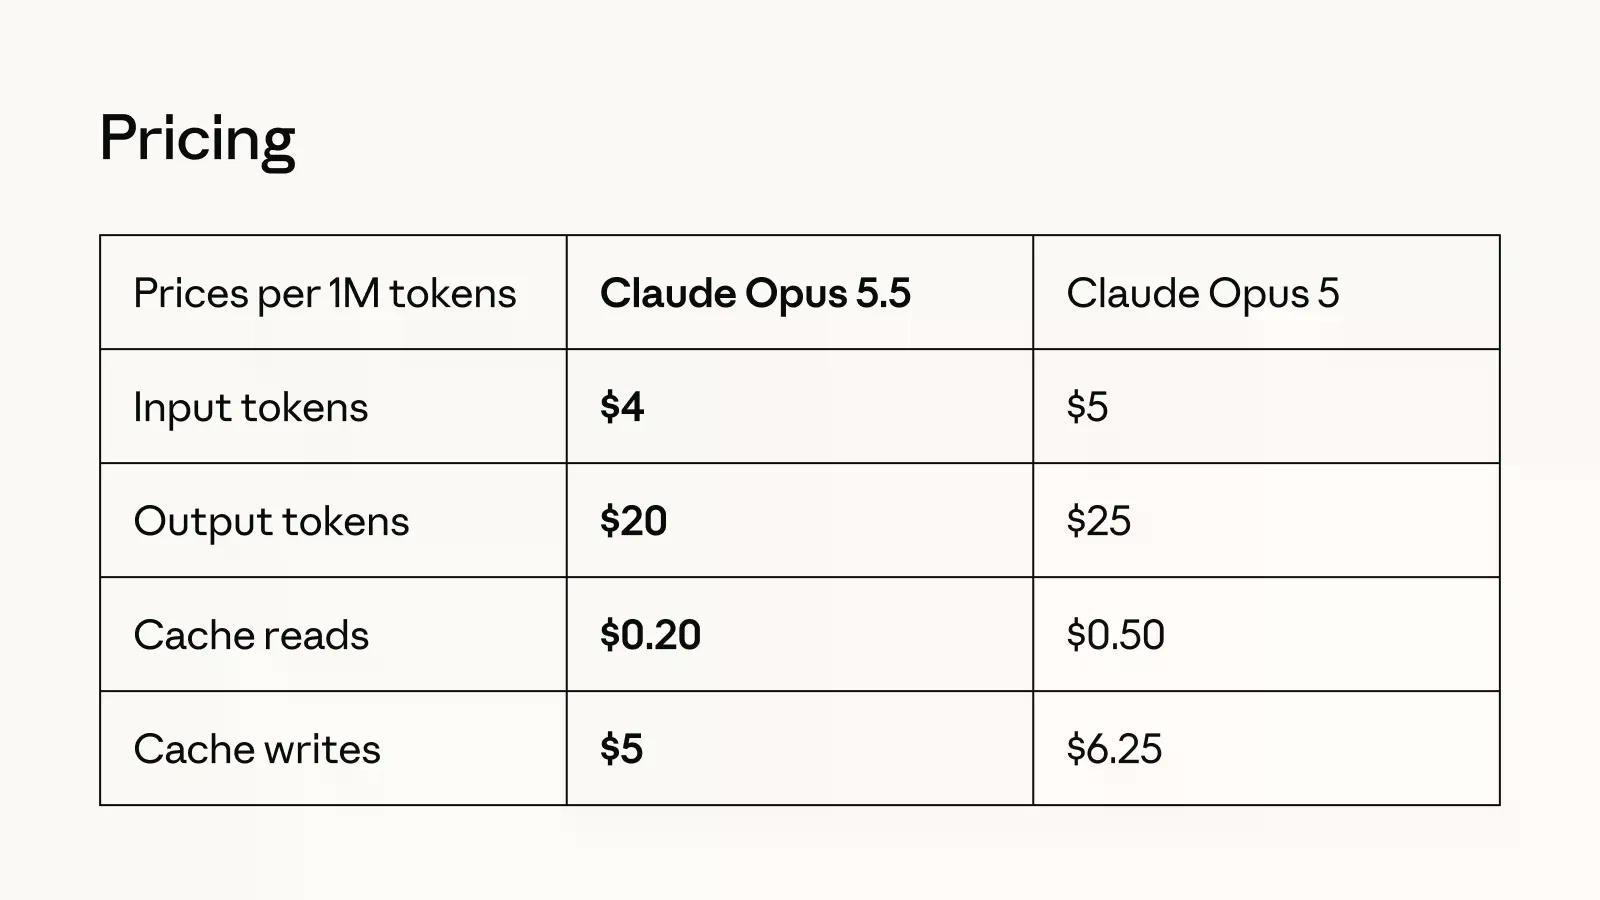
لكن نقطة البيع الأكبر هي التكلفة. فرُموز الإدخال—أي أجزاء النص التي يقرأها النموذج ويكتبها، والمُسعّرة لكل مليون—أصبحت تكلف 4 دولارات لـ Opus 5.5 مقابل 5 دولارات لـ Opus 5، فيما انخفضت تكلفة رموز الإخراج إلى 20 دولارًا من 25 دولارًا. أما قراءات الذاكرة المؤقتة (Cache reads)، التي تعني إعادة استخدام السياق الذي عالجه النموذج مسبقًا بدلًا من معالجته من الصفر، والتي تشكل معظم التكلفة في جلسات البرمجة الوكيلة الطويلة، فقد تراجعت بنسبة 60% إلى 0.20 دولار لكل مليون رمز.
ولأن Opus 5.5 يضاهي نماذج Mythos-class لدى أنثروبيك—وهي الفئة الأكثر تقييدًا في الشركة والمخصصة للباحثين المعتمدين في الأمن السيبراني والبيولوجيا—في هاتين القدرتين، فقد أُطلق مع الضمانات نفسها الموجودة في Fable 5.1.
ويُعاد توجيه معظم مهام الأمن السيبراني تلقائيًا إلى Opus 4.8 الأقدم، وهو أمر اشتكى منه كثير من المطورين والمستخدمين سابقًا.
وأصبح Opus 5.5 متاحًا الآن عبر منصات أنثروبيك، بما في ذلك Amazon Web Services وGoogle Cloud وMicrosoft Azure. وتقول أنثروبيك إن Sonnet 5.5 وHaiku 5.5 سيلحقان به خلال الأسابيع المقبلة، مع تطبيق التخفيضات السعرية نفسها على بقية التشكيلة.







