Anthropic 於週二發布 Claude Opus 5.5,這是公司所稱 Claude 5.5 系列中的首款模型。Anthropic 表示,這款新模型在大多數任務上的表現,已達到旗下最昂貴旗艦模型 Claude Fable 5.1 的水準。
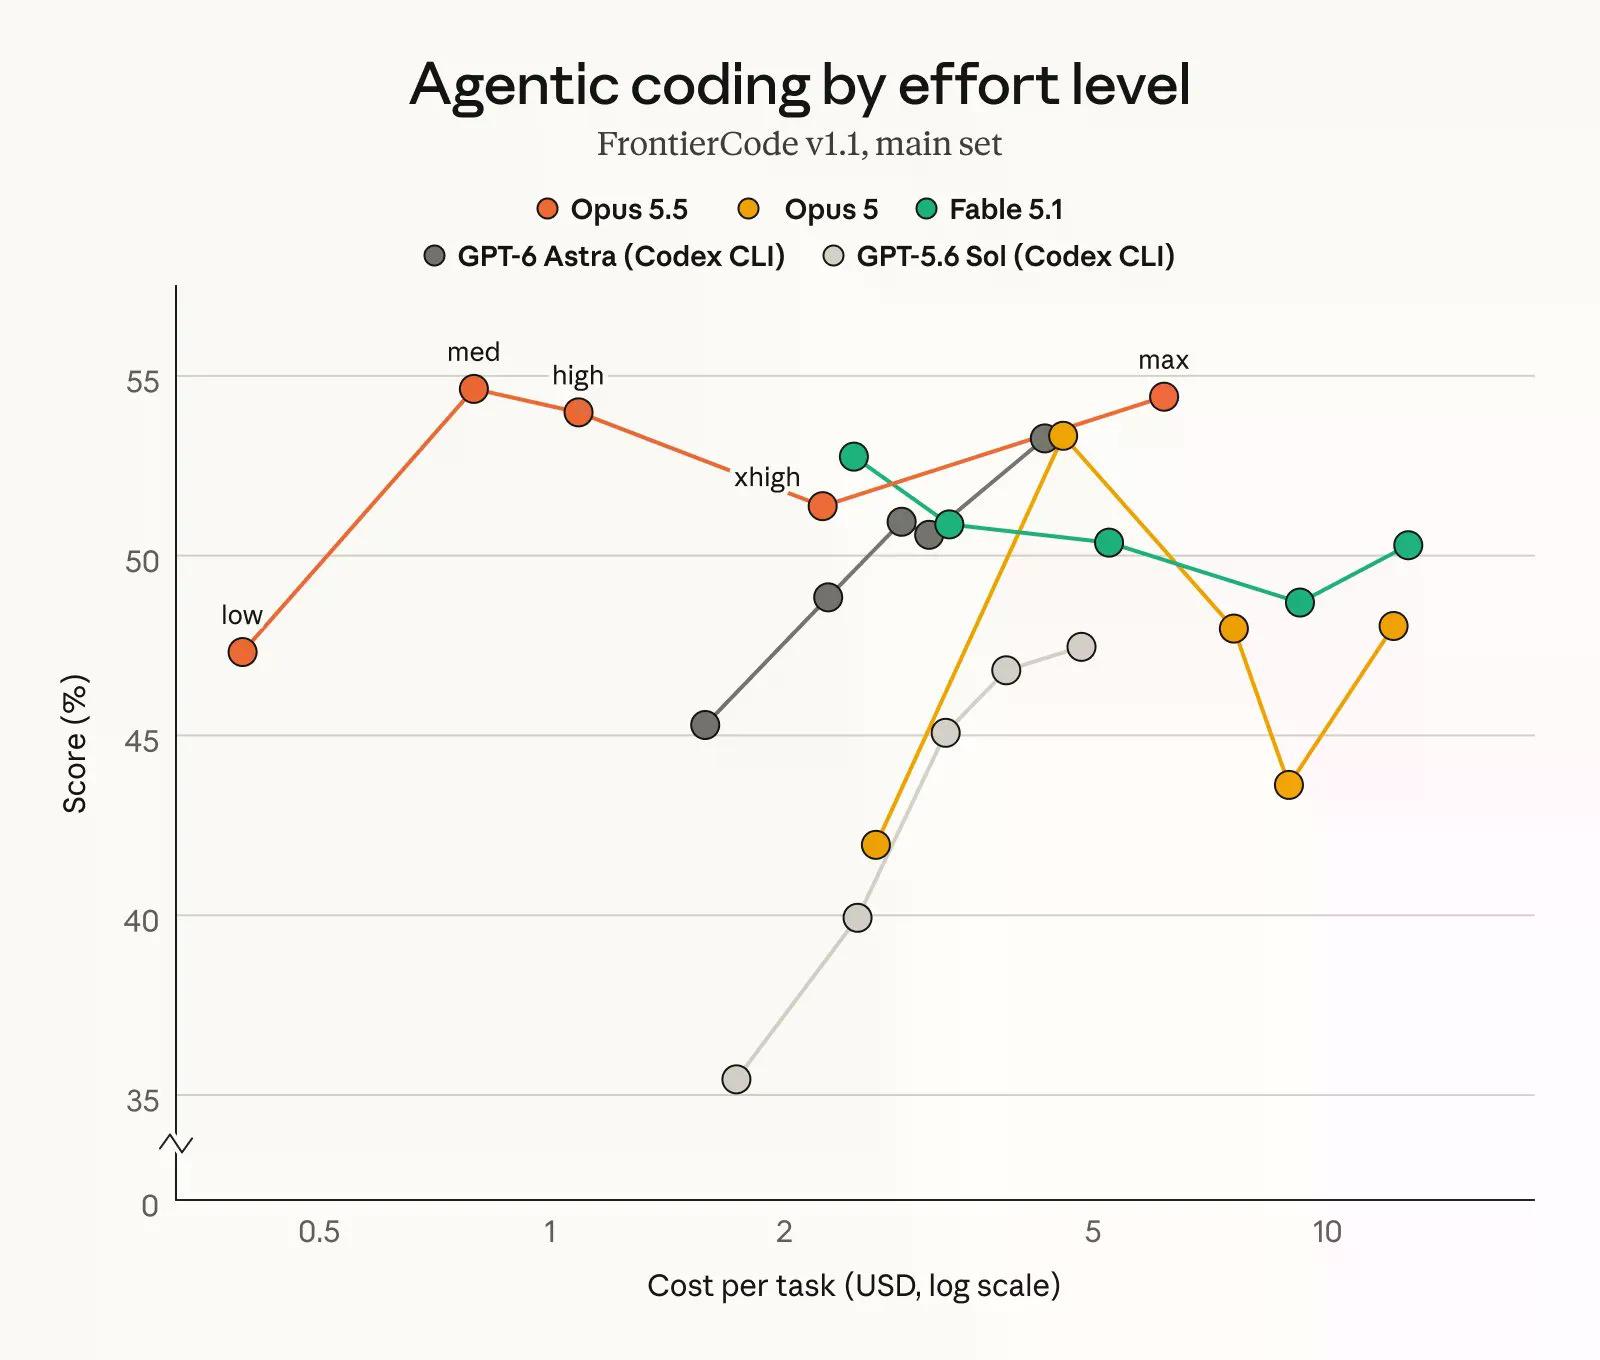
關鍵在於,這款模型的運行成本比其所取代的 Opus 5 低 20%,相較公司當前最先進的產品 Fable 5.1,更便宜達 60%。
從目前資訊來看,這款模型能力相當強。無論在版本上(5.5 相較 Fable 的 5.1),還是在產品家族定位上(Opus 是目前公開可用的最大模型,其次是 Sonnet,最小則是 Haiku),它都是更先進的型號。
Anthropic 也坦承,Fable 與 Opus 之間的差距,其實比基準測試分數所呈現的更小;但由於 Opus 5.5 可在公開方案中使用,且每 token 成本更低,對大多數 Claude 用戶來說,這顯然會是更合理的選擇。
Opus 5 於 7 月推出時,在大多數基準測試上不僅價格更低,分數也高於 Fable 5;而 Fable 5.1 在 9 月初登場後扭轉局勢,在 Anthropic 公布的所有基準中全面擊敗 Opus 5。
如今 Opus 5.5 再度縮小差距,只是這次靠的是價格,而非原始分數。開發者平台 Lovable 曾在 7 月以自家程式測試評估 Opus 5,並在 Anthropic 分享的一份聲明中表示,早期版本模型「表現更穩定,每次運行間的波動明顯更小」,這也正是 Anthropic 此次再度主打的效率賣點。
Opus 5.5 也是 Anthropic 執行長 Dario Amodei 發表呼籲業界放慢腳步的文章後,公司推出的首個模型。Amodei 主張,AI 能力的提升速度,已超過旨在加以制衡的安全測試進程。他在本月稍早寫道:「我們必須放慢提升 AI 模型能力的速度。」
Anthropic 對這些進展的衡量,大多透過 agentic coding(代理式編碼)來進行——也就是由 AI 代理自行執行多步驟操作,而不只是回應單一提示的工作模式。
在 Terminal-Bench 4.0 中,該測試用於檢驗代理是否能在命令列介面內完成複雜的專業任務,並以完成任務比例作為分數,Opus 5.5 取得 66.4%,高於 Fable 5.1 的 55.8% 與 GPT-6 Astra 的 57.9%。而 FrontierCode 以相同的通過率評分方式,檢查代理所做的程式碼修改是否真的能在真實工程流程中被合併,Opus 5.5 得分為 54.4%,高於 Fable 5.1 的 50.3%。
在 GDPval-AA v2.1 上,該測試以 Elo 評分系統——也就是國際象棋常用、用來衡量相對技能而非固定百分比的排名方法——對 44 種職業的真實世界專業工作進行評估,Opus 5.5 得分 1846,優於 Fable 5.1 的 1735 以及 Opus 5 的 1708。
不過,Opus 5.5 並非在所有領域都居於領先。在 AutomationBench 上,這項由 Zapier 建立的基準測試用來評估代理是否能在無需人工協助下,從頭到尾完成整套商業工作流程,GPT-6 Astra 以 41.4% 小勝 Opus 5.5 的 40.0%。
在 Terminal-Bench-Science 0.1 上,該測試以同樣的通過率方法,評估代理在命令列環境中執行科學研究工作的能力,Astra 以 64.6% 明顯領先 Opus 5.5 的 58.7%。
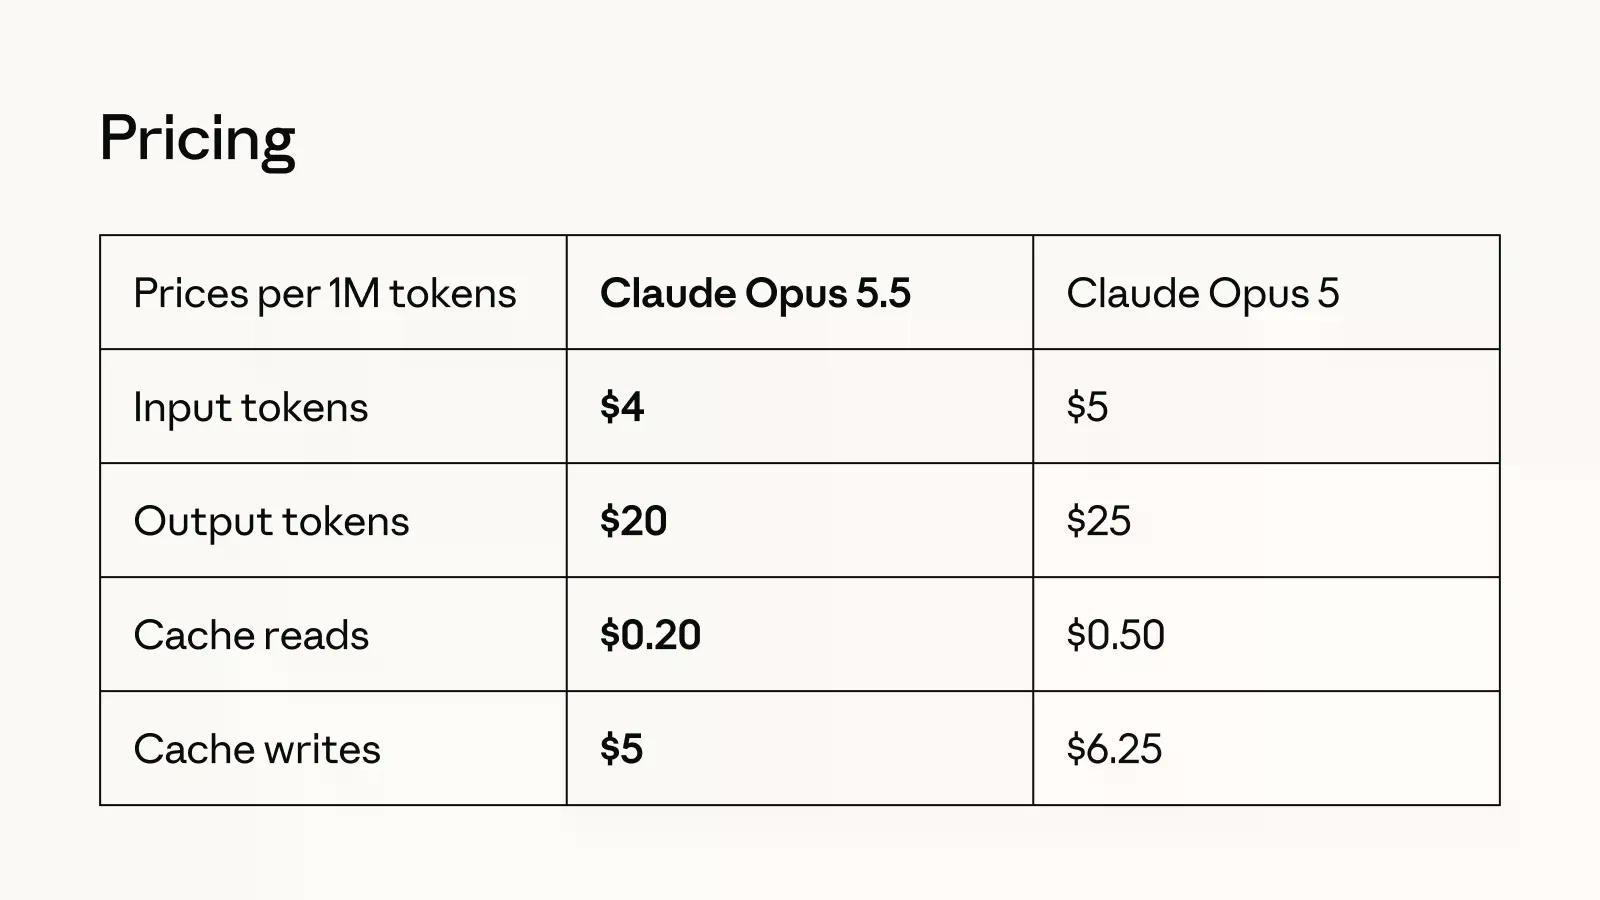
更大的賣點在於成本。輸入 token——也就是模型讀寫的文字片段,按每百萬計價——Opus 5.5 現為 4 美元,而 Opus 5 為 5 美元;輸出 token 則由 25 美元降至 20 美元。至於快取讀取(cache reads),也就是重複利用模型已處理過的上下文,而非從零重新處理,這通常是長時間代理式編碼工作中成本的大宗,其價格大幅下降 60% 至每百萬 token 0.20 美元。
由於 Opus 5.5 在這兩項能力上已達到 Anthropic 的 Mythos 級模型水準——這是公司限制最嚴格的層級,僅對通過審核的資安與生物研究人員開放——因此它在推出時也配備與 Fable 5.1 相同的安全防護措施。
大多數資安相關任務會自動被重新導向至較舊的 Opus 4.8,這也是先前許多開發者與使用者曾抱怨的問題。
Opus 5.5 現已於 Anthropic 各平台上線,包括 Amazon Web Services、Google Cloud 與 Microsoft Azure。Anthropic 表示,Sonnet 5.5 與 Haiku 5.5 也將在未來數週內推出,並把相同的降價措施延伸至整個產品線。