


xAI, compania lui Elon Musk, a lansat luni după-amiază Grok 4.7, cel mai bun model al său de până acum, descriindu-l drept „o îmbunătățire notabilă față de Grok 4.6 la același preț și aceeași viteză”.
Lansarea vine după mai multe întârzieri aparente. Musk a amânat termenul de lansare de cel puțin cinci ori de la sfârșitul lui iulie: „peste patru săptămâni”, apoi „câteva săptămâni”, apoi „3 până la 4 săptămâni”, apoi „10 zile” pe 1 septembrie, iar apoi „mai are nevoie de câteva zile să se coacă” pe 11 septembrie.
xAI spune că modelul petrece mai mult timp rezolvând probleme dificile și își verifică mai des propriile răspunsuri decât Grok 4.6, alături de ceea ce compania numește cele mai solide măsuri de siguranță de până acum.
Musk a revenit pe X, numind Grok 4.7 „o combinație puternică de inteligență, viteză și cost redus”. De data aceasta nu există listă de așteptare — este deja live în aplicația Grok, Cursor, Grok Build și API-ul xAI.
Grok 4.7 este aici.
Este o îmbunătățire notabilă față de Grok 4.6 la același preț și aceeași viteză. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 septembrie 2026
Grok 4.7 are 2,1 trilioane de parametri, în creștere cu 40% față de cele 1,5 trilioane din Grok 4.6, el însuși o rafinare a lui Grok 4.5. Costurile sunt de 2 dolari per un milion de tokeni de intrare și 6 dolari per un milion de tokeni de ieșire. Parametrii sunt reglajele interne pe care un model le ajustează în timpul antrenării, iar un număr mai mare înseamnă în general o capacitate mai mare de a învăța tipare, în timp ce tokenii reprezintă unitatea de bază a informației pe care un model AI o poate procesa sau genera.
xAI a integrat și date suplimentare de antrenament preluate de la SpaceX, compania aerospațială a lui Musk: telemetrie de la sateliții Starlink, registre de producție și jurnale ale defectelor inginerești. Ideea promovată este un model care raționează mai bine despre hardware și sisteme fizice decât orice alt model antrenat exclusiv pe text de pe internet.
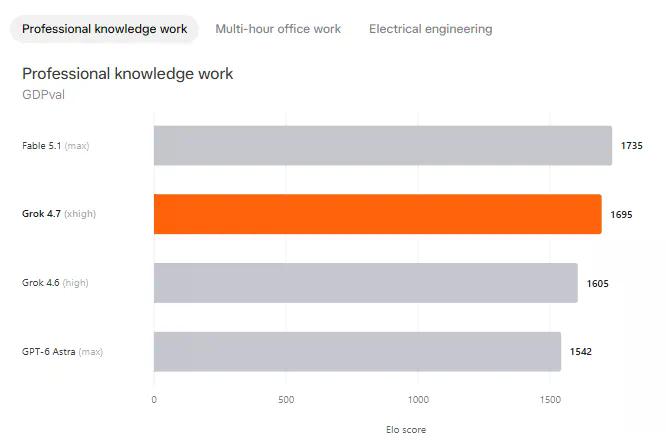
Acestea fiind spuse, scorurile din benchmarkuri spun o poveste familiară. GDPval măsoară cum se descurcă un model în sarcini reale de knowledge work cu valoare economică — memorii juridice, foi de calcul, prezentări slide — folosind taskuri validate de profesioniști activi din fiecare domeniu și îl notează printr-un rating Elo, același sistem de clasament head-to-head folosit în șah.
Grok 4.7 a atins 1695 pe GDPval. Claude Fable 5.1 a condus clasamentul cu 1735.
AA-Briefcase, construit de Artificial Analysis, testează muncă de birou desfășurată pe mai multe ore, care leagă cercetarea, analiza și producția de documente într-o singură sarcină lungă, de asemenea notată pe scara Elo. Grok 4.7 a obținut 1657, față de 1678 pentru Fable 5.1. Același rezultat, test diferit.
CursorBench 4.0, benchmarkul Cursor pentru taskuri reale de programare în interiorul editorului său, plasează acuratețea în raport cu costul și numărul de tokeni consumați de fiecare task. Grok 4.7 se plasează la mijloc: mai scump per sarcină decât succesorul lui GPT-5.6 Sol, GPT-6 Astra, și Claude Sonnet 5, dar tot sub Fable 5.1, care câștigă la fiecare nivel de preț din grafic.
Acesta nu este un tipar nou pentru xAI. Grok 4.5 a fost lansat în iulie cu cel mai mare cluster de antrenare din industrie și scoruri de pe locul al treilea, în urma modelelor Claude și OpenAI. Înaintea lui, Grok 4.20 a sacrificat fiabilitatea pentru viteză și personalitate. Grok 4.6 a rămas și el în urma plutonului de frontieră la capitolul autonomie în programare.
Nimic din toate acestea nu face din Grok 4.7 un produs slab pentru milioanele de oameni care interacționează cu el prin X, aplicația standalone sau bordul Tesla. Înseamnă că modelul cel mai probabil să-ți răspundă la întrebări sau să alimenteze asistentul vocal al mașinii tale rulează pe un sistem pe care propriile benchmarkuri ale producătorului îl plasează cu o treaptă sub vârful clasamentului.
Acest decalaj explică de ce prețul contează mai mult decât poziția în clasament pentru majoritatea oamenilor. xAI a practicat constant prețuri sub Anthropic și OpenAI la costul per token, chiar dacă rămâne în urmă la capacitate brută, mizând că „destul de bun, ieftin și peste tot” bate „cel mai bun, dar mai scump” pentru cea mai mare parte a utilizărilor de zi cu zi.
Musk redusese deja așteptările cu câteva zile înainte de lansare, scriind că Grok 4.7 ar trebui să fie „aproximativ la același nivel cu” Claude Opus 5.0 de la Anthropic, nu cu mai noul Opus 5.1, iar performanța multimodală încă mai are nevoie de îmbunătățiri.
În aceeași postare, el a schițat următoarele trei modele: Grok 4.8 ca un pas semnificativ înainte, Grok 4.9 în „clasa Astra/Fable” și Grok 5 ca posibil lider de frontieră. Aceste upgrade-uri nu au încă o dată de lansare. „Rămâne de văzut”, a scris el.







