

Anthropic a lansat marți Claude Opus 5.5, primul model din ceea ce compania numește familia Claude 5.5. Anthropic spune că noul model oferă performanțe la nivelul Claude Fable 5.1, flagship-ul său cel mai scump, în majoritatea sarcinilor.
Elementul surpriză este că modelul costă cu 20% mai puțin de rulat decât Opus 5, modelul pe care îl înlocuiește, și este cu 60% mai ieftin decât Fable 5.1, oferta de ultimă generație a companiei.
Modelul pare a fi foarte capabil. Este cel mai avansat model atât ca versiune (5.5 vs 5.1 pentru Fable), cât și ca familie (Opus este cel mai mare model disponibil public, urmat de Sonnet, în timp ce Haiku este cel mai mic).
Anthropic admite că diferența dintre Fable și Opus este mai mică decât sugerează scorurile din benchmark-uri, însă faptul că este disponibil public în plan și că are un cost mai redus per token îl transformă în alegerea evidentă pentru majoritatea utilizatorilor Claude.
Opus 5 a fost lansat în iulie, cu un preț mai mic și scoruri mai bune decât Fable 5 în majoritatea benchmark-urilor, iar Fable 5.1 a sosit la începutul lui septembrie și a inversat situația, depășind Opus 5 în fiecare benchmark publicat de Anthropic.
Opus 5.5 reduce din nou diferența, de această dată la nivel de preț, nu de scoruri brute. Lovable, o platformă pentru dezvoltatori care a rulat Opus 5 prin propriile teste de coding în iulie, a declarat într-un comunicat distribuit de Anthropic că modelul anterior a fost „mai stabil, cu mult mai puțină variație de la o rulare la alta” față de ce exista înainte — același argument de eficiență pe care Anthropic îl promovează și acum.
Opus 5.5 este și primul model lansat de Anthropic după ce CEO-ul Dario Amodei a publicat un eseu în care cere industriei să încetinească, argumentând că ritmul de creștere al capabilităților AI depășește testarea de siguranță menită să le țină sub control. „Trebuie să încetinim ritmul în care îmbunătățim capabilitățile modelelor AI”, a scris Amodei la începutul acestei luni.
Anthropic măsoară cea mai mare parte a acestui progres prin coding agentic — muncă realizată de un agent AI, un model care execută singur acțiuni în mai mulți pași, în loc să răspundă doar la un singur prompt.
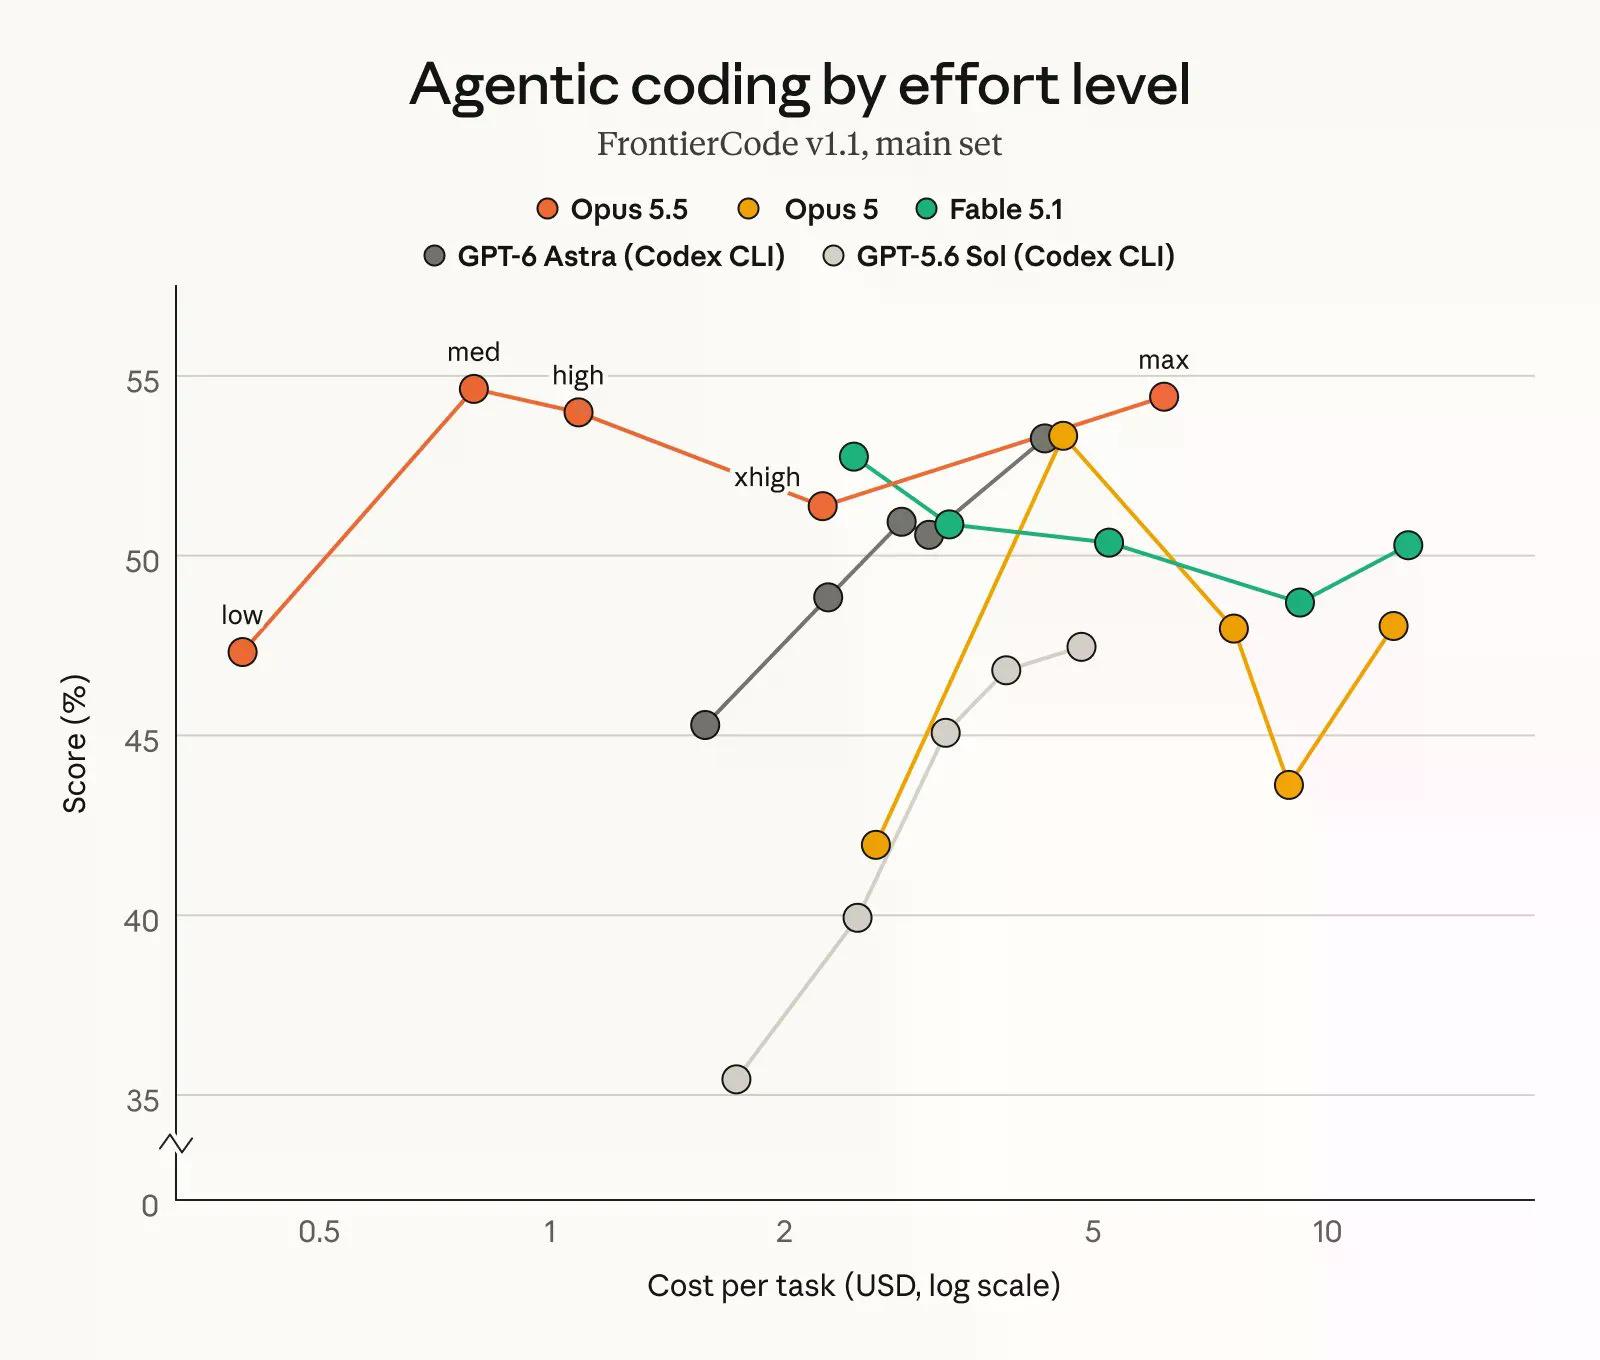
Pe Terminal-Bench 4.0, care testează dacă un agent poate finaliza sarcini profesionale complexe într-o interfață de linie de comandă și evaluează rezultatul ca procent al sarcinilor completate, Opus 5.5 a atins 66,4%, peste Fable 5.1 cu 55,8% și GPT-6 Astra cu 57,9%. FrontierCode, care verifică dacă modificările de cod făcute de un agent ar fi efectiv integrate într-un pipeline real de inginerie folosind același sistem de evaluare pe bază de rată de trecere, a plasat Opus 5.5 la 54,4%, față de 50,3% pentru Fable 5.1.
Pe GDPval-AA v2.1, care evaluează activitatea profesională din lumea reală în 44 de ocupații folosind Elo — același sistem de ranking în stil șah folosit pentru a măsura abilitatea relativă, nu un simplu procent fix — Opus 5.5 a obținut 1846, față de 1735 pentru Fable 5.1 și 1708 pentru Opus 5.
Totuși, Opus 5.5 nu domină peste tot. Pe AutomationBench, un benchmark construit de Zapier care măsoară dacă un agent poate duce la capăt un workflow complet de business, de la început până la sfârșit, fără ajutor uman, GPT-6 Astra, cu 41,4%, depășește ușor Opus 5.5, care are 40,0%.
Pe Terminal-Bench-Science 0.1, care testează cercetarea științifică agentică desfășurată într-un mediu de linie de comandă folosind aceeași metodă bazată pe rata de trecere, Astra, cu 64,6%, depășește Opus 5.5, cu 58,7%, la o marjă mai mare.
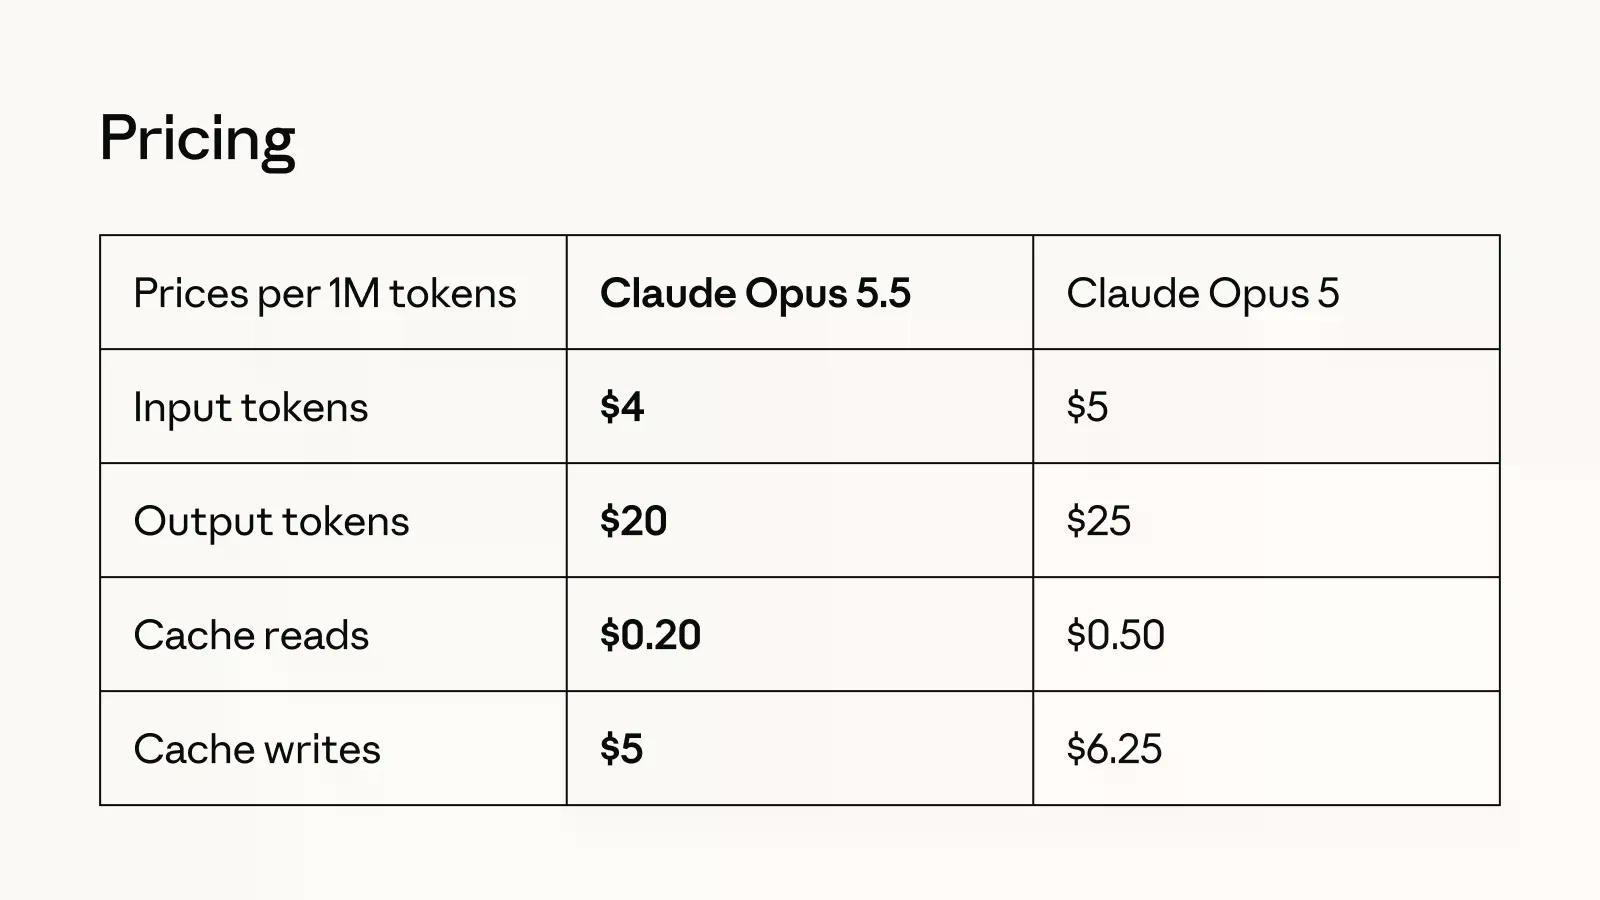
Principalul argument comercial este însă costul. Tokenii de intrare — fragmentele de text pe care un model le citește și le scrie, tarifate per milion — costă acum 4 dolari pentru Opus 5.5 față de 5 dolari pentru Opus 5, iar tokenii de ieșire scad la 20 de dolari de la 25. Citirile din cache, care înseamnă reutilizarea contextului deja procesat de model în locul reprocesării de la zero și care generează cea mai mare parte a costului în sesiunile lungi de coding agentic, scad cu 60%, la 0,20 dolari per milion de tokeni.
Pentru că Opus 5.5 se aliniază modelelor din clasa Mythos ale Anthropic — nivelul cel mai restrictiv al companiei, rezervat cercetătorilor verificați din domeniile securității cibernetice și biologiei — pe aceste două capabilități, lansarea vine cu aceleași măsuri de protecție ca Fable 5.1.
Majoritatea sarcinilor de securitate cibernetică sunt redirecționate automat către mai vechiul Opus 4.8, lucru de care mulți dezvoltatori și utilizatori s-au plâns anterior.
Opus 5.5 este disponibil acum pe toate platformele Anthropic, inclusiv Amazon Web Services, Google Cloud și Microsoft Azure. Sonnet 5.5 și Haiku 5.5 vor urma în următoarele săptămâni, spune Anthropic, păstrând aceleași reduceri de preț pentru restul gamei.







