

एलन मस्क की xAI ने सोमवार दोपहर Grok 4.7 जारी किया, जिसे अब तक का उसका सर्वश्रेष्ठ मॉडल बताया गया है। कंपनी ने इसे "उसी कीमत और गति पर Grok 4.6 की तुलना में एक उल्लेखनीय सुधार" कहा।
यह रिलीज कई स्पष्ट देरी के बाद आई है। मस्क ने जुलाई के अंत से कम-से-कम पांच बार टाइमलाइन पीछे खिसकाई: पहले "चार हफ्ते दूर", फिर "कुछ हफ्ते", फिर "3 से 4 हफ्ते", फिर 1 सितंबर को "10 दिन", और फिर 11 सितंबर को "इसे पकने के लिए कुछ और दिन चाहिए" कहा।
xAI का कहना है कि यह मॉडल कठिन समस्याओं पर अधिक समय लगाता है और Grok 4.6 की तुलना में अपने उत्तरों को अधिक बार दोबारा जांचता है। इसके साथ ही कंपनी के अनुसार इसमें अब तक के सबसे मजबूत सुरक्षा गार्डरेल्स भी शामिल हैं।
मस्क ने X पर आगे लिखते हुए Grok 4.7 को "इंटेलिजेंस, स्पीड और कम लागत का मजबूत संयोजन" बताया। इस बार कोई वेटलिस्ट नहीं है—यह अब Grok ऐप, Cursor, Grok Build और xAI API में लाइव है।
Grok 4.7 आ गया है।
यह उसी कीमत और गति पर Grok 4.6 की तुलना में एक उल्लेखनीय सुधार है। pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) 21 सितंबर, 2026
Grok 4.7 में 2.1 ट्रिलियन पैरामीटर्स हैं, जो Grok 4.6 के 1.5 ट्रिलियन से 40% अधिक हैं; Grok 4.6 स्वयं Grok 4.5 का परिष्कृत संस्करण था। इसकी लागत प्रति मिलियन इनपुट टोकन $2 और प्रति मिलियन आउटपुट टोकन $6 है। पैरामीटर्स वे आंतरिक नॉब्स हैं जिन्हें मॉडल प्रशिक्षण के दौरान ट्यून करता है, और सामान्य तौर पर उनकी संख्या अधिक होने का मतलब पैटर्न सीखने की अधिक क्षमता होता है। वहीं टोकन सूचना की वह मूल इकाई हैं जिन्हें एआई मॉडल या तो प्रोसेस कर सकता है या उत्पन्न कर सकता है।
xAI ने SpaceX, यानी मस्क की रॉकेट कंपनी, से प्राप्त अतिरिक्त प्रशिक्षण डेटा भी इसमें शामिल किया है: Starlink सैटेलाइट टेलीमेट्री, मैन्युफैक्चरिंग रिकॉर्ड्स और इंजीनियरिंग फेल्योर लॉग्स। इसकी पेशकश यह है कि यह ऐसा मॉडल है जो केवल इंटरनेट टेक्स्ट पर प्रशिक्षित किसी भी सिस्टम की तुलना में हार्डवेयर और भौतिक प्रणालियों पर बेहतर तर्क कर सकता है।
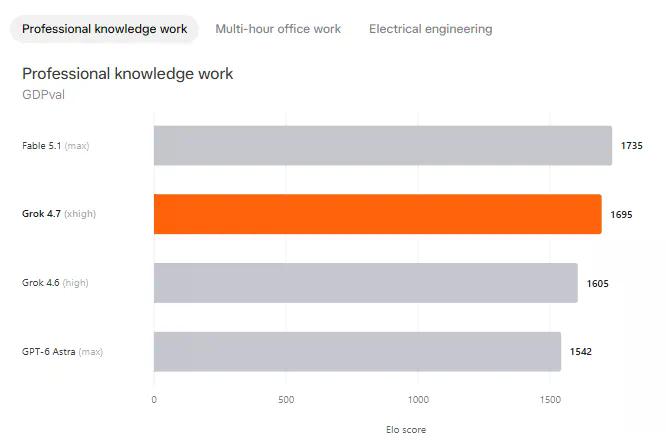
फिर भी, बेंचमार्क स्कोर एक परिचित कहानी बताते हैं। GDPval मापता है कि कोई मॉडल वास्तविक, आर्थिक रूप से मूल्यवान नॉलेज वर्क—जैसे लीगल मेमो, स्प्रेडशीट्स और स्लाइड डेक—पर कैसा प्रदर्शन करता है। इसके लिए प्रत्येक क्षेत्र के कार्यरत पेशेवरों द्वारा सत्यापित कार्यों का उपयोग किया जाता है, और स्कोर Elo रेटिंग के रूप में दिया जाता है, जो वही हेड-टू-हेड रैंकिंग सिस्टम है जिसका उपयोग शतरंज में होता है।
GDPval पर Grok 4.7 ने 1695 स्कोर किया। Claude Fable 5.1 1735 के साथ चार्ट में शीर्ष पर रहा।
Artificial Analysis द्वारा बनाया गया AA-Briefcase बहु-घंटों तक चलने वाले ऑफिस कार्य का परीक्षण करता है, जिसमें रिसर्च, विश्लेषण और दस्तावेज़ उत्पादन को एक लंबे कार्य में जोड़ा जाता है। इसका स्कोर भी Elo स्केल पर दिया जाता है। Grok 4.7 ने 1657 स्कोर किया, जबकि Fable 5.1 ने 1678। नतीजा वही, बस टेस्ट अलग।
CursorBench 4.0, Cursor के एडिटर के भीतर वास्तविक कोडिंग कार्यों के लिए उसका बेंचमार्क, प्रत्येक कार्य में खर्च होने वाली लागत और टोकन काउंट के मुकाबले सटीकता को प्लॉट करता है। Grok 4.7 बीच में आता है: प्रति कार्य लागत के हिसाब से यह GPT-5.6 Sol के उत्तराधिकारी GPT-6 Astra और Claude Sonnet 5 से अधिक महंगा है, लेकिन फिर भी Fable 5.1 से पीछे है, जो चार्ट में हर प्राइस पॉइंट पर जीतता है।
xAI के लिए यह कोई नया पैटर्न नहीं है। Grok 4.5 जुलाई में इंडस्ट्री के सबसे बड़े ट्रेनिंग क्लस्टर के साथ लॉन्च हुआ था और Claude तथा OpenAI के मॉडलों के पीछे तीसरे स्थान के स्कोर पर रहा। उससे पहले Grok 4.20 ने विश्वसनीयता के बदले स्पीड और पर्सनैलिटी को तरजीह दी थी। Grok 4.6 भी कोडिंग ऑटोनॉमी के मामले में फ्रंटियर समूह से पीछे रहा।
इसमें से कोई भी बात Grok 4.7 को उन लाखों लोगों के लिए खराब उत्पाद नहीं बनाती जो X, स्टैंडअलोन ऐप या अपनी Tesla के डैशबोर्ड के जरिए इससे बात करते हैं। इसका मतलब बस इतना है कि वह मॉडल जो आपके सवालों का जवाब देने या आपकी कार के वॉइस असिस्टेंट को चलाने की सबसे अधिक संभावना रखता है, ऐसे सिस्टम पर चल रहा है जिसे उसके निर्माता के अपने बेंचमार्क शीर्ष पायदान से एक स्तर नीचे रखते हैं।
यही अंतर बताता है कि अधिकांश लोगों के लिए लीडरबोर्ड की स्थिति से अधिक कीमत क्यों मायने रखती है। xAI ने लगातार प्रति टोकन लागत के मामले में Anthropic और OpenAI से कम दर रखी है, भले ही कच्ची क्षमता में वह उनसे पीछे रहा हो। उसका दांव यह है कि रोजमर्रा के अधिकतर उपयोग के लिए "काफी अच्छा, सस्ता और हर जगह उपलब्ध" मॉडल, "सर्वश्रेष्ठ लेकिन अधिक महंगा" मॉडल पर भारी पड़ता है।
लॉन्च से कुछ दिन पहले ही मस्क ने उम्मीदें नीचे कर दी थीं। उन्होंने लिखा था कि Grok 4.7, Anthropic के Claude Opus 5.0 के "लगभग बराबर" होना चाहिए, न कि नए Opus 5.1 के, और मल्टीमॉडल प्रदर्शन में अभी भी काम बाकी है।
उसी पोस्ट में उन्होंने अगले तीन मॉडलों की रूपरेखा भी दी: Grok 4.8 को एक सार्थक उछाल, Grok 4.9 को "Astra/Fable क्लास" में, और Grok 5 को संभावित फ्रंटियर लीडर बताया। इन अपग्रेड्स की अभी कोई रिलीज डेट नहीं है। उन्होंने लिखा, "देखते हैं।"







