

AI मॉडल बहुत अधिक मेमोरी खाते हैं। उद्योग मानकों के अनुसार एक मध्यम आकार का माना जाने वाला 27-बिलियन-पैरामीटर AI मॉडल को हाफ प्रेसिजन पर चलने के लिए लगभग 54 GB मेमोरी की आवश्यकता होती है। अधिकांश लैपटॉप इसे संभाल नहीं सकते। कुछ डेस्कटॉप रिग भी नहीं।
इस सप्ताह की शुरुआत में, PrismML ने 3.9 GB का एक मॉडल जारी किया—जो iPhone में फिट होने के लिए काफी छोटा है।
पैरामीटर डायल और ट्वीक की संख्या हैं जिन्हें एक मॉडल संभाल सकता है। जितने अधिक पैरामीटर होते हैं, मॉडल उतना ही सघन और अधिक सक्षम होता है।
बोन्साई 27B उपभोक्ता स्मार्टफोन की मेमोरी सीमा को पार करने वाला पहला 27B-क्लास मॉडल है, जो iPhone 17 Pro Max पर 11 टोकन प्रति सेकंड की गति से चलता है। (टोकन सूचना की मूल इकाई हैं जिन्हें AI मॉडल संभाल और उत्पन्न कर सकते हैं।) 5.9 GB पर, टर्नरी वेरिएंट एक M5 प्रो लैपटॉप पर लगभग 26 टोकन प्रति सेकंड की गति से चलता है। दोनों अपाचे 2.0 के तहत मुफ्त उपलब्ध हैं।
कैल्टेक बौद्धिक संपदा पर आधारित संपीड़न विधि, प्रत्येक मॉडल के वेट को 16 बिट के फ्लोटिंग-पॉइंट प्रेसिजन से एक एकल चिह्न तक कम कर देती है—बाइनरी बिल्ड में +1 या -1, टर्नरी में तीन मानों में से एक। 128 वेट का प्रत्येक समूह 16-बिट स्केलिंग कारक साझा करता है, जिससे बाइनरी वेरिएंट प्रति वेट 1.125 बिट्स पर आता है: पूर्ण-परिशुद्धता मूल से 14 गुना छोटा। टर्नरी मॉडल थोड़ी अधिक अभिव्यंजक शक्ति के लिए एक शून्य अवस्था जोड़ता है और 1.71 बिट्स पर स्थिर होता है।
आसान शब्दों में कहें तो, इसका मतलब है कि एक टर्नरी AI मॉडल प्रत्येक आंतरिक मान के लिए केवल तीन सेटिंग्स का उपयोग करता है—नकारात्मक, शून्य या सकारात्मक—जबकि एक मानक AI लगभग 65,000 सेटिंग्स में से चुन सकता है।
PrismML ने ऐसा आउटपुट गुणवत्ता का अधिक नुकसान किए बिना किया।
यह पारंपरिक "लो-बिट" मॉडल से इस मायने में अलग है कि किसी को भी उच्च-परिशुद्धता से बचने का मौका नहीं मिलता है: एम्बेडिंग, अटेंशन और पूर्ण भाषा मॉडल हेड सभी एंड-टू-एंड संपीड़ित होते हैं। अधिकांश क्वांटाइज्ड बिल्ड कुछ संवेदनशील परतों को पूर्ण परिशुद्धता पर रखते हैं, जिससे बेहतर गुणवत्ता के बदले उनका आकार बढ़ जाता है। बोन्साई वह खेल नहीं खेलता है।
यह इस परिवार में दूसरी बड़ी रिलीज़ है। मार्च में, PrismML ने बोन्साई 8B जारी किया, जो एक 1.15 GB का मॉडल था जिसने साबित किया कि 1-बिट आर्किटेक्चर 8 बिलियन पैरामीटर पर अपने तर्क के ध्वस्त हुए बिना जीवित रह सकता है। 27 बिलियन तक की छलांग वह जगह है जहाँ दांव बदलते हैं—यह वह पैमाना है जहाँ निरंतर विचार-श्रृंखला तर्क, विश्वसनीय उपकरण उपयोग और बहु-चरणीय एजेंटिक व्यवहार वास्तव में लगातार उभरते हैं—वे चीजें जिनमें छोटे मॉडल अभी भी लड़खड़ाते हैं।
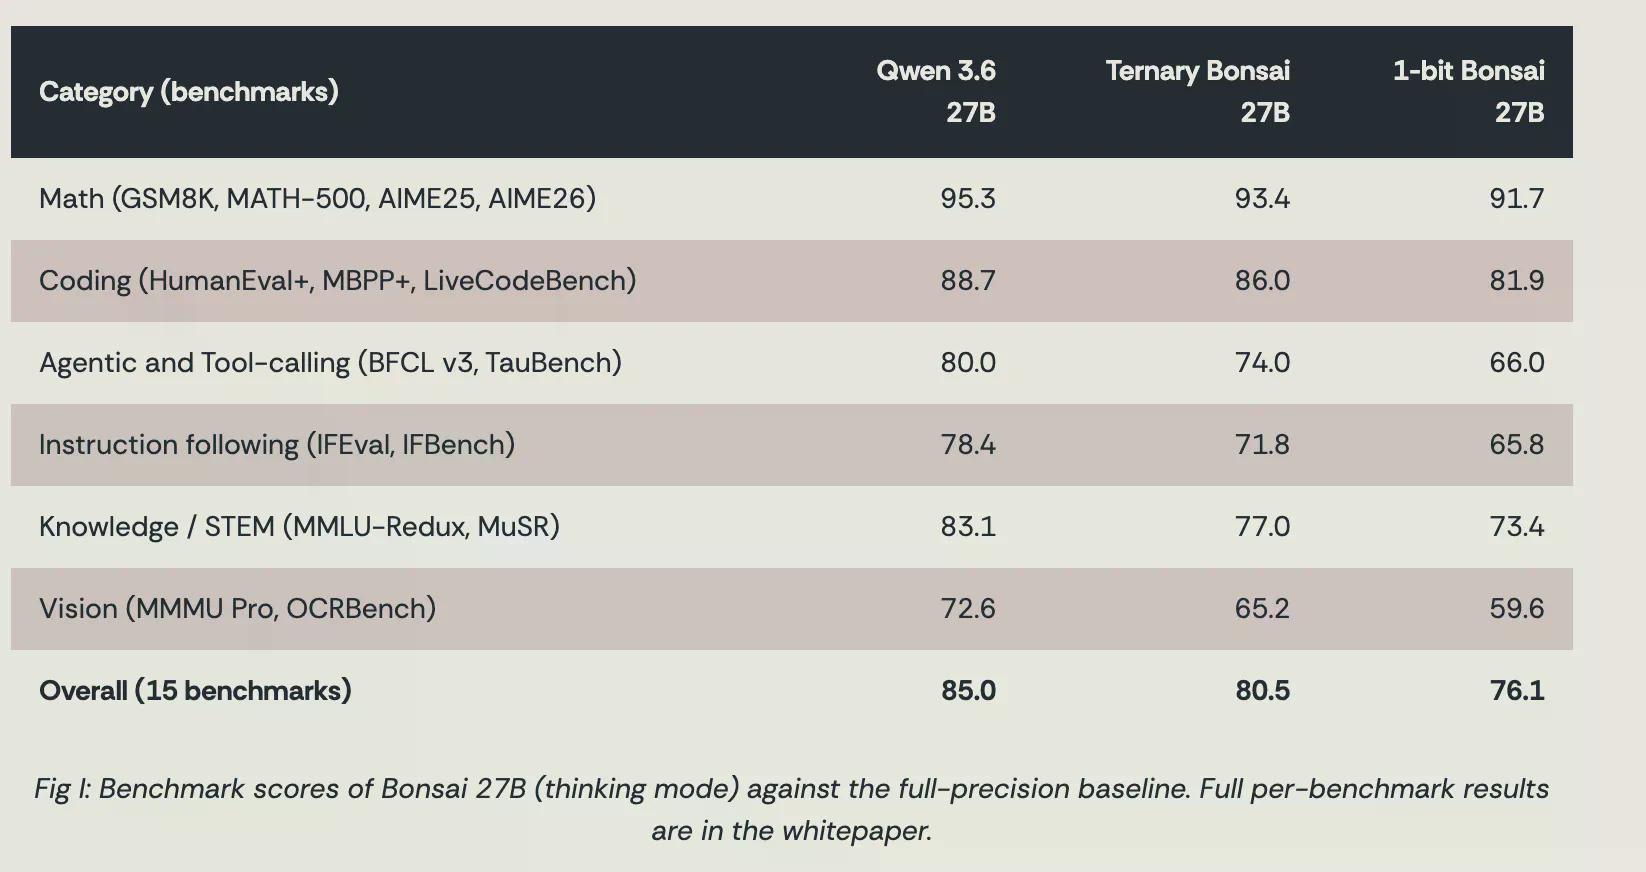
NVIDIA H100 GPUs पर सोच मोड में मूल्यांकन किए गए 15 बेंचमार्क में—जो ज्ञान, गणित, कोडिंग और उपकरण उपयोग तक फैले हुए हैं—टर्नरी बोन्साई 27B का औसत 80.49 है, या पूर्ण-परिशुद्धता मॉडल का 94.6%। 1-बिट वेरिएंट 76.11 पर पहुंचता है।
कुल मिलाकर, बेंचमार्क पर, मॉडल अपने आकार के लिए जितनी क्षमता प्रदान करते हैं, उस मामले में जेम्मा 4 या क्यूवेन 3.6 से काफी बेहतर प्रदर्शन करते हैं।
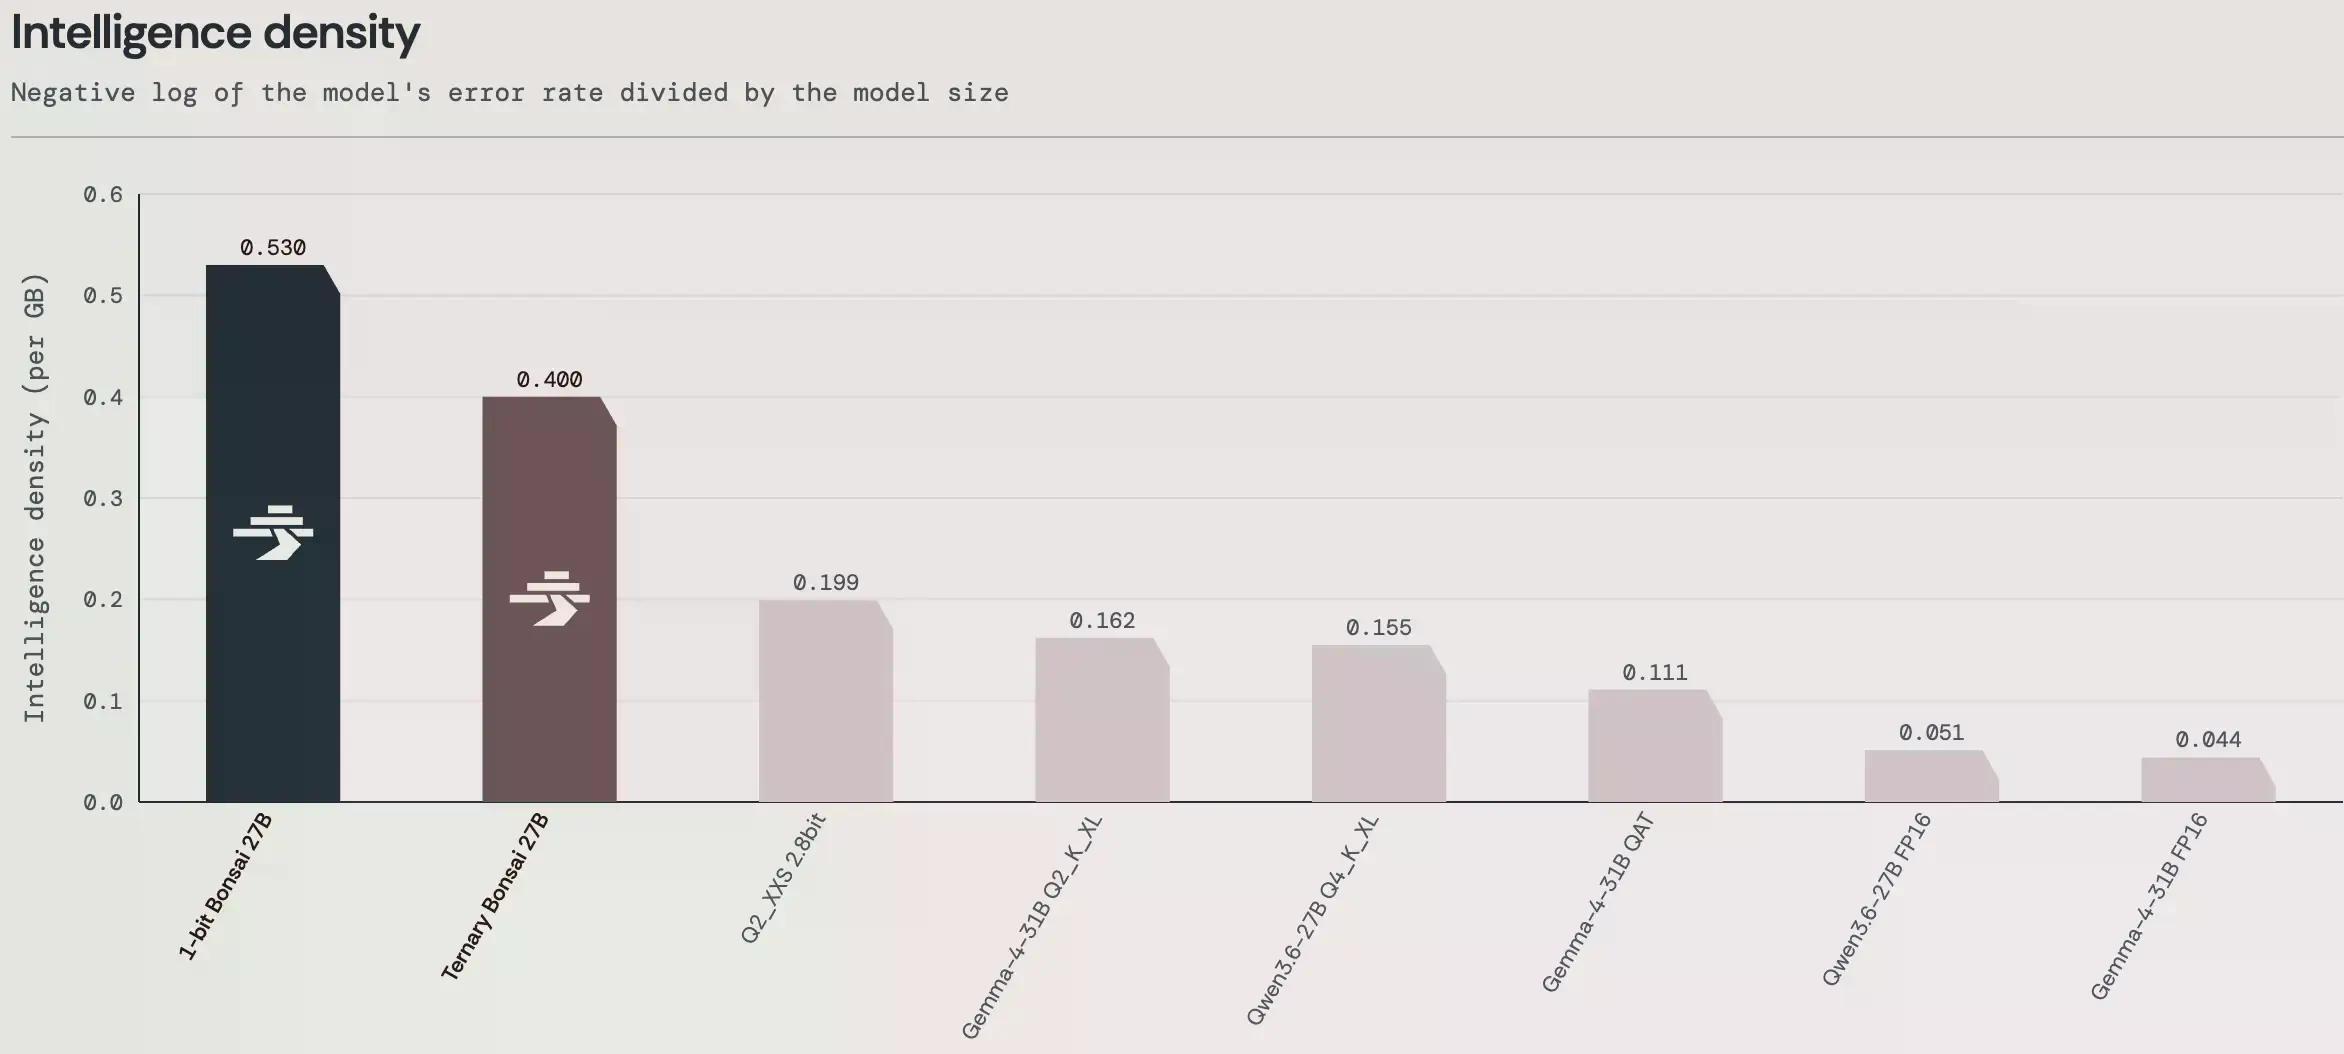
मॉडल जो प्रदान करते हैं उसके लिए काफी अच्छे हैं, और उन्हें कितनी कम संसाधनों की आवश्यकता होती है, इसे देखते हुए, वे छोटे हार्डवेयर (स्मार्टफोन और निचले स्तर के पीसी) को क्षमताओं के मामले में एक और स्तर पर ले जाते हैं। अमेरिकी इनविटेशनल मैथमेटिक्स एग्जामिनेशन पर आधारित AIME25 और AIME26 में टर्नरी बोन्साई 27B के लिए 93.7% बनाम बहुत बड़े क्यूवेन 3.6B के लिए 95.3% आते हैं। कोडिंग में बोन्साई 86 अंक प्राप्त करता है जबकि क्यूवेन 3.6 के लिए 88 और सामान्य ज्ञान में 77% जबकि क्यूवेन 3.6 के लिए 83।
यह मॉडल एक हाइब्रिड अटेंशन बैकबोन का भी उपयोग करता है जहाँ लगभग 75% परतें पूर्ण क्वाड्रैटिक अटेंशन के बजाय रैखिक होती हैं। यह आर्किटेक्चर ही एक 262K-टोकन संदर्भ विंडो को डिवाइस पर व्यावहारिक बनाता है—एक मानक अटेंशन स्टैक फोन हार्डवेयर पर इसे अत्यधिक महंगा बना देगा।
हमने बोन्साई 27B को स्वयं चलाया। कोडिंग में पुनरावृति (iteration) लगती है: सिंगल-शॉट प्रॉम्प्ट क्लाउड फ्रंटियर मॉडल के साथ प्रतिस्पर्धा नहीं करेंगे। स्थानीय और मुफ्त होने से यह अप्रासंगिक हो जाता है। हमारे ज़ोंबी टाइप गेम के लिए—एक फर्स्ट-पर्सन टाइपिंग-हॉरर ब्राउज़र गेम—दो वाइब कोडिंग राउंड ने साफ टक्कर का पता लगाने, उचित स्कोरिंग तर्क और ग्राफिक्स का उत्पादन किया जो एक साथ टिके रहे। मॉडल संरचना को जल्दी समझ लेता है; दूसरा पास पुनर्निर्माण के बजाय परिष्कृत करता है।
दिलचस्प बात यह है कि कुछ मॉडल (जैसे कंकाल) GPT 5.6 सोल के मॉडलों की तुलना में अधिक विस्तृत दिखे। इसका मतलब यह नहीं है कि यह किसी भी तरह से बेहतर है, बस यह कि इस कार्य पर इसने एक प्यारा कंकाल बनाया जबकि AI किंग ने एक खराब शैलीगत पसंद की।
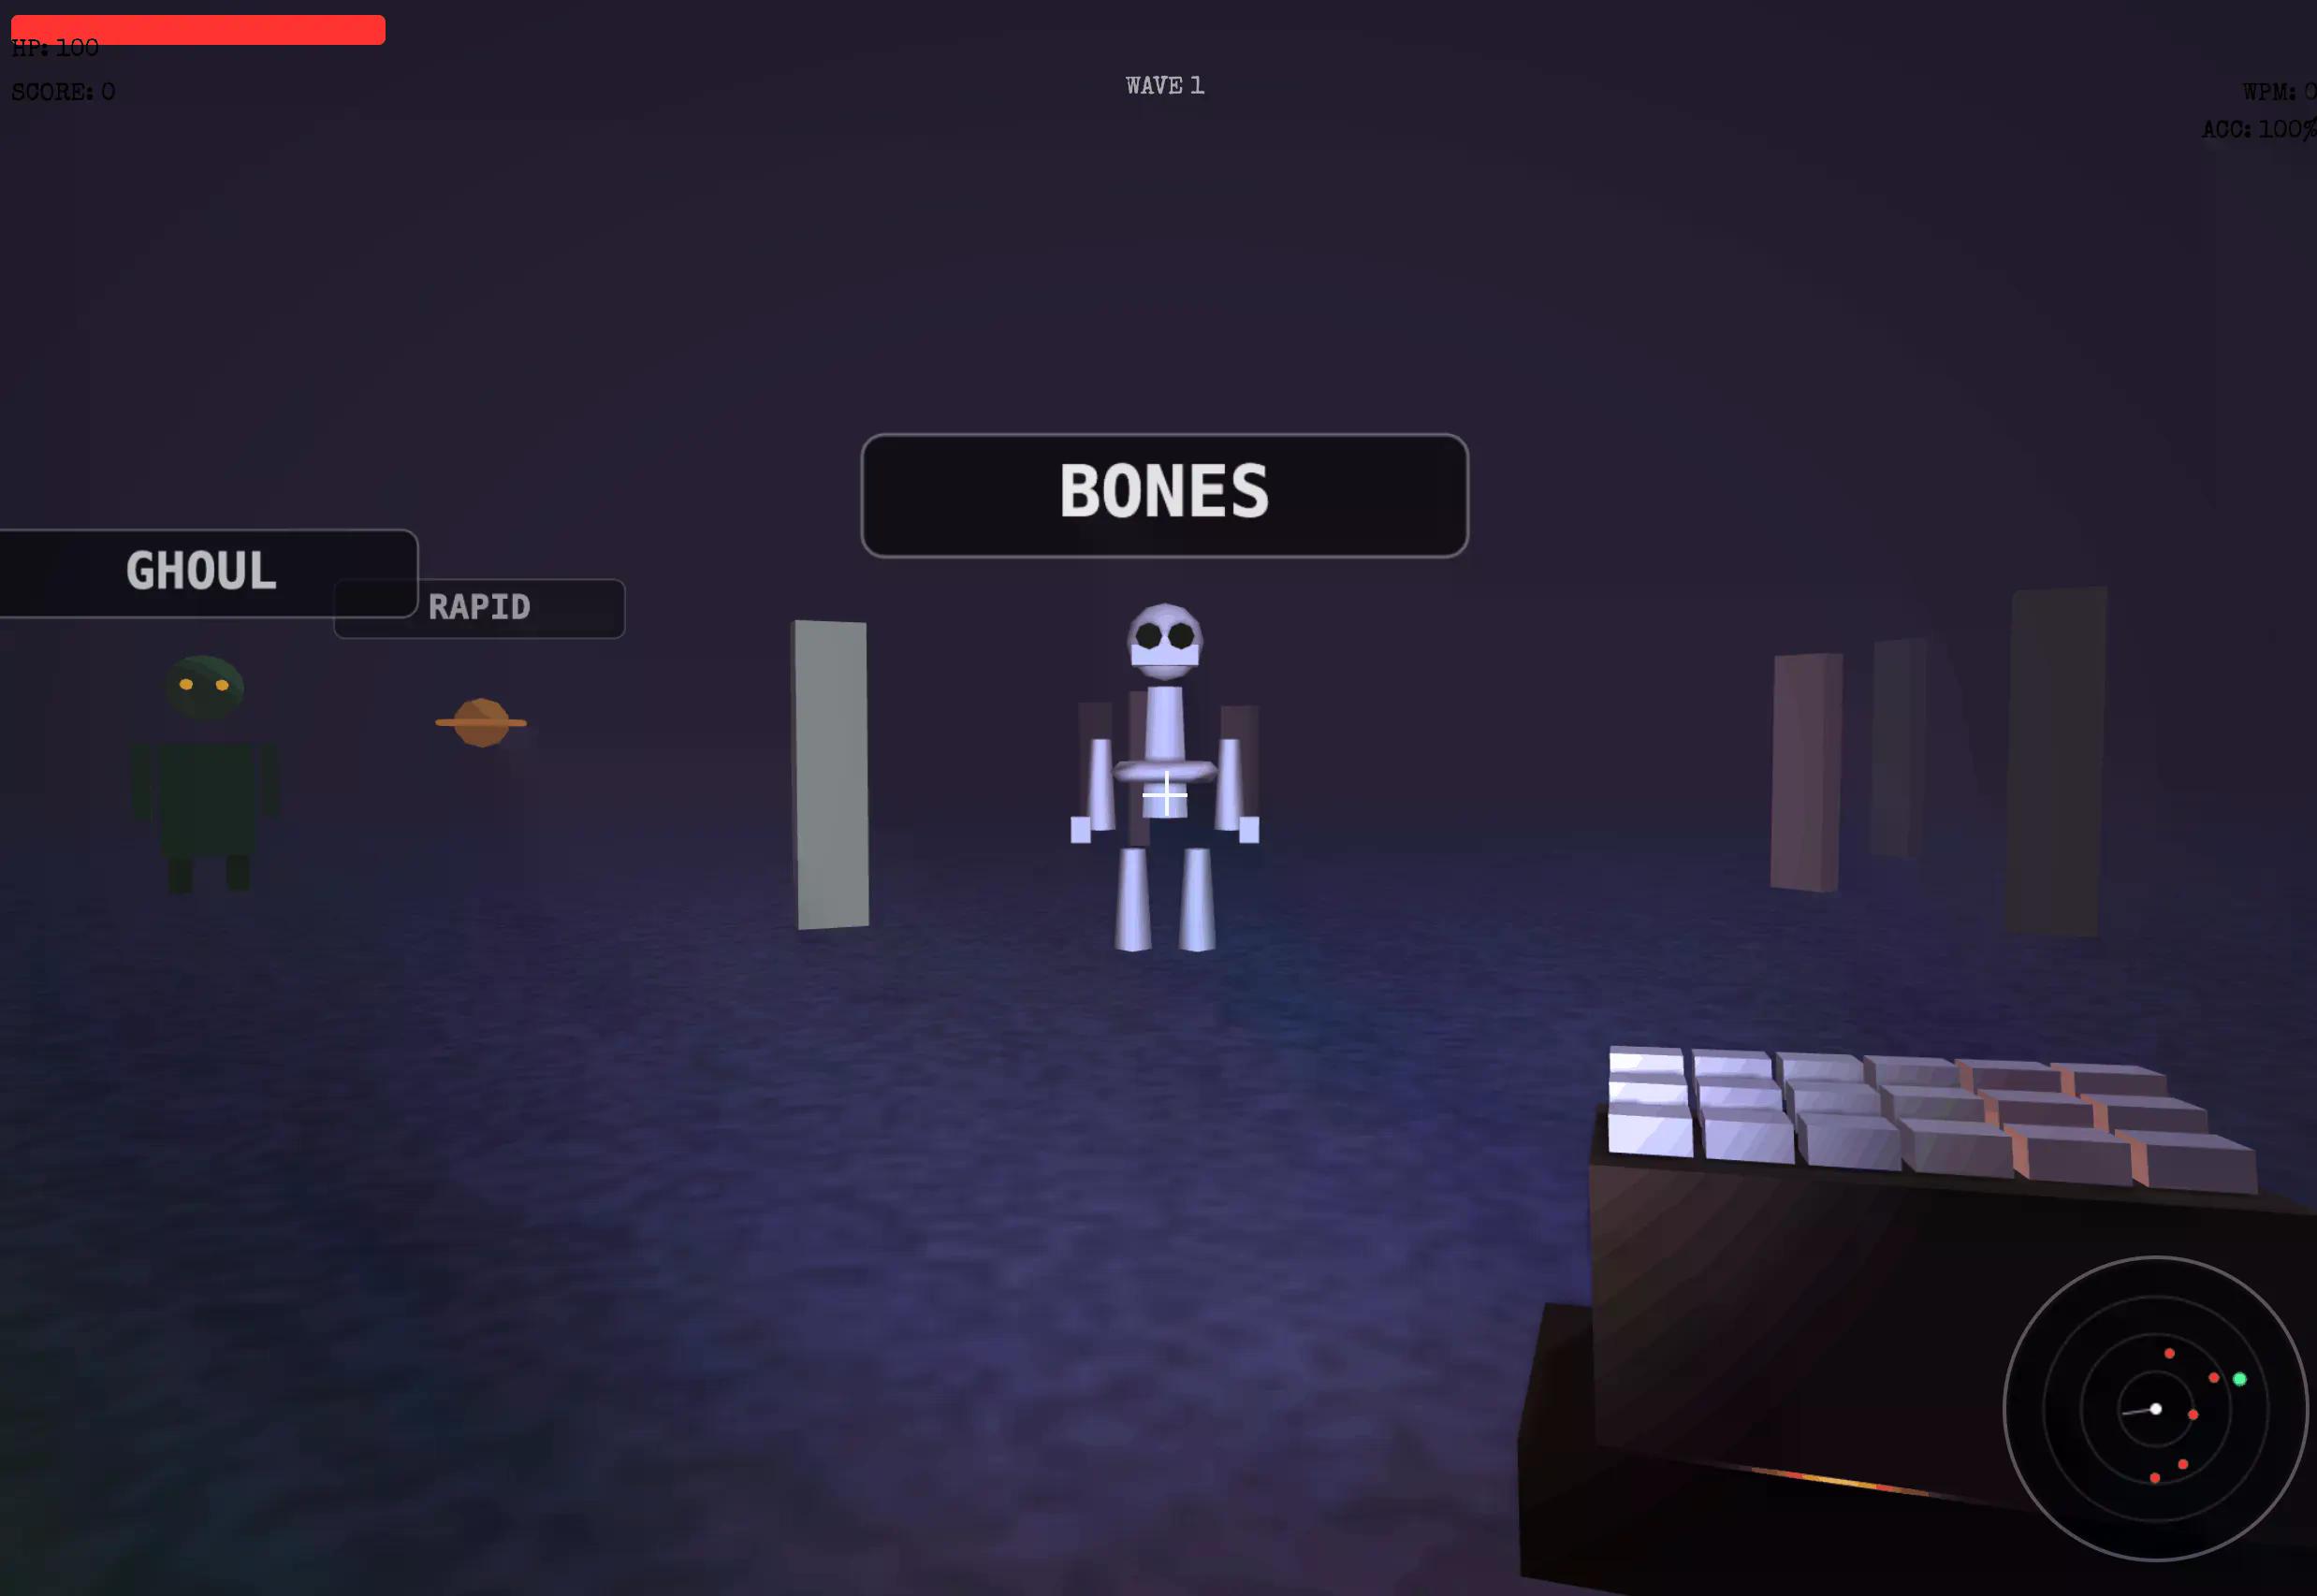
गेम यहां परीक्षण के लिए उपलब्ध है।
रचनात्मक लेखन एक अधिक योग्य कहानी है, और मानदंड अधिक व्यक्तिपरक हैं।
मोटे तौर पर कहें तो, यदि आपके मन में कोई जीरो-शॉट प्रॉम्प्ट है तो परिणाम विशेष रूप से कल्पनाशील नहीं होते हैं।
इसके बावजूद, बोन्साई सुसंगत आंतरिक तर्क, गति और चाप के साथ कहानियां बनाता है—तुलनीय प्रॉम्प्ट पर कम प्रयास के साथ क्लाउड हाइकू या यहां तक कि सॉनेट के बराबर या उससे बेहतर। एक ऐसे मॉडल के लिए जो बिना किसी एपीआई लागत के आपके अपने हार्डवेयर पर पूरी तरह से चलता है, यह बहुत कुछ कहता है।
इसके द्वारा बनाई गई कहानी हमारे गिटहब रिपॉजिटरी में पाई जा सकती है।
PrismML मॉडल के साथ एक DSpark स्पेकुलेटिव डिकोडिंग लेयर भी भेजता है—एक हल्का ड्राफ्टर जो उम्मीदवार टोकन के ब्लॉक प्रस्तावित करता है, जिसे मुख्य मॉडल टोकन-बाय-टोकन उत्पन्न करने के बजाय एक ही फॉरवर्ड पास में सत्यापित करता है। H100 पर यह आउटपुट गुणवत्ता में कोई बदलाव किए बिना 1.37 गुना थ्रूपुट बूस्ट जोड़ता है, क्योंकि सत्यापन सटीक आउटपुट वितरण को संरक्षित करता है। Apple सिलिकॉन पर यह अभी तक डिफ़ॉल्ट रूप से सक्षम नहीं है, लेकिन GPU सर्विंग के लिए यह एक वास्तविक लाभ है।
Apple की रुचि एक व्यावसायिक आयाम जोड़ती है। PrismML के सीईओ बाबर हसीब ने CNBC को पुष्टि की कि कंपनी Apple के साथ प्रारंभिक बातचीत कर रही है, जो संभावित ऑन-डिवाइस उपयोग के लिए संपीड़न तकनीक का मूल्यांकन कर रही है।
हसीब ने कहा कि अगला पाइपलाइन में एक संपीड़ित जेम्मा मॉडल है, जिसके बाद बड़े फ्रंटियर मॉडल आएंगे; 1-बिट बोन्साई 27B अब अपाचे 2.0 के तहत मुफ्त डाउनलोड के लिए उपलब्ध है। यदि आपको इस तरह के मॉडल को स्थानीय रूप से चलाने के लिए एक प्राइमर की आवश्यकता है, तो हमारी मार्गदर्शिका देखें।







