

डीपसीक वापस आ गया है, और यह OpenAI द्वारा GPT-5.5 जारी करने के कुछ घंटों बाद सामने आया। क्या यह संयोग है? शायद। लेकिन अगर आप एक चीनी AI लैब हैं जिसे अमेरिकी सरकार पिछले तीन सालों से चिप निर्यात प्रतिबंधों के साथ धीमा करने की कोशिश कर रही है, तो आपकी समय की समझ काफी तेज हो जाती है।
हांगझोऊ स्थित लैब ने आज डीपसीक-V4-प्रो और डीपसीक-V4-फ्लैश के पूर्वावलोकन संस्करण जारी किए, दोनों ही ओपन-वेट हैं, दोनों में एक मिलियन टोकन संदर्भ विंडो हैं। इसका मतलब है कि आप मॉडल के ढहने से पहले लॉर्ड ऑफ द रिंग्स ट्रिलॉजी के आकार के संदर्भ के साथ काम कर सकते हैं। दोनों की कीमतें भी पश्चिम में किसी भी तुलनीय चीज़ से काफी कम हैं, और जो लोग स्थानीय रूप से चलाने में सक्षम हैं उनके लिए दोनों मुफ्त हैं।
डीपसीक की पिछली बड़ी बाधा—जनवरी 2025 में R1—ने एक ही दिन में एनवीडिया के बाजार पूंजीकरण से $600 बिलियन मिटा दिए क्योंकि निवेशकों ने सवाल किया कि क्या अमेरिकी कंपनियों को इतने बड़े निवेश की वास्तव में जरूरत थी ताकि एक छोटी चीनी लैब लागत के एक अंश में परिणाम प्राप्त कर सके। V4 एक अलग तरह का कदम है: शांत, अधिक तकनीकी, और AI के साथ वास्तव में कुछ भी बनाने वाले किसी भी व्यक्ति के लिए दक्षता पर अधिक केंद्रित।
दो नए मॉडलों में से, डीपसीक का V4-प्रो बड़ा है, जिसमें कुल 1.6 ट्रिलियन मापदंड हैं। इसे परिप्रेक्ष्य में रखने के लिए, मापदंड आंतरिक "सेटिंग्स" या "मस्तिष्क कोशिकाएं" हैं जिनका उपयोग एक मॉडल ज्ञान को संग्रहित करने और पैटर्न को पहचानने के लिए करता है—जितने अधिक मापदंड एक मॉडल में होते हैं, उतनी ही जटिल जानकारी वह सैद्धांतिक रूप से धारण कर सकता है। यह इसे आज तक LLM बाजार में सबसे बड़ा ओपन-सोर्स मॉडल बनाता है। यह आकार तब तक हास्यास्पद लग सकता है जब तक आपको यह पता न चले कि यह प्रति अनुमान पास पर केवल 49 बिलियन को सक्रिय करता है।
यह मिक्सचर-ऑफ-एक्सपर्ट्स ट्रिक है जिसे डीपसीक ने V3 से परिष्कृत किया है: पूरा मॉडल वहीं रहता है, लेकिन किसी भी दिए गए अनुरोध के लिए उसका केवल प्रासंगिक हिस्सा जागृत होता है। अधिक ज्ञान, वही कंप्यूट बिल।
“डीपसीक-V4-प्रो-मैक्स, डीपसीक-V4-प्रो का अधिकतम तर्क प्रयास मोड, ओपन-सोर्स मॉडलों की ज्ञान क्षमताओं को महत्वपूर्ण रूप से आगे बढ़ाता है, आज उपलब्ध सर्वोत्तम ओपन-सोर्स मॉडल के रूप में खुद को मजबूती से स्थापित करता है,” डीपसीक ने मॉडल के आधिकारिक कार्ड पर हगिंगफेस पर लिखा। “यह कोडिंग बेंचमार्क में शीर्ष-स्तरीय प्रदर्शन प्राप्त करता है और तर्क और एजेंटिक कार्यों पर प्रमुख बंद-स्रोत मॉडलों के साथ अंतर को काफी हद तक कम करता है।”
V4-फ्लैश व्यावहारिक है: 284 बिलियन कुल मापदंड, 13 बिलियन सक्रिय। इसे तेज, सस्ता और डीपसीक के अपने बेंचमार्क के अनुसार, "बड़े विचार बजट दिए जाने पर प्रो संस्करण के समान तर्क प्रदर्शन प्राप्त करने" के लिए डिज़ाइन किया गया है।
दोनों एक मिलियन टोकन के संदर्भ का समर्थन करते हैं। यह लगभग 750,000 शब्द हैं—लगभग पूरी "लॉर्ड ऑफ द रिंग्स" ट्रिलॉजी और कुछ अतिरिक्त। और यह एक मानक सुविधा के रूप में है, न कि प्रीमियम टियर के रूप में।
यहां तकनीकी हिस्सा उन लोगों के लिए है जो इस मॉडल को शक्ति देने वाले जादू में रुचि रखते हैं। डीपसीक अपने रहस्य नहीं छिपाता, और सब कुछ मुफ्त में उपलब्ध है—पूरा पेपर गिटहब पर उपलब्ध है।
मानक AI अटेंशन—वह तंत्र जो एक मॉडल को शब्दों के बीच संबंधों को समझने देता है—में एक क्रूर स्केलिंग समस्या है। हर बार जब आप संदर्भ की लंबाई दोगुनी करते हैं, तो कंप्यूट लागत लगभग चौगुनी हो जाती है। इसलिए एक मिलियन टोकन पर एक मॉडल चलाना केवल 500,000 टोकन से दोगुना महंगा नहीं है। यह चार गुना महंगा है। यही कारण है कि लंबे संदर्भ को ऐतिहासिक रूप से एक चेकबॉक्स के रूप में जोड़ा गया है और फिर रेट लिमिट्स के पीछे चुपचाप प्रतिबंधित कर दिया जाता है।
डीपसीक ने इससे बचने के लिए दो नए प्रकार के अटेंशन का आविष्कार किया। पहला, कंप्रेस्ड स्पार्स अटेंशन, दो चरणों में काम करता है। यह पहले टोकन के समूहों—जैसे, हर 4 टोकन—को एक ही एंट्री में संपीड़ित करता है। फिर, उन सभी संपीड़ित प्रविष्टियों पर ध्यान देने के बजाय, यह किसी भी दिए गए प्रश्न के लिए केवल सबसे प्रासंगिक परिणामों को चुनने के लिए "लाइटनिंग इंडेक्सर" का उपयोग करता है। आपका मॉडल एक मिलियन टोकन पर ध्यान देने से हटकर सबसे महत्वपूर्ण हिस्सों के एक बहुत छोटे सेट पर ध्यान देता है, कुछ हद तक एक लाइब्रेरियन की तरह जो हर किताब नहीं पढ़ता लेकिन जानता है कि कौन सी शेल्फ को जांचना है।
दूसरा, हेवीली कंप्रेस्ड अटेंशन, अधिक आक्रामक है। यह हर 128 टोकन को एक ही एंट्री में ढहा देता है—कोई स्पार्स चयन नहीं, बस क्रूर संपीड़न। आप बारीक विवरण खो देते हैं, लेकिन आपको एक बेहद सस्ता वैश्विक दृश्य मिलता है। दोनों अटेंशन प्रकार वैकल्पिक परतों में चलते हैं, ताकि मॉडल को विवरण और अवलोकन दोनों मिलें।
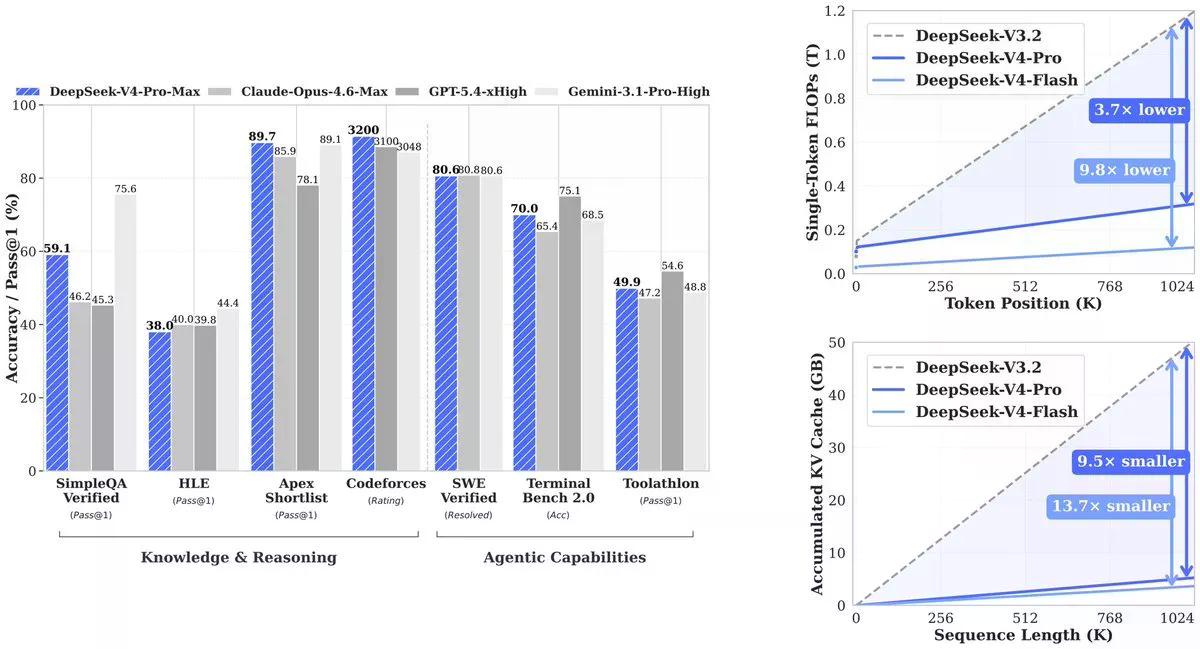
तकनीकी पेपर से परिणाम: एक मिलियन टोकन पर, V4-प्रो अपने पूर्ववर्ती (V3.2) की आवश्यक कंप्यूट का 27% उपयोग करता है। KV कैश—मॉडल को संदर्भ ट्रैक करने के लिए आवश्यक मेमोरी—V3.2 के केवल 10% तक गिर जाती है। V4-फ्लैश इसे और आगे बढ़ाता है: कंप्यूट का 10%, मेमोरी का 7%।
और इसका परिणाम यह हुआ कि डीपसीक अपने प्रतिस्पर्धियों की तुलना में प्रति टोकन बहुत सस्ती कीमत पर, तुलनीय परिणाम प्रदान करने में सक्षम था। इसे डॉलर के संदर्भ में कहें तो: GPT-5.5 कल प्रति मिलियन टोकन $5 इनपुट और $30 आउटपुट पर लॉन्च हुआ, जिसमें GPT-5.5 प्रो प्रति मिलियन इनपुट टोकन $30 और प्रति मिलियन आउटपुट टोकन $180 पर था।
डीपसीक V4-प्रो $1.74 इनपुट और $3.48 आउटपुट है। V4-फ्लैश $0.14 इनपुट और $0.28 आउटपुट है। क्लाइन के सीईओ सौद रिजवान ने बताया कि अगर उबर ने क्लॉड के बजाय डीपसीक का इस्तेमाल किया होता, तो उसका 2026 का AI बजट—जो कथित तौर पर चार महीने के उपयोग के लिए पर्याप्त था—सात साल तक चलता।
deepseek v4 is now the cheapest sota model available at 1/20th the cost of opus 4.7.
for perspective, if uber used deepseek instead of claude their 2026 ai budget would have lasted 7 years instead of only 4 months. pic.twitter.com/i9rJZzvRBV
— Saoud Rizwan (@sdrzn) April 24, 2026
डीपसीक अपनी तकनीकी रिपोर्ट में कुछ असामान्य करता है: यह अंतर प्रकाशित करता है। अधिकांश मॉडल रिलीज़ उन बेंचमार्क को चुनते हैं जहां वे जीतते हैं। डीपसीक ने GPT-5.4 और जेमिनी-3.1-प्रो के खिलाफ पूरी तुलना की, पाया कि V4-प्रो का तर्क उन मॉडलों से लगभग तीन से छह महीने पीछे है, और इसे वैसे ही प्रकाशित कर दिया।
जहां V4-प्रो-मैक्स वास्तव में जीतता है: कोडफोर्सेस, प्रतिस्पर्धी प्रोग्रामिंग बेंचमार्क, मानव शतरंज की तरह रेटेड। V4-प्रो ने 3,206 अंक प्राप्त किए, जिससे यह वास्तविक मानव प्रतियोगिता प्रतिभागियों में 23वें स्थान पर रहा। एपेक्स शॉर्टलिस्ट पर, कठिन गणित और STEM समस्याओं का एक क्यूरेटेड सेट, इसने पास दर हासिल की और ओपस 4.6 के 85.9% और GPT-5.4 के 78.1% के मुकाबले 90.2% पर पहुंच गया। SWE-वेरिफाइड पर, जो मापता है कि एक मॉडल वास्तविक ओपन-सोर्स रिपॉजिटरी से खींचे गए वास्तविक गिटहब मुद्दों को हल कर सकता है या नहीं, इसने 80.6% अंक प्राप्त किए—क्लॉड ओपस 4.6 के बराबर।
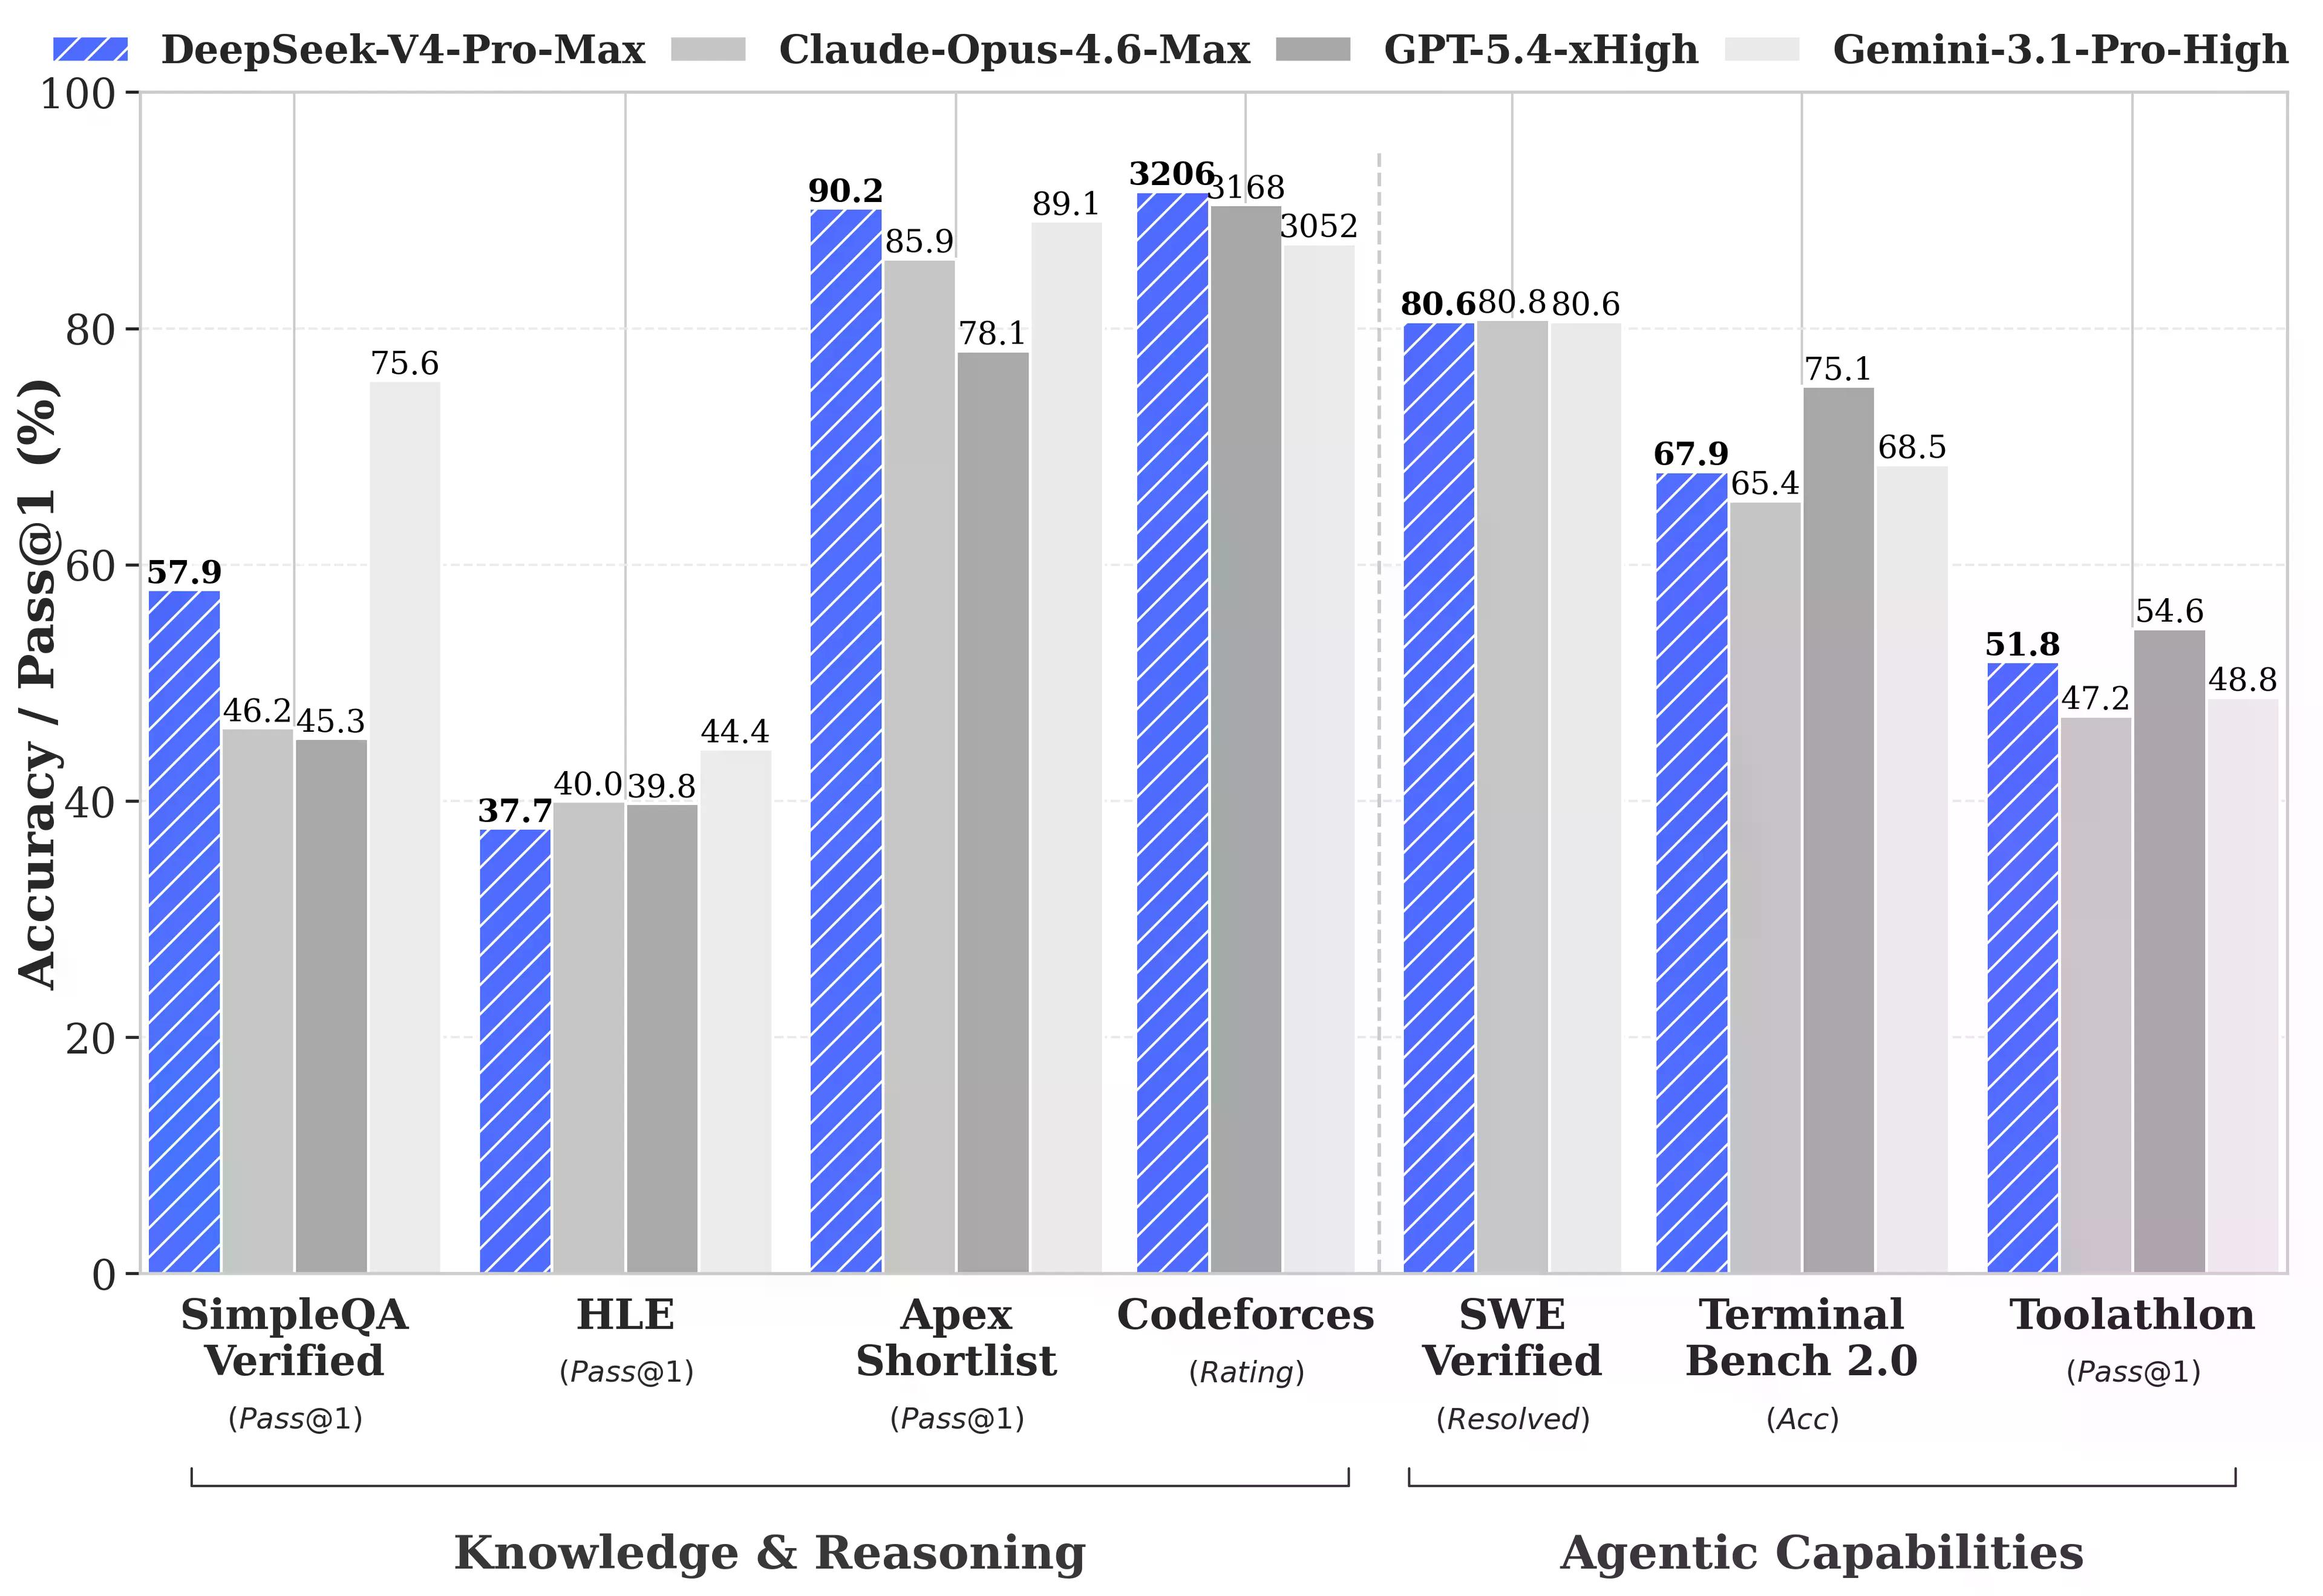
जहां यह पीछे रह जाता है: मल्टीटास्किंग बेंचमार्क MMLU-प्रो (जेमिनी-3.1-प्रो 91.0% बनाम V4-प्रो 87.5%), विशेषज्ञ ज्ञान बेंचमार्क GPQA डायमंड (जेमिनी 94.3 बनाम V4-प्रो 90.1), और ह्यूमैनिटीज़ लास्ट एग्जाम, एक स्नातक-स्तरीय बेंचमार्क जहां जेमिनी-3.1-प्रो का 44.4% अभी भी V4-प्रो के 37.7% से बेहतर है।
विशेष रूप से लंबे संदर्भ पर, V4-प्रो ओपन-सोर्स मॉडलों का नेतृत्व करता है और कॉर्पसक्यूए बेंचमार्क (एक मिलियन टोकन पर वास्तविक दस्तावेज़ विश्लेषण का अनुकरण करने वाला परीक्षण) पर जेमिनी-3.1-प्रो को हराता है, लेकिन MRCR पर क्लॉड ओपस 4.6 से हार जाता है—एक परीक्षण जो मापता है कि एक मॉडल कितनी अच्छी तरह से एक बहुत लंबी घास के ढेर में गहरे दबी विशिष्ट सुइयों को पुनः प्राप्त करता है।
एजेंटिक चीजें वहीं हैं जहां यह रिलीज़ उत्पादों को वास्तव में शिप करने वाले डेवलपर्स के लिए दिलचस्प हो जाती है।
V4-प्रो क्लाउड कोड, ओपनकोड और अन्य AI कोडिंग टूल्स में चल सकता है। डीपसीक के 85 डेवलपर्स के आंतरिक सर्वेक्षण के अनुसार जिन्होंने V4-प्रो को अपने प्राथमिक कोडिंग एजेंट के रूप में इस्तेमाल किया, 52% ने कहा कि यह उनका डिफॉल्ट मॉडल बनने के लिए तैयार था, 39% ने हां की ओर झुकाव दिखाया, और 9% से कम ने नहीं कहा। आंतरिक कर्मचारियों ने कहा कि यह एजेंटिक कोडिंग कार्यों पर क्लाउड सोननेट से बेहतर प्रदर्शन करता है और क्लाउड ओपस 4.5 के करीब पहुंचता है।
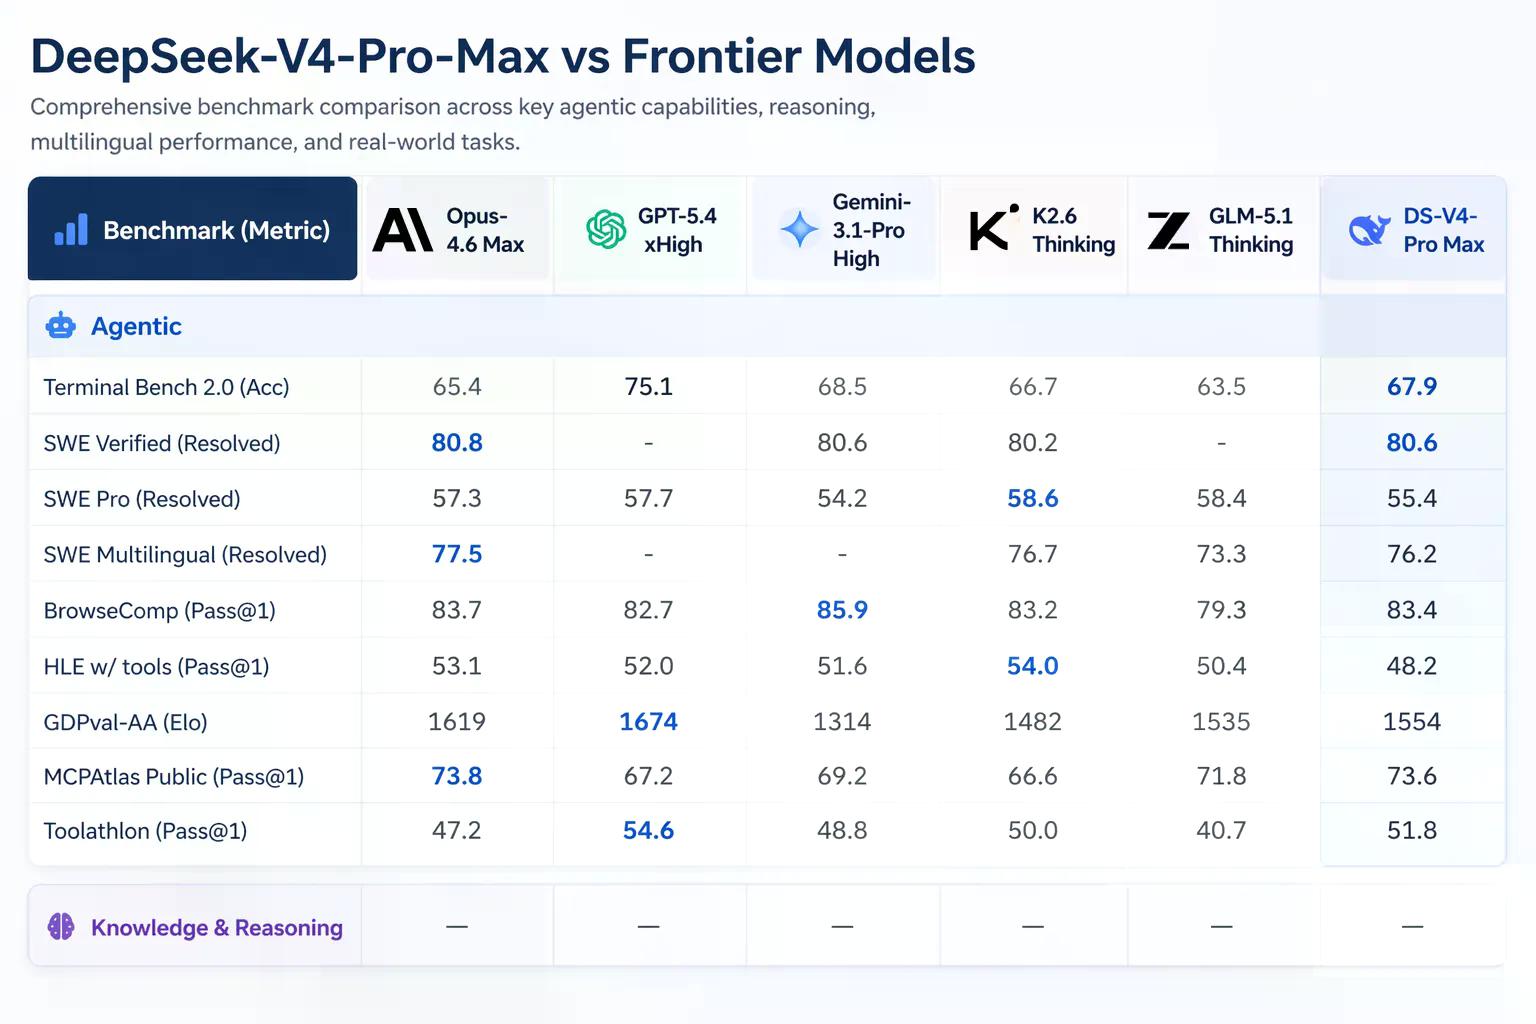
आर्टिफिशियल एनालिसिस, जो वास्तविक दुनिया के कार्यों पर AI मॉडलों का स्वतंत्र मूल्यांकन करता है, ने GDPval-AA पर सभी ओपन-वेट मॉडलों में V4-प्रो को पहला स्थान दिया—यह वित्त, कानूनी और अनुसंधान कार्यों में आर्थिक रूप से मूल्यवान ज्ञान कार्य का परीक्षण करने वाला एक बेंचमार्क है, जिसे एलो के माध्यम से स्कोर किया गया है। V4-प्रो-मैक्स ने 1,554 एलो स्कोर किया, जो GLM-5.1 (1,535) और MiniMax के M2.7 (1,514) से आगे है। संदर्भ के लिए, क्लाउड ओपस 4.6 इसी बेंचमार्क पर 1,619 स्कोर करता है—अभी भी आगे है, लेकिन अंतर कम हो रहा है।
DeepSeek V4 Pro is the #1 open weights model on GDPval-AA, our agentic real-world work tasks evaluation@deepseek_ai has released V4 Pro (1.6T total / 49B active) and V4 Flash (284B total / 13B active). V4 is DeepSeek's first new size since V3, with all intermediate models… pic.twitter.com/2kJWVrKQjF
— Artificial Analysis (@ArtificialAnlys) April 24, 2026
डीपसीक का V4 "इंटरलीव्ड थिंकिंग" नामक कुछ भी पेश करता है। पिछले मॉडलों में, यदि आप एक एजेंट चला रहे थे जिसने कई टूल कॉल किए थे—उदाहरण के लिए, इसने वेब पर खोज की, फिर कुछ कोड चलाया, फिर फिर से खोज की—तो मॉडल का तर्क संदर्भ राउंड के बीच फ्लश हो जाता था। प्रत्येक नए चरण में, मॉडल को खरोंच से अपना मानसिक मॉडल फिर से बनाना पड़ता था। V4 टूल कॉल के दौरान विचार की पूरी श्रृंखला को बनाए रखता है, इसलिए 20-चरणीय एजेंट वर्कफ़्लो बीच में स्मृतिभ्रंश से पीड़ित नहीं होता है। यह जटिल स्वचालित पाइपलाइन चलाने वाले किसी भी व्यक्ति के लिए जितना लगता है उससे कहीं अधिक मायने रखता है।
अमेरिका 2022 से चीन को उच्च-स्तरीय एनवीडिया चिप निर्यात को प्रतिबंधित कर रहा है। घोषित लक्ष्य चीनी AI विकास को धीमा करना था, लेकिन चिप प्रतिबंध ने डीपसीक को नहीं रोका और इसके बजाय उन्हें एक अधिक कुशल वास्तुकला का आविष्कार करने और घरेलू हार्डवेयर आपूर्ति का निर्माण करने के लिए मजबूर किया।
डीपसीक ने V4 को वैक्यूम में जारी नहीं किया—AI क्षेत्र हाल ही में गतिविधि से भरा हुआ है: एंथ्रोपिक ने 16 अप्रैल को क्लाउड ओपस 4.7 भेजा—एक मॉडल जिसे डिक्रिप्ट ने कोडिंग और तर्क पर मजबूत पाया, जिसमें विशेष रूप से उच्च टोकन उपयोग था। उससे एक दिन पहले, एंथ्रोपिक क्लाउड मिथोस पर भी बैठा था, एक साइबर सुरक्षा मॉडल जिसे उनका कहना है कि वे सार्वजनिक रूप से जारी नहीं कर सकते क्योंकि यह स्वायत्त नेटवर्क हमलों में बहुत अच्छा है।
श्याओमी ने 22 अप्रैल को MiMo V2.5 प्रो को गिरा दिया, जो पूर्ण मल्टीमॉडल—छवि, ऑडियो, वीडियो—पर चला गया। इसकी लागत प्रति मिलियन टोकन $1 इनपुट और $3 आउटपुट है। यह अधिकांश कोडिंग बेंचमार्क पर ओपस 4.6 से मेल खाता है। तीन महीने पहले, कोई भी श्याओमी को एक फ्रंटियर AI कंपनी के रूप में बात नहीं कर रहा था। अब यह अधिकांश पश्चिमी लैब की तुलना में तेजी से प्रतिस्पर्धी मॉडल भेज रहा है।
OpenAI का GPT-5.5 कल आया, जिसमें प्रो संस्करण में प्रति मिलियन टोकन आउटपुट की लागत $180 तक पहुंच गई। यह टर्मिनल बेंच 2.0 (82.7% बनाम 70.0%) पर V4-प्रो को हरा देता है, जो जटिल कमांड-लाइन एजेंट वर्कफ़्लो का परीक्षण करता है। लेकिन समान कार्यों के लिए V4-प्रो की तुलना में इसकी लागत काफी अधिक है। उसी दिन Tencent ने Hy3 जारी किया, एक और अत्याधुनिक मॉडल जो दक्षता पर केंद्रित है।
तो इतने सारे नए मॉडल उपलब्ध होने के साथ, डेवलपर्स वास्तव में यह सवाल पूछ रहे हैं: प्रीमियम कब लायक है?
उद्यमों के लिए, गणित बदल गया हो सकता है। एक मॉडल जो प्रति मिलियन इनपुट टोकन $1.74 पर ओपन-सोर्स बेंचमार्क का नेतृत्व करता है, इसका मतलब है कि बड़े पैमाने पर दस्तावेज़ प्रसंस्करण, कानूनी समीक्षा, या कोड जनरेशन पाइपलाइन जो छह महीने पहले महंगी थीं, अब बहुत सस्ती हैं। एक मिलियन-टोकन संदर्भ का मतलब है कि आप पूरे कोडबेस या नियामक फाइलिंग को कई कॉलों में विभाजित करने के बजाय एक ही अनुरोध में फीड कर सकते हैं।
इसके अलावा, इसकी ओपन-सोर्स प्रकृति का मतलब है कि इसे न केवल स्थानीय हार्डवेयर पर मुफ्त में चलाया जा सकता है, बल्कि इसे कंपनी की जरूरतों और उपयोग के मामलों के आधार पर अनुकूलित और बेहतर भी बनाया जा सकता है।
डेवलपर्स और अकेले बिल्डरों के लिए, V4-फ्लैश देखने लायक है। $0.14 इनपुट और $0.28 आउटपुट पर, यह उन मॉडलों की तुलना में सस्ता है जिन्हें एक साल पहले बजट विकल्प माना जाता था—और यह अधिकांश कार्यों को संभालता है जो प्रो संस्करण संभालता है। डीपसीक के मौजूदा डीपसीक-चैट और डीपसीक-रीज़नर एंडपॉइंट्स पहले से ही क्रमशः गैर-सोच और सोच मोड में V4-फ्लैश पर रूट करते हैं, इसलिए यदि आप API पर हैं, तो आप पहले से ही इसका उपयोग कर रहे हैं।
मॉडल अभी के लिए केवल टेक्स्ट-आधारित हैं। डीपसीक ने कहा कि वह मल्टीमॉडल क्षमताओं पर काम कर रहा है, जिसका मतलब है कि श्याओमी से लेकर OpenAI तक अन्य बड़ी लैब के पास अभी भी वह बढ़त है। दोनों मॉडल MIT लाइसेंस प्राप्त हैं और आज हगिंग फेस पर उपलब्ध हैं। पुराने डीपसीक-चैट और डीपसीक-रीज़नर एंडपॉइंट 24 जुलाई, 2026 को सेवानिवृत्त हो जाएंगे।







