

Anthropic ने मंगलवार को Claude Opus 5.5 जारी किया, जो कंपनी के कथित Claude 5.5 परिवार का पहला मॉडल है। Anthropic का कहना है कि नया मॉडल अधिकांश कार्यों में उसके सबसे महंगे फ्लैगशिप Claude Fable 5.1 के स्तर का प्रदर्शन करता है।
दिलचस्प बात यह है कि जिस Opus 5 मॉडल को यह रिप्लेस करता है, उसकी तुलना में इसे चलाने की लागत 20% कम है, और यह कंपनी की अत्याधुनिक पेशकश Fable 5.1 से 60% सस्ता है।
दिखने में यह मॉडल बेहद सक्षम है। यह वर्जन (5.5 बनाम Fable का 5.1) और फैमिली—दोनों ही मोर्चों पर सबसे उन्नत मॉडल है। Opus सार्वजनिक रूप से उपलब्ध सबसे बड़ा मॉडल है, इसके बाद Sonnet आता है, जबकि Haiku सबसे छोटा है।
Anthropic मानता है कि Fable और Opus के बीच का अंतर उसके बेंचमार्क स्कोर जितना बड़ा नहीं है, लेकिन किसी प्लान में सार्वजनिक रूप से उपलब्ध होना और प्रति टोकन कम लागत इसे अधिकांश Claude उपयोगकर्ताओं के लिए स्पष्ट विकल्प बनाता है।
Opus 5 जुलाई में लॉन्च हुआ था और उसने ज्यादातर बेंचमार्क्स पर Fable 5 की तुलना में कम कीमत के साथ बेहतर स्कोर दिए थे। फिर सितंबर की शुरुआत में Fable 5.1 आया और उसने तस्वीर बदल दी, क्योंकि उसने Anthropic द्वारा प्रकाशित हर बेंचमार्क पर Opus 5 को पीछे छोड़ दिया।
Opus 5.5 इस अंतर को फिर कम करता है, लेकिन इस बार कच्चे स्कोर नहीं बल्कि कीमत के मोर्चे पर। Lovable नामक एक डेवलपर प्लेटफॉर्म, जिसने जुलाई में Opus 5 को अपनी कोडिंग टेस्टिंग से गुजारा था, ने Anthropic द्वारा साझा एक बयान में कहा कि पिछला मॉडल उससे पहले आए मॉडल्स की तुलना में "ज्यादा स्थिर था, और रन-टू-रन वैरिएंस काफी कम था"—ठीक यही दक्षता वाला तर्क Anthropic अब फिर से दे रहा है।
Opus 5.5 वह पहला मॉडल भी है जिसे Anthropic ने CEO Dario Amodei के उस निबंध के बाद जारी किया है, जिसमें उन्होंने उद्योग से रफ्तार धीमी करने की अपील की थी। उनका तर्क था कि AI क्षमताओं में बढ़ोतरी उन सुरक्षा परीक्षणों से आगे निकल रही है, जो इन्हें नियंत्रण में रखने के लिए बनाए गए हैं। "हमें AI मॉडलों की क्षमताओं को बेहतर बनाने की गति धीमी करनी होगी," Amodei ने इस महीने की शुरुआत में लिखा था।
Anthropic इस प्रगति का अधिकांश हिस्सा एजेंटिक कोडिंग के जरिए मापता है—यानी ऐसा काम जो एक AI एजेंट द्वारा किया जाता है, ऐसा मॉडल जो सिर्फ एक प्रॉम्प्ट का जवाब देने के बजाय स्वयं कई-चरणीय कार्रवाई कर सकता है।
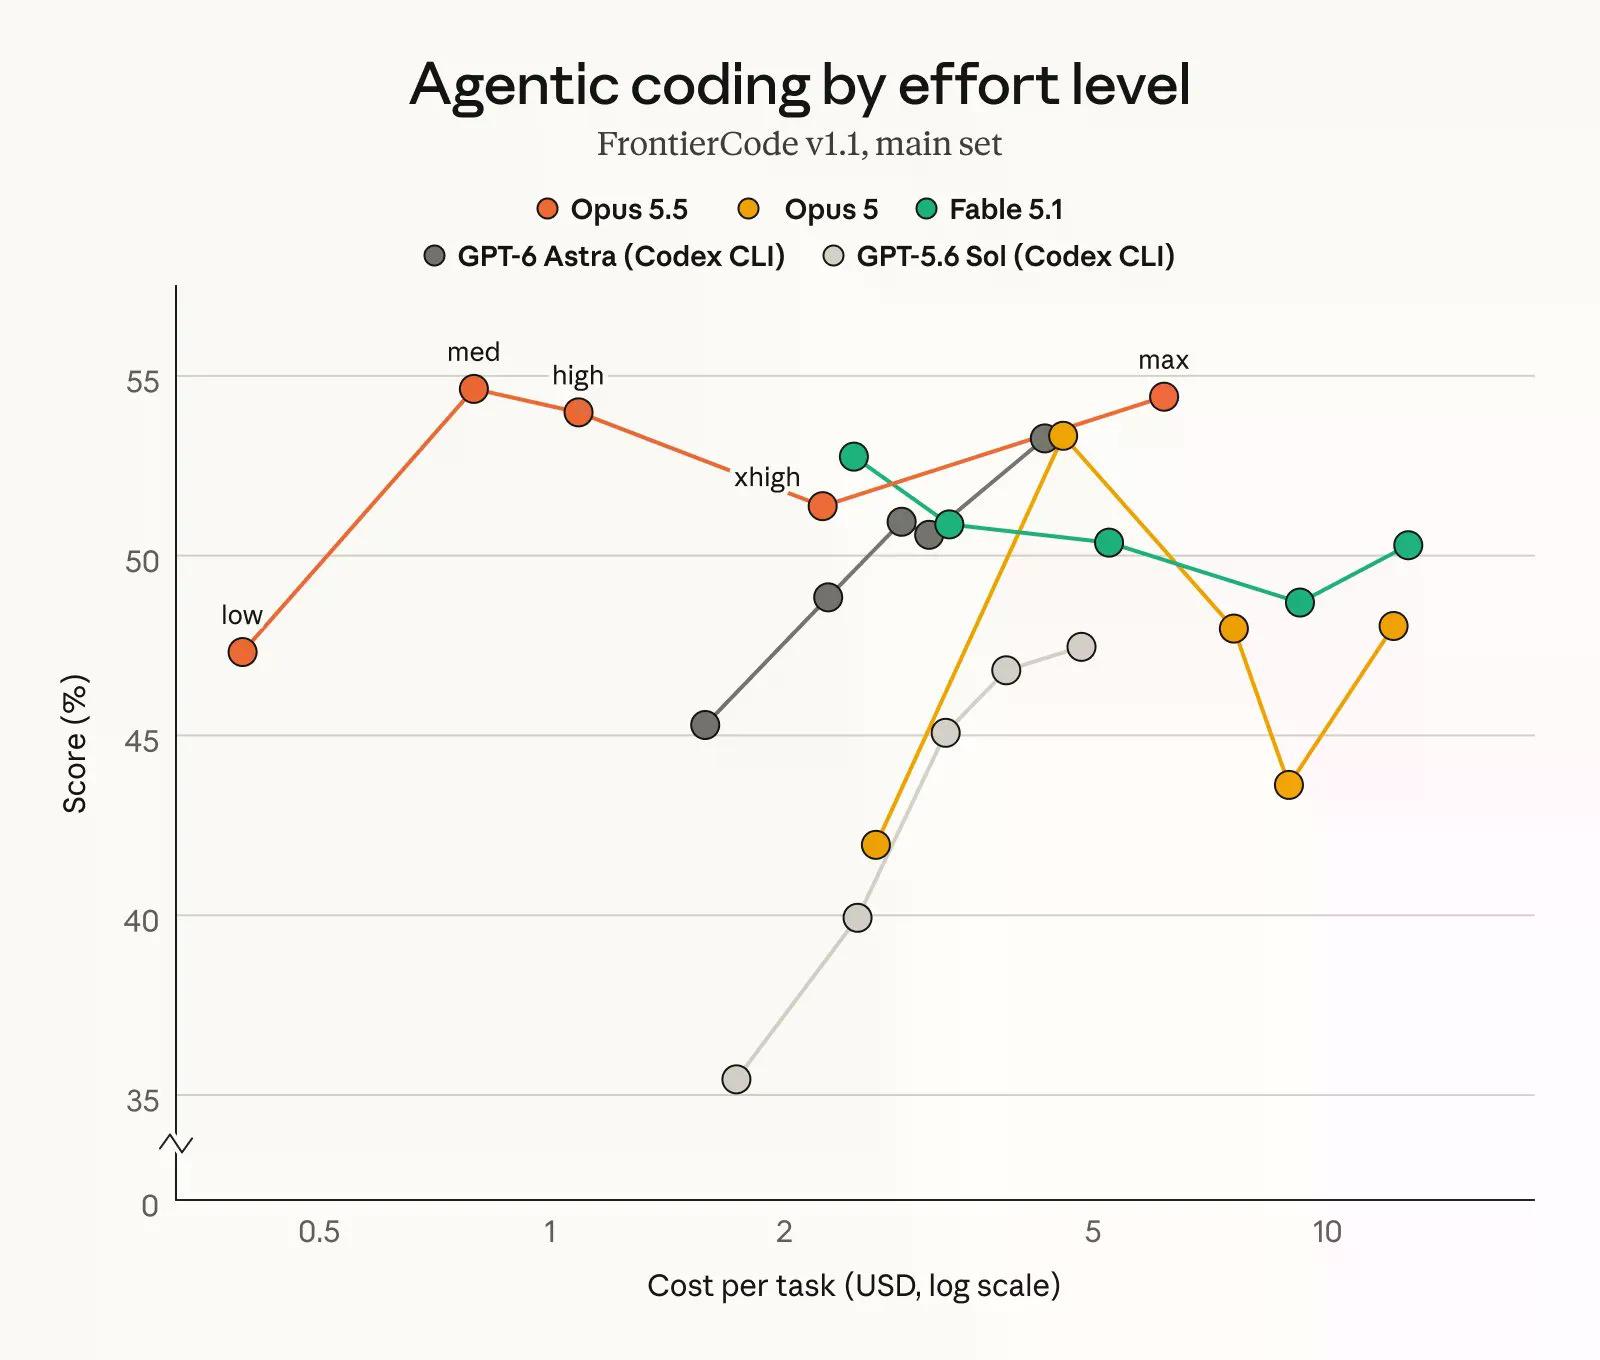
Terminal-Bench 4.0 पर, जो यह जांचता है कि कोई एजेंट कमांड-लाइन इंटरफेस के भीतर जटिल पेशेवर कार्य पूरे कर सकता है या नहीं और परिणाम को पूरे किए गए कार्यों के प्रतिशत के रूप में स्कोर करता है, Opus 5.5 ने 66.4% स्कोर किया। यह Fable 5.1 के 55.8% और GPT-6 Astra के 57.9% से आगे रहा। FrontierCode, जो इसी पास-रेट स्कोरिंग के जरिए यह जांचता है कि किसी एजेंट के कोड बदलाव वास्तविक इंजीनियरिंग पाइपलाइन में सचमुच मर्ज किए जाएंगे या नहीं, उसमें Opus 5.5 ने 54.4% स्कोर किया, जबकि Fable 5.1 का स्कोर 50.3% था।
GDPval-AA v2.1 पर, जो 44 पेशों में वास्तविक दुनिया के पेशेवर कार्य का Elo के जरिए मूल्यांकन करता है—यह वही शतरंज-शैली रैंकिंग सिस्टम है जो किसी फ्लैट प्रतिशत के बजाय सापेक्ष कौशल मापता है—Opus 5.5 ने 1846 स्कोर किया, जबकि Fable 5.1 का स्कोर 1735 और Opus 5 का 1708 था।
हालांकि, Opus 5.5 हर जगह आगे नहीं है। AutomationBench पर, जो Zapier द्वारा तैयार किया गया बेंचमार्क है और यह मापता है कि कोई एजेंट बिना मानवीय मदद के शुरू से अंत तक पूरा बिजनेस वर्कफ्लो संभाल सकता है या नहीं, GPT-6 Astra का 41.4% स्कोर Opus 5.5 के 40.0% से थोड़ा आगे रहा।
Terminal-Bench-Science 0.1 पर, जो उसी पास-रेट पद्धति का उपयोग करते हुए कमांड-लाइन वातावरण में किए गए एजेंटिक वैज्ञानिक अनुसंधान का परीक्षण करता है, Astra का 64.6% स्कोर Opus 5.5 के 58.7% को अधिक अंतर से पछाड़ता है।
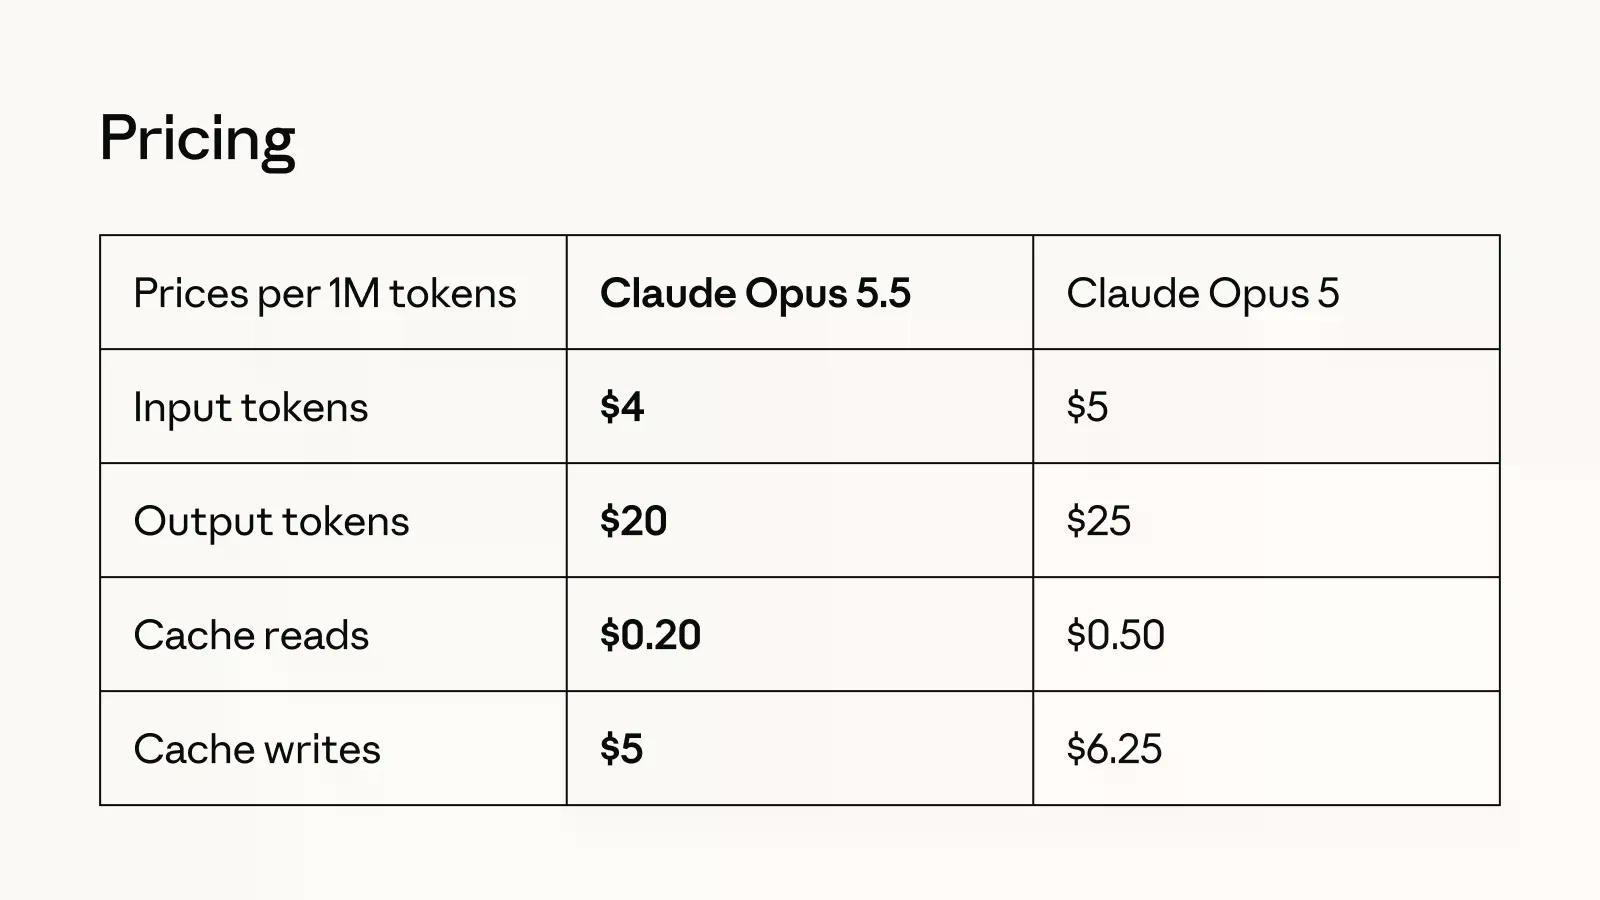
इसकी बड़ी सेलिंग पॉइंट लागत है। इनपुट टोकन—टेक्स्ट के वे हिस्से जिन्हें मॉडल पढ़ता और लिखता है, और जिनकी कीमत प्रति दस लाख के हिसाब से तय होती है—अब Opus 5.5 के लिए $4 हैं, जबकि Opus 5 के लिए यह $5 थी। वहीं आउटपुट टोकन की कीमत $25 से घटकर $20 हो गई है। Cache reads, यानी जिस संदर्भ को मॉडल पहले ही प्रोसेस कर चुका है उसे दोबारा शुरू से प्रोसेस करने के बजाय पुन: उपयोग करना—जो लंबे एजेंटिक कोडिंग सेशंस में लागत का बड़ा हिस्सा बनता है—60% घटकर $0.20 प्रति दस लाख टोकन हो गया है।
क्योंकि Opus 5.5 उन दो क्षमताओं में Anthropic के Mythos-class मॉडलों के बराबर है—यह कंपनी का सबसे प्रतिबंधित टियर है, जो सत्यापित साइबरसिक्योरिटी और बायोलॉजी शोधकर्ताओं के लिए आरक्षित है—इसलिए इसे Fable 5.1 जैसी ही सुरक्षा व्यवस्थाओं के साथ लॉन्च किया गया है।
ज्यादातर साइबरसिक्योरिटी कार्यों को स्वतः पुराने Opus 4.8 पर रीरूट कर दिया जाता है, जिसकी शिकायत पहले कई डेवलपर्स और उपयोगकर्ता कर चुके हैं।
Opus 5.5 अब Anthropic के सभी प्लेटफॉर्म्स पर लाइव है, जिनमें Amazon Web Services, Google Cloud और Microsoft Azure शामिल हैं। Anthropic के मुताबिक, Sonnet 5.5 और Haiku 5.5 आने वाले हफ्तों में जारी किए जाएंगे, और वही कीमत कटौती पूरे लाइनअप में नीचे तक लागू होगी।







