

एंथ्रोपिक ने मंगलवार को क्लॉड फेबल 5.1 और क्लॉड मिथोस 5.1 जारी किए, जो 9 जून को फेबल 5 लॉन्च होने के बाद से मिथोस-क्लास मॉडल लाइन में इसका पहला अपडेट है।
कंपनी का दावा है कि नए एआई मॉडल "कोडिंग और ज्ञान-कार्य के लिए दुनिया के सबसे उन्नत" हैं, और यह एक लॉन्च चक्र के तीन महीने बाद आया है जिसमें पहले ही 18-दिवसीय निर्यात-नियंत्रण शटडाउन, सदस्यता पहुंच को लेकर मध्य-ग्रीष्मकालीन मूल्य निर्धारण विवाद, और क्लॉड ओपस 5 का जुलाई में रिलीज शामिल है, जिसने फेबल 5 को कीमत में मात दी थी।
एंथ्रोपिक के अनुसार, फेबल 5.1 और मिथोस 5.1 एक ही अंतर्निहित मॉडल हैं जिसमें विभिन्न सुरक्षा फिल्टर लगाए गए हैं। फेबल 5.1 क्लॉड खाते वाले किसी भी व्यक्ति के लिए सामान्य रूप से उपलब्ध है। मिथोस 5.1 एंथ्रोपिक के साइबर सत्यापन कार्यक्रम और जीवन विज्ञान सत्यापन कार्यक्रम के माध्यम से सत्यापित साइबर सुरक्षा और जीवन विज्ञान पेशेवरों तक ही सीमित है, जो प्रोजेक्ट ग्लासिंग एक्सेस ट्रैक का उत्तराधिकारी है जिसने मिथोस 5 तक पहुंच को सीमित किया था।
वास्तव में बेंचमार्क क्या मापते हैं
एंथ्रोपिक का मुख्य आंकड़ा टर्मिनल-बेंच-साइंस 0.1 से आता है, एक बेंचमार्क जो यह परीक्षण करता है कि क्या एक एआई एजेंट कमांड-लाइन वातावरण के भीतर वैज्ञानिक अनुसंधान कार्य कर सकता है, जिसे उत्तीर्ण दर के रूप में स्कोर किया जाता है।
फेबल 5.1 ने फेबल 5 के 24.7% और ओपस 5 के 29.0% के मुकाबले 52.6% हासिल किया, जो अपने पूर्ववर्ती से दोगुने से भी अधिक है।
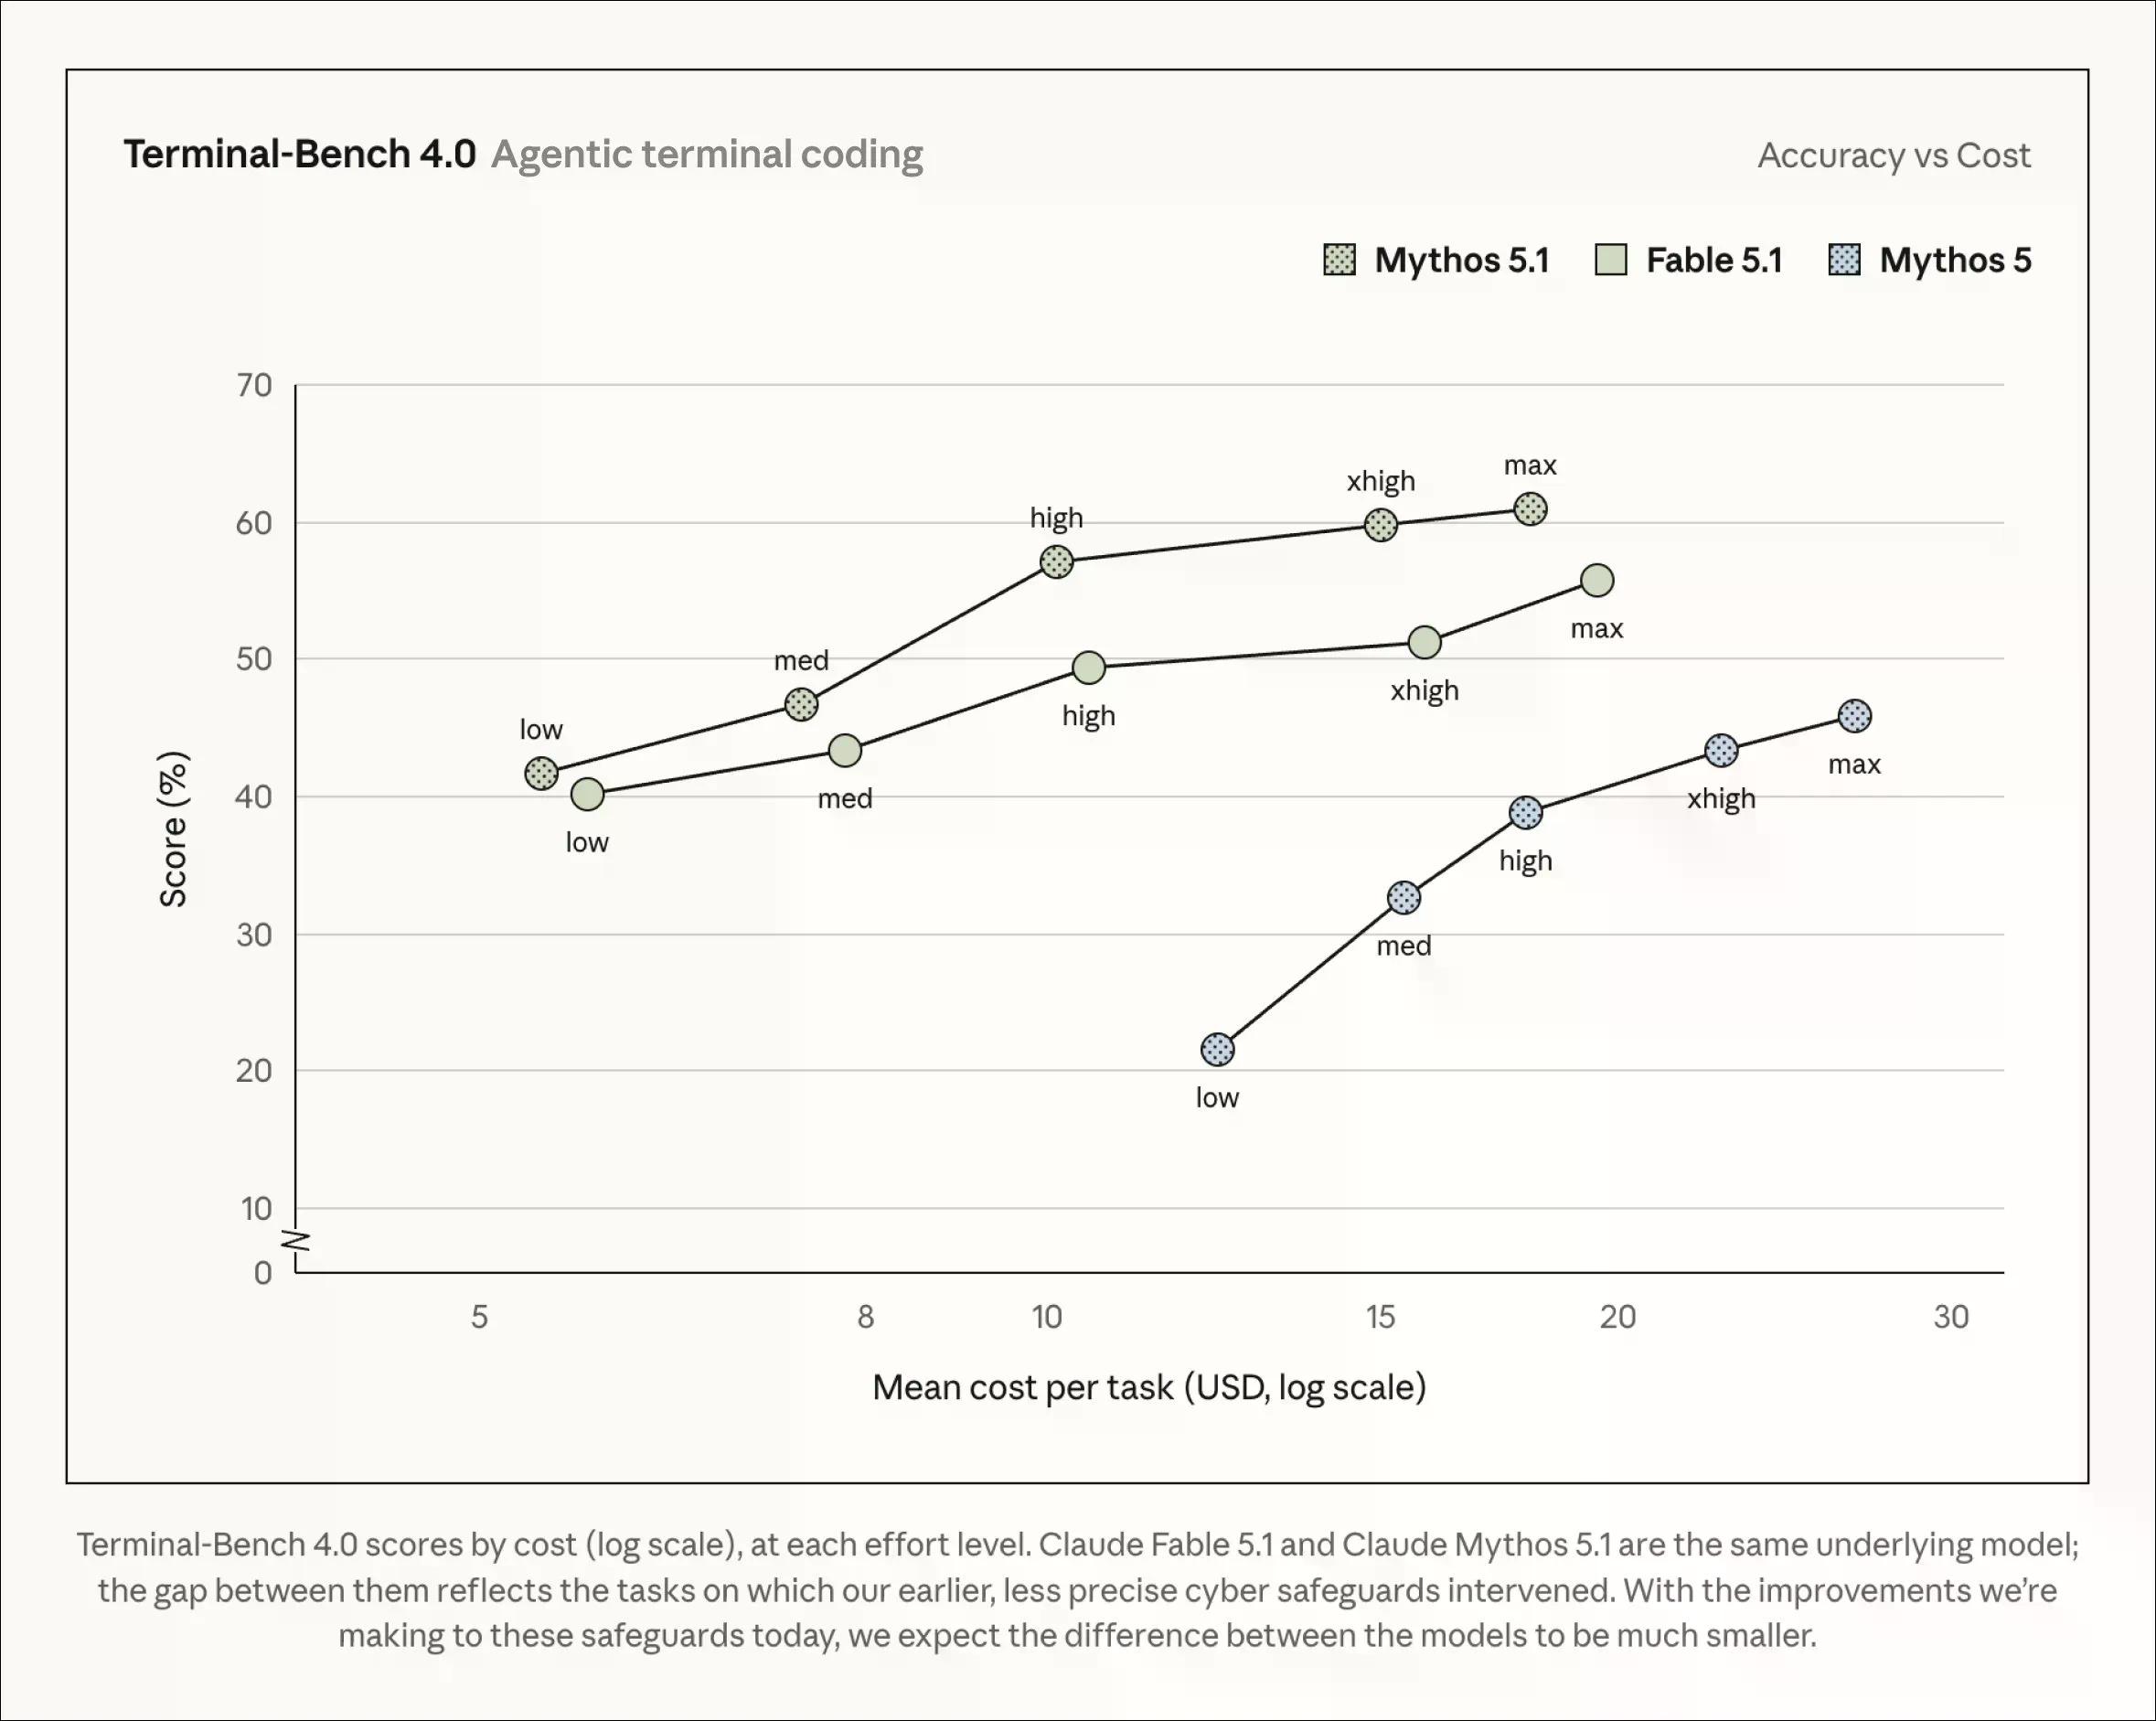
टर्मिनल-बेंच 4.0 एक टर्मिनल के माध्यम से किए गए एजेंटिक कोडिंग का परीक्षण करता है—बहु-चरणीय कमांड-लाइन सत्रों में कोड लिखना, चलाना और डीबग करना, जिसे सही ढंग से पूर्ण किए गए कार्यों के प्रतिशत के रूप में स्कोर किया जाता है। फेबल 5.1 ने 55.8% स्कोर किया, जो फेबल 5 के 42.0% से ऊपर और ओपस 5 के 52.3% से आगे है।
हल्के साइबर सुरक्षा फिल्टर के साथ चलने वाले मिथोस 5.1 ने उसी परीक्षण में 60.9% स्कोर किया; एंथ्रोपिक का कहना है कि यह अंतर उन कार्यों को दर्शाता है जिन्हें उसके सुरक्षा उपायों ने बाधित किया और ओपस 4.8 पर पुनर्निर्देशित किया।
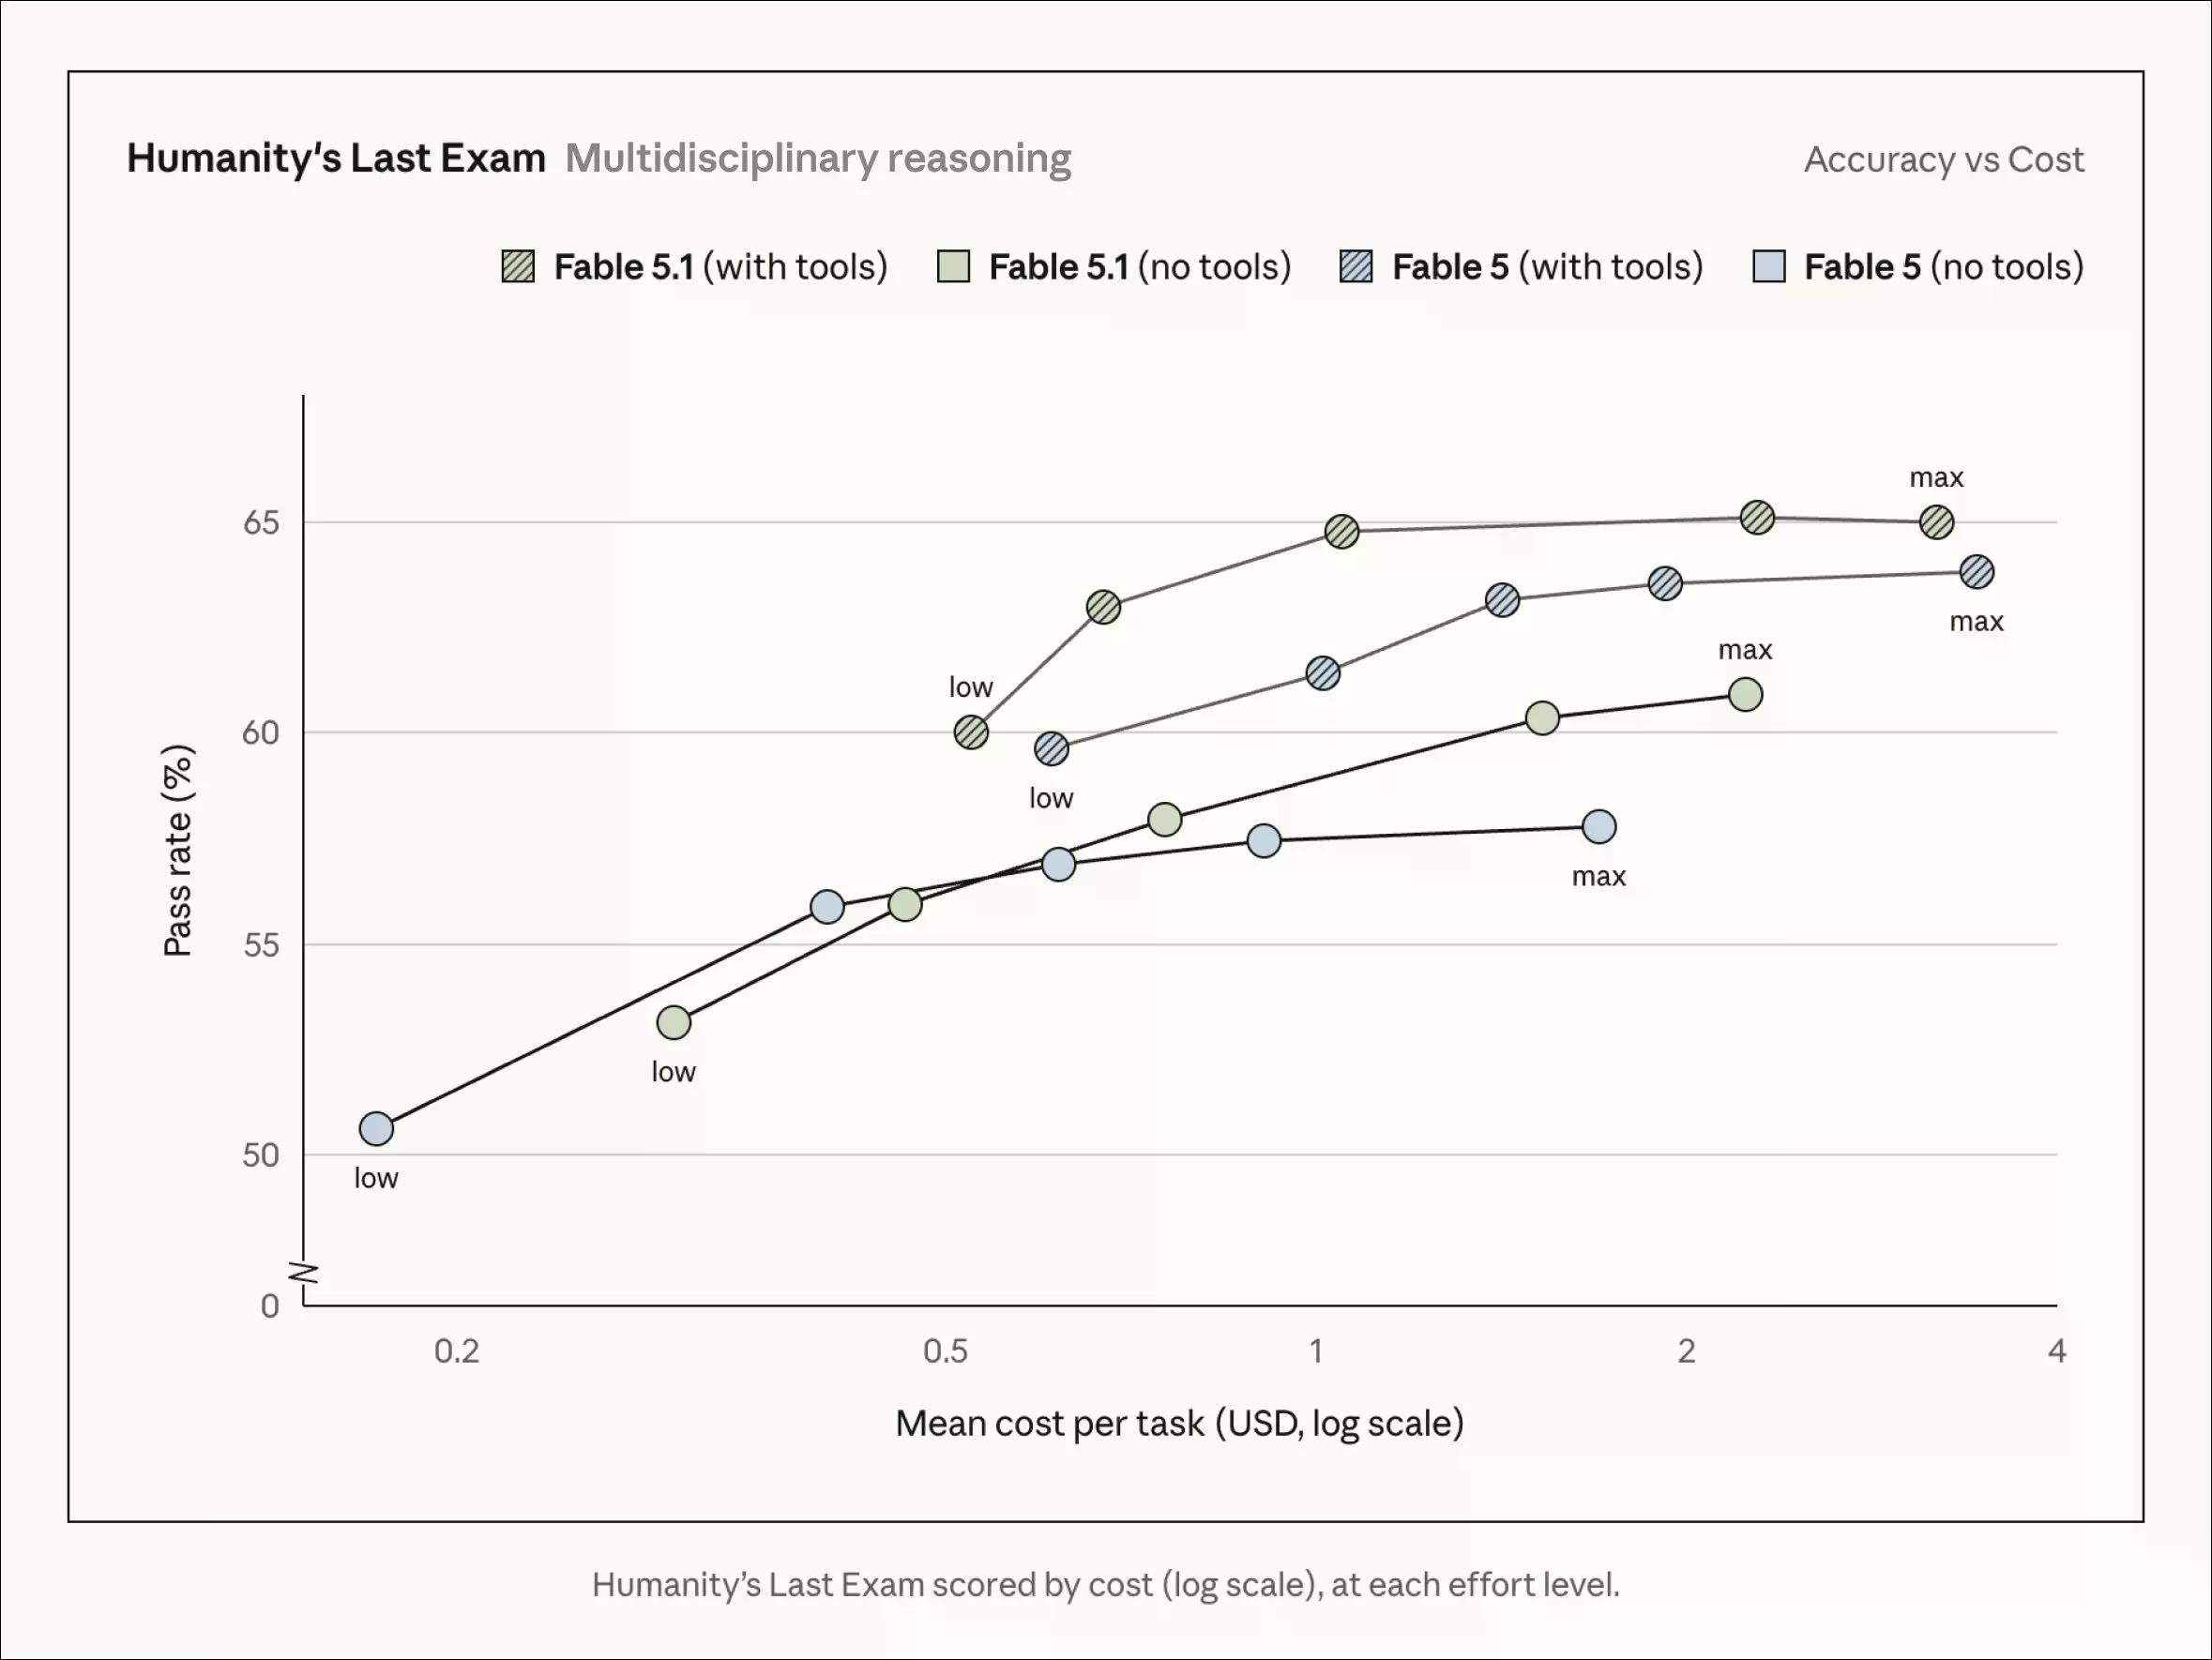
ह्यूमैनिटीज़ लास्ट एग्जाम पर, विभिन्न शैक्षणिक क्षेत्रों के विशेषज्ञ-स्तरीय प्रश्नों से निर्मित एक बहु-विषयक तर्क परीक्षण जिसे उत्तीर्ण दर के रूप में स्कोर किया गया था, फेबल 5.1 ने बाहरी उपकरणों के बिना 60.9% और उनके साथ 65.0% हासिल किया, दोनों ही ओपस 5 से आगे हैं, यह दर्शाता है कि यह अकादमिक उद्देश्यों के लिए एंथ्रोपिक का सबसे उन्नत मॉडल है।
जहां यह ओपस 5 को हराता है, और जहां गणित अधिक जटिल हो जाता है
ओपस 5 जुलाई में लॉन्च हुआ, जिसकी प्रति-टोकन कीमत फेबल 5 की आधी थी, जबकि अधिकांश प्रमुख बेंचमार्क पर फेबल 5 से बेहतर प्रदर्शन किया, जिससे अधिकांश भुगतान करने वाले उपयोगकर्ताओं के लिए फ्लैगशिप मॉडल प्रभावी रूप से अनावश्यक हो गया।
फेबल 5.1 इसे पलट देता है: यह अब एंथ्रोपिक द्वारा प्रकाशित हर बेंचमार्क पर ओपस 5 को हराता है, जिसमें वे भी शामिल हैं जहां ओपस 5 ने पहले फेबल 5 को हराया था।
लेकिन फेबल 5.1 की प्रति टोकन लागत अभी भी ओपस 5 से दोगुनी है—$10 इनपुट और $50 आउटपुट बनाम ओपस 5 के $5 और $25। टोकन एक मॉडल द्वारा संभाली जा सकने वाली जानकारी की मूल मात्रा होती हैं (आमतौर पर एक औसत अंग्रेजी शब्द के लगभग दो तिहाई), और कंपनियां उपयोग के लिए भुगतान करती हैं क्योंकि भारी कार्यप्रवाह आमतौर पर सदस्यता योजनाओं में निर्धारित कोटे को बहुत जल्दी समाप्त कर देते हैं।
मॉडल के लिए एंथ्रोपिक का अपना प्रस्ताव कच्चे स्कोर के बजाय प्रयास स्तरों पर आधारित है: यह कहता है कि फेबल 5.1 को कम या मध्यम तर्क प्रयास पर चलाने से फेबल 5 के पुराने परिणाम बहुत कम लागत पर मिलते हैं या उन्हें मात देते हैं, जबकि शीर्ष प्रयास स्तरों को उन समस्याओं के लिए आरक्षित रखा जाता है जो बाकी सभी को हैरान कर देती हैं।
नियमित काम के लिए, ओपस 5 को पूरी तरह से छोड़ने का यह तर्क जितना कम प्रयास होता है, उतना ही कमजोर होता जाता है।
पहुंच उसी विभाजन का अनुसरण करती है जो फेबल 5 पर लागू होता था, महीनों तक एंथ्रोपिक द्वारा शर्तों को समायोजित करने के बाद। प्रो योजनाओं और मानक टीम या एंटरप्राइज सीटों पर, फेबल 5.1 पूरी तरह से पे-एज़-यू-गो उपयोग क्रेडिट से आकर्षित होता है, जिसे एपीआई दर पर बिल किया जाता है, क्योंकि यह उन योजनाओं की साप्ताहिक सीमाओं का हिस्सा नहीं है। मैक्स योजनाओं और प्रीमियम टीम या एंटरप्राइज सीटों पर, इसे सदस्यता के एक मानक हिस्से के रूप में साप्ताहिक उपयोग के 50% तक शामिल किया जाता है।
क्लॉड फेबल 5.1 अब क्लॉड एपीआई, अमेज़ॅन बेडरॉक, गूगल क्लाउड और माइक्रोसॉफ्ट फाउंड्री पर "claude-fable-5-1" मॉडल आईडी के तहत उपलब्ध है।







