

आज AI से जुड़ा एक अध्ययन देखने के बाद घबराए हुए सोशल मीडिया यूजर्स के मुताबिक, इंटरनेट की गुमनामी जैसा हम उसे जानते थे, अब खत्म होने की कगार पर है।
आज X और Reddit पर फिर से वायरल हो रहा यह रिसर्च पेपर फरवरी के एक अध्ययन पर आधारित है, और इसके निष्कर्षों का सार इंटरनेट पर गुमनाम रहने वाले यूजर्स को बुरी तरह डरा रहा है: AI किसी अनाम अकाउंट से पता लगा सकता है कि आप वास्तव में कौन हैं।
इस पेपर का शीर्षक "Large-scale online deanonymization with LLMs" है, और इसे ETH Zurich तथा AI सेफ्टी ग्रुप MATS के शोधकर्ताओं ने Anthropic के शोधकर्ता Nicholas Carlini के साथ मिलकर तैयार किया है। Anthropic वही कंपनी है, जिसने Claude बनाया है।
शोधकर्ताओं का दावा है कि बड़े भाषा मॉडल, यानी Claude, ChatGPT और Gemini जैसे AI सिस्टम, किसी व्यक्ति की अनाम पोस्ट्स पढ़कर पता लगा सकते हैं कि वह असल जिंदगी में कौन है। यह किसी हैकिंग के जरिए नहीं, बल्कि पढ़ने, खोजने और तर्क करने के जरिए होता है—ठीक वही काम, जो ये चैटबॉट्स रोजमर्रा के लाखों साधारण कामों के लिए पहले से करते हैं।
शोधकर्ताओं ने एक ऐसा AI बनाया है, जो किसी भी "anonymous" Reddit अकाउंट को $2 से कम लागत में एक मिनट के भीतर डॉक्स कर सकता है।
ETH Zurich और Anthropic ने एक भयावह पेपर प्रकाशित किया है, जो साबित करता है कि इंटरनेट पर "practical anonymity" आधिकारिक रूप से खत्म हो चुकी है।
उन्होंने एक पूरी तरह स्वायत्त AI पाइपलाइन बनाई है, जो आपकी… pic.twitter.com/XMeXifhDf3
— Superman (@thesupermannx) 23 सितंबर, 2026
पेपर में लिखा है, “हमारे परिणाम दिखाते हैं कि ऑनलाइन छद्मनाम वाले यूजर्स की रक्षा करने वाली व्यावहारिक अस्पष्टता अब कायम नहीं रही, और ऑनलाइन प्राइवेसी के लिए थ्रेट मॉडल्स पर फिर से विचार करने की जरूरत है।”
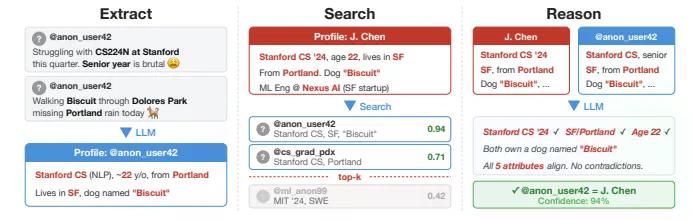
शोधकर्ताओं ने इस हमले को चार चरणों में बांटा, जिन्हें उन्होंने Extract, Search, Reason और Calibrate नाम दिया।
“Extract” का मतलब है किसी व्यक्ति की पोस्ट्स AI को देना और उससे उस व्यक्ति का सार बनवाना: वह कहां रहता हो सकता है, उसका काम क्या है, उसके शौक क्या हैं, यहां तक कि ब्रिटिश स्पेलिंग जैसी कोई खास आदत या चलते-चलते लिया गया उसके कुत्ते का नाम भी।
“Search” उस सारांश को एक एम्बेडिंग में बदल देता है—अंकों की एक ऐसी स्ट्रिंग, जिसका इस्तेमाल कंप्यूटर हजारों उम्मीदवारों में से तुरंत मिलती-जुलती प्रोफाइल्स खोजने के लिए कर सकता है।
“Reason” वह चरण है, जहां एक अधिक शक्तिशाली मॉडल सबसे उपयुक्त कुछ मैचों को देखता है और तय करता है कि वास्तव में कौन-सा व्यक्ति सबसे बेहतर फिट बैठता है। यह विवरणों का क्रॉस-चेक इंसानी अन्वेषक की तरह करता है, बस कहीं ज्यादा तेज़ी से।
“Calibrate” में AI अपने ही कॉन्फिडेंस को रेट करता है, ताकि वह तभी अनुमान लगाए जब उसे पर्याप्त यकीन हो, और अन्यथा चुप रहे।
एक परीक्षण में, टीम ने मुख्यतः छद्मनाम वाले Hacker News मैसेज बोर्ड के 338 ऐसे यूजर्स को इकट्ठा किया, जिन्होंने अपनी बायो में LinkedIn प्रोफाइल लिंक की हुई थी। फिर उन्होंने पहचान बताने वाली हर जानकारी हटा दी और एक AI एजेंट से सिर्फ वेब सर्च का इस्तेमाल करते हुए यह पता लगाने को कहा कि वे कौन हैं। AI ने उनमें से 226 लोगों, यानी 67%, की सही पहचान की, और जिन मामलों में उसने वास्तव में अनुमान लगाया, उनमें लगभग हर 10 में से 1 अनुमान गलत था।
एक अलग परीक्षण में, Anthropic के 125 वैज्ञानिकों के साथ किए गए उसके अपने इंटरव्यू रिसर्च की ट्रांसक्रिप्ट्स पर, AI ने केवल इस आधार पर कि वे अपने काम का वर्णन कैसे करते हैं, कम से कम 9 लोगों की सही पहचान कर ली।
यह सब करने की लागत ही यहां असली खोज है। पेपर के मुताबिक, ऐसी एक खोज चलाने में AI सब्सक्रिप्शन फीस के रूप में $1 से $4 तक का खर्च आता है।
इसके लिए न डेटा ब्रीच चाहिए, न हैक, न इनसाइडर एक्सेस। यह वही वेब सर्च और समरीकरण क्षमताएं इस्तेमाल करता है, जो सामान्य चैटबॉट्स में पहले से मौजूद हैं। शोधकर्ताओं का तर्क है कि यही वजह है कि इसे रोकना मुश्किल है: बंद करने के लिए कोई एकल “इस व्यक्ति की पहचान उजागर करो” स्विच नहीं है, बल्कि अलग-अलग देखने पर हानिरहित लगने वाले कार्यों की एक श्रृंखला है।
ऐसा पहली बार नहीं हुआ है कि कुछ बिखरे हुए विवरणों ने किसी की पहचान खोल दी हो। 2008 में शोधकर्ताओं ने Netflix के कथित रूप से अनाम मूवी-रेटिंग डेटासेट को सार्वजनिक IMDb रिव्यूज़ से मिलान करके तोड़ दिया था। फर्क यह है कि अब AI यह मिलान साफ-सुथरी स्प्रेडशीट्स की बजाय बिखरे, असंरचित टेक्स्ट—जोक्स, कमेंट्स और चलते-फिरते किए गए उल्लेखों—पर करता है, और वह भी अपने आप।
पेपर में दिए गए सबसे डरावने लगने वाले आंकड़ों के साथ एक महत्वपूर्ण शर्त भी जुड़ी है। सफलता मापने के लिए शोधकर्ताओं को ऐसे विषय चाहिए थे, जिनकी वास्तविक पहचान उन्हें पहले से पता हो। इसलिए उन्होंने ऐसे अकाउंट चुने, जो पहले से LinkedIn से लिंक थे, या फिर एक ही व्यक्ति की पोस्ट हिस्ट्री को दो हिस्सों में बांटकर उनके बीच का संबंध छिपा दिया।
यह एक नियंत्रित, सर्वश्रेष्ठ-स्थिति वाला सेटअप है, न कि इस बात का प्रमाण कि आज किसी भी यादृच्छिक छद्मनाम अकाउंट को तोड़ा जा सकता है।
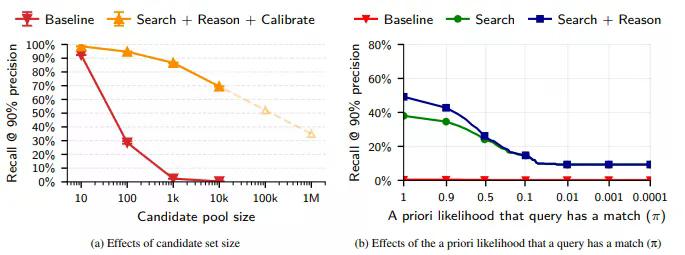
स्केल भी अध्ययन के सबसे डरावने आंकड़ों के खिलाफ जाता है। जितना बड़ा संभावित उम्मीदवारों का ढेर होगा, सुई को ढूंढना उतना ही मुश्किल होगा। 89,000 उम्मीदवारों के पूल के मुकाबले, सबसे शक्तिशाली AI पद्धति भी 90% प्रिसिजन पर केवल लगभग आधे सही मैच ही पकड़ पाई। यहां प्रिसिजन का मतलब है कि उसके अनुमान कितनी बार सही थे, और रिकॉल का मतलब है कि वह कुल वास्तविक मैचों में से कितनों को पकड़ पाई।
शोधकर्ताओं ने अपने टूल्स, प्रॉम्प्ट्स या जिन वास्तविक नामों की उन्होंने पहचान की, उनमें से किसी को भी प्रकाशित नहीं किया। अध्ययन रिलीज से पहले एथिक्स रिव्यू बोर्ड से भी गुजरा। वे किसी को डॉक्सिंग किट नहीं थमा रहे हैं। वे सिर्फ एक ऐसी क्षमता का दस्तावेजीकरण कर रहे हैं, जो लेखकों के अनुसार मौजूदा AI मॉडल्स में पहले से मौजूद है—चाहे यह पेपर हो या न हो।
यह क्यों मायने रखता है, भले ही आपने कभी Reddit पर पोस्ट न किया हो
क्रिप्टो यूजर्स इस डर को पहले से बहुत अच्छी तरह जानते हैं। 2025 के Coinbase डेटा ब्रीच सहित कई घटनाओं के बाद डॉक्सिंग और अपहरण की कोशिशों की लहर ने दिखा दिया कि लीक हुई पहचान कितनी तेजी से किसी के दरवाजे तक पहुंचने वाले वास्तविक पते में बदल सकती है।
AI-चालित डी-एनॉनिमाइजेशन वही खतरा है, बस इसमें ब्रीच हटा दिया गया है: यह उसी सार्वजनिक सामग्री पर काम करता है, जो आप पहले से पोस्ट कर चुके हैं, किसी लीक की जरूरत नहीं।
यह खुलासा Anthropic द्वारा यह बताने के कुछ महीनों बाद आया है कि राज्य-समर्थित हैकर्स ने Claude का इस्तेमाल लगभग पूरे साइबर-जासूसी अभियान को खुद चलाने के लिए किया था—यह याद दिलाता है कि AI के दुरुपयोग पर शोध, उसे रोकने के लिए बनाए गए गार्डरेल्स से लगातार आगे निकल रहा है।
जो लोग एक्टिविज्म, उत्पीड़न, यौन पहचान, इमिग्रेशन स्टेटस या ऐसे पेशे की वजह से छद्मनाम के तहत पोस्ट करते हैं, जहां सार्वजनिक राय रखना पसंद नहीं किया जाता, उनके लिए इसका मतलब है कि पुराने कमेंट्स में सालों से बिखरे हुए गृह-नगर, नियोक्ता, यहां तक कि पालतू जानवर का नाम भी मिलकर एक फिंगरप्रिंट बन जाते हैं। यह पहले भी संभव था—AI सिर्फ इसे ज्यादा तेज़ और सस्ता बना देता है।
लेकिन अगर इस तरह की डॉक्सिंग चिंता का विषय है, तो समाधान घबराहट नहीं, बल्कि आदत है: किसी एक छद्मनाम से जुड़ी विशिष्ट, पहचान बताने वाली जानकारी कम रखें, और जो भी वास्तव में संवेदनशील हो, उसके लिए ऐसे टूल्स इस्तेमाल करें जो आपका डेटा सहेजकर ही न रखें।






 COIN

