


أطلقت شركة xAI التابعة لإيلون ماسك نموذج Grok 4.7 بعد ظهر يوم الاثنين، واصفةً إياه بأنه أفضل نموذج لديها حتى الآن، وقالت إنه "تحسن ملحوظ مقارنةً بـGrok 4.6 عند نفس السعر والسرعة".
ويأتي هذا الإطلاق بعد عدة تأجيلات واضحة. فقد تراجع ماسك عن الجدول الزمني المعلن خمس مرات على الأقل منذ أواخر يوليو: "بعد أربعة أسابيع"، ثم "بعد بضعة أسابيع"، ثم "خلال 3 إلى 4 أسابيع"، ثم "10 أيام" في 1 سبتمبر، ثم "يحتاج إلى بضعة أيام إضافية لينضج" في 11 سبتمبر.
وتقول xAI إن النموذج يقضي وقتًا أطول في معالجة المسائل الصعبة، ويعيد التحقق من إجاباته بوتيرة أكبر مقارنةً بـGrok 4.6، إلى جانب ما تصفه الشركة بأنه أقوى ضوابط الأمان لديها حتى الآن.
وعاد ماسك لاحقًا للتعليق على منصة X، واصفًا Grok 4.7 بأنه "مزيج قوي من الذكاء والسرعة وانخفاض التكلفة". ولا توجد قائمة انتظار هذه المرة—فهو متاح الآن مباشرةً في تطبيق Grok وCursor وGrok Build وواجهة xAI API.
Grok 4.7 is here.
It's a notable improvement over Grok 4.6 at the same price and speed. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) September 21, 2026
يضم Grok 4.7 ما مجموعه 2.1 تريليون مُعامل، بزيادة قدرها 40% عن 1.5 تريليون في Grok 4.6، الذي كان بدوره نسخة محسّنة من Grok 4.5. وتبلغ التكلفة دولارين لكل مليون توكن إدخال، و6 دولارات لكل مليون توكن إخراج. والمُعاملات هي عناصر الضبط الداخلية التي يعايرها النموذج أثناء التدريب، وعادة ما يعني ارتفاع عددها قدرة أكبر على تعلم الأنماط، بينما تمثل التوكنات الوحدة الأساسية للمعلومات التي يمكن لنموذج الذكاء الاصطناعي قراءتها أو توليدها.
كما أدرجت xAI بيانات تدريب إضافية مستمدة من SpaceX، شركة الصواريخ التابعة لماسك، تشمل بيانات القياس عن بُعد لأقمار Starlink، وسجلات التصنيع، وسجلات الإخفاقات الهندسية. والفكرة التسويقية هنا هي تقديم نموذج يتمتع بقدرة أفضل على الاستدلال بشأن العتاد والأنظمة الفيزيائية مقارنةً بأي نموذج دُرّب فقط على نصوص الإنترنت.
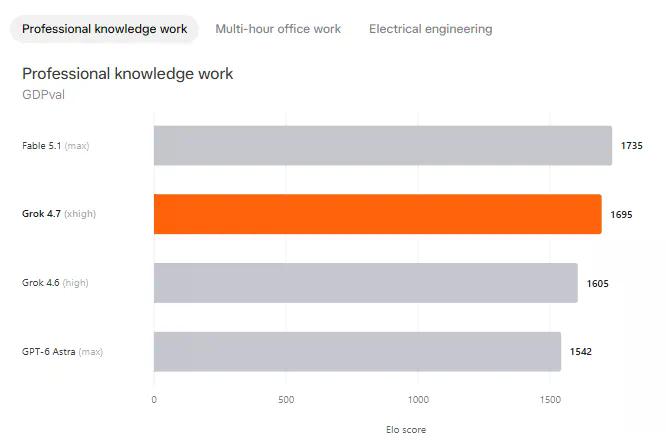
ومع ذلك، تروي نتائج المعايير القياسية قصة مألوفة. يقيس GDPval أداء النموذج في أعمال معرفية حقيقية ذات قيمة اقتصادية—مثل المذكرات القانونية، وجداول البيانات، والعروض التقديمية—باستخدام مهام راجعها متخصصون عاملون في كل مجال، ثم يمنحه تصنيف Elo، وهو نفس نظام الترتيب بالمواجهة المباشرة المستخدم في الشطرنج.
سجل Grok 4.7 عدد 1695 على GDPval. بينما تصدر Claude Fable 5.1 القائمة برصيد 1735.
أما AA-Briefcase، الذي طورته Artificial Analysis، فيختبر أعمالًا مكتبية تمتد لساعات متعددة وتجمع البحث والتحليل وإنتاج المستندات في مهمة طويلة واحدة، ويُقيَّم كذلك بمقياس Elo. وحقق Grok 4.7 درجة 1657 مقابل 1678 لـFable 5.1. النتيجة نفسها، واختبار مختلف.
ويرسم CursorBench 4.0، وهو معيار Cursor لمهام البرمجة الحقيقية داخل محرره، العلاقة بين الدقة من جهة، والتكلفة وعدد التوكنات التي تستهلكها كل مهمة من جهة أخرى. ويتموضع Grok 4.7 في المنتصف: فهو أعلى تكلفة لكل مهمة من GPT-6 Astra، وريث GPT-5.6 Sol، ومن Claude Sonnet 5، لكنه لا يزال دون Fable 5.1، الذي يتفوق عند كل نقطة سعرية على الرسم البياني.
وهذا ليس نمطًا جديدًا بالنسبة إلى xAI. فقد أُطلق Grok 4.5 في يوليو مع أكبر عنقود تدريب في القطاع، لكنه جاء في المركز الثالث خلف نماذج Claude وOpenAI. وقبله، ضحّى Grok 4.20 بالموثوقية مقابل السرعة والطابع الشخصي. كما تخلف Grok 4.6 أيضًا عن حزمة النماذج المتقدمة في الاستقلالية البرمجية.
ولا يجعل أي من ذلك Grok 4.7 منتجًا سيئًا لملايين الأشخاص الذين يتفاعلون معه عبر X أو التطبيق المستقل أو لوحة قيادة سيارات Tesla. لكنه يعني أن النموذج الأكثر ترجيحًا للإجابة عن أسئلتك، أو لتشغيل المساعد الصوتي في سيارتك، يعمل على نظام تضعه المعايير التي نشرتها الشركة نفسها بدرجة أقل من قمة السلم.
ولهذا الفارق، تصبح بطاقة السعر أهم من موقع النموذج على لوحة الصدارة بالنسبة إلى معظم الناس. فقد دأبت xAI على تقديم تكلفة أقل لكل توكن من Anthropic وOpenAI، رغم تأخرها عنهما في القدرات الخام، مراهنةً على أن "الجيد بما يكفي، والرخيص، والمتاح في كل مكان" يتفوق على "الأفضل، لكن الأعلى تكلفة" في غالبية الاستخدامات اليومية.
وكان ماسك قد خفّض التوقعات بالفعل قبل الإطلاق بأيام، إذ كتب أن Grok 4.7 ينبغي أن يكون "متقاربًا تقريبًا" مع Claude Opus 5.0 من Anthropic، وليس Opus 5.1 الأحدث، مع بقاء الأداء متعدد الوسائط بحاجة إلى مزيد من العمل.
وفي المنشور نفسه، رسم ملامح النماذج الثلاثة التالية: Grok 4.8 كقفزة ذات مغزى، وGrok 4.9 ضمن "فئة Astra/Fable"، وGrok 5 كمرشح محتمل لتصدر الطليعة. وهذه الترقيات لا تملك بعد تاريخ إطلاق محددًا. وكتب: "سنرى".







