

أطلقت OpenAI يوم الثلاثاء نموذجين جديدين، هما GPT-6 Sol وGPT-6 Luna. وجاء ذلك بعد دقائق من إطلاق Anthropic لنموذج Claude Opus 5.5، وهو نموذجها الرائد الجديد.
ويقع Sol وLuna في مرتبة أدنى من GPT-6 Astra، وهو النموذج الذي وصفته OpenAI عند إطلاقه في 3 سبتمبر بأنه "أكثر نموذج ذكاءً ومواءمةً في العالم". ولا يزال Astra هو الخيار الأول لدى OpenAI للمهام الأصعب، بينما يمثل Sol وLuna الخيارين الأسرع والأقل تكلفة والمصممين للعمل اليومي.
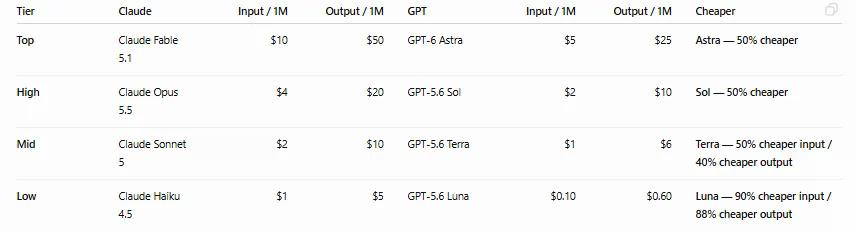
وبذلك، تبدو الاستراتيجية مشابهة جدًا لما تطبقه Anthropic. إذ يُعد Astra النظير لـ Fable، وSol النظير لـ Opus، وTerra النظير لـ Sonnet، وLuna النظير لـ Haiku (عند ترقيته).
كما عدّلت OpenAI الأسعار للحفاظ على قدرتها التنافسية. فقد خُفِّضت تكاليف واجهة برمجة التطبيقات API لكلا النموذجين بنسبة 50% مقارنة بالأسعار الترويجية لكل توكن في GPT-5.6. والتوكنات هي وحدات النص التي يقرأها النموذج ويكتبها، وغالبًا ما تكون أقل قليلًا من كلمة كاملة، وتدفع الشركات مقابلها بالمليون لأن فواتير الذكاء الاصطناعي تتراكم بهذا الشكل عند التوسع.
يرجى الترحيب بـ GPT-6 Sol وGPT-6 Luna في عالم GPT-6.
يبني GPT-6 Sol وLuna على التطورات التي تقف وراء GPT-6 Astra، ويجلبان الكثير من نقاط قوته إلى نماذج أسرع وأكثر توفيرًا لدعم العمل على نطاق واسع.
كما جعلنا التخزين المؤقت وعملية الاستدلال أكثر كفاءة، و… pic.twitter.com/5LiVE4rbFt
— OpenAI (@OpenAI) 22 سبتمبر 2026
أصبحت تكلفة Sol الآن 2 دولار لكل مليون توكن إدخال و10 دولارات لكل مليون توكن إخراج، انخفاضًا من 4 دولارات و20 دولارًا. أما Luna فانخفض إلى 0.10 دولار و0.50 دولار، بعد أن كان 0.20 دولار و1.20 دولار. وبشكل عام، تُعد OpenAI العرض الأرخص ضمن كل شريحة عند مقارنتها بـ Anthropic.
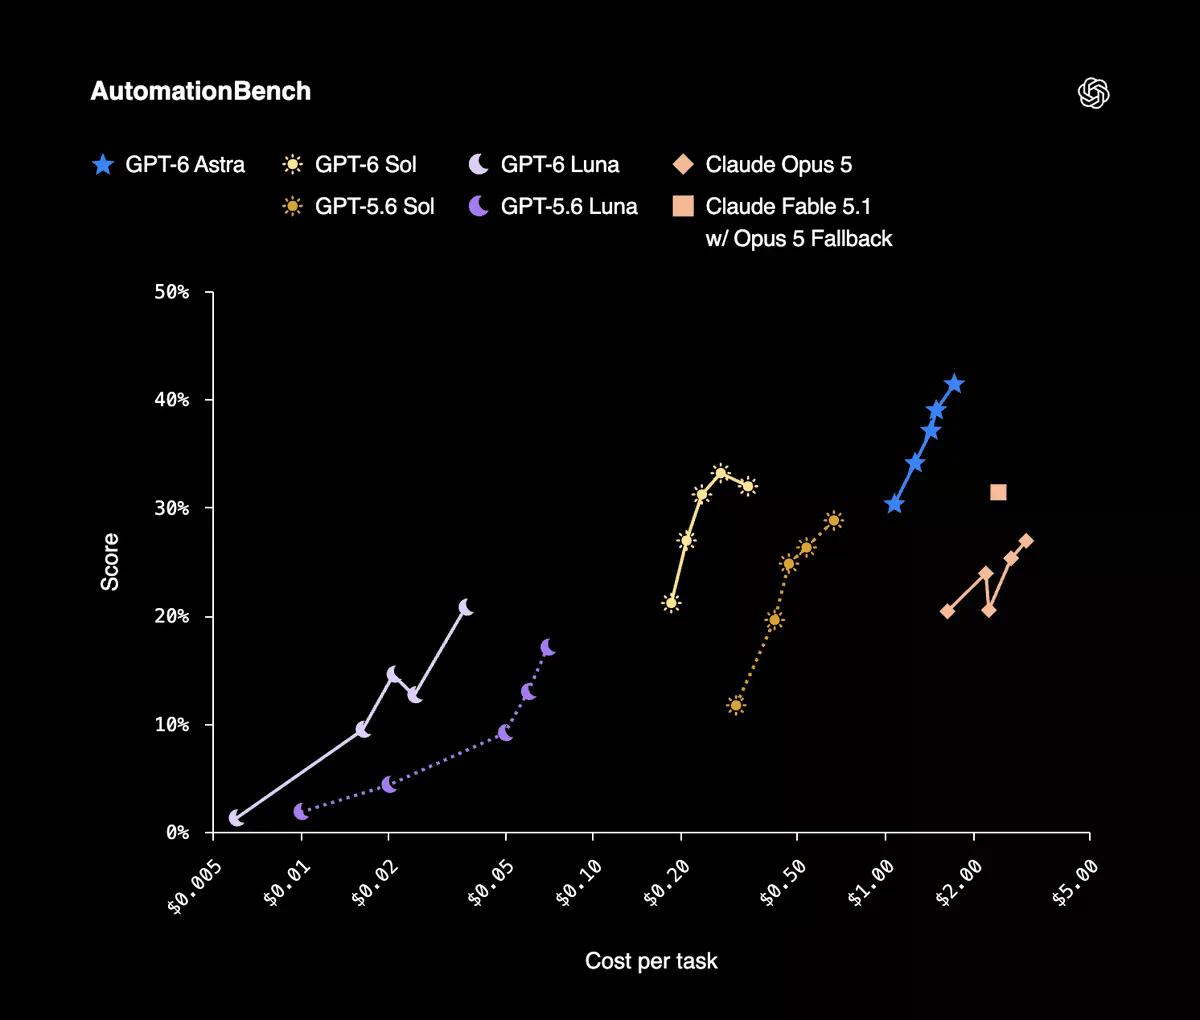
وتستند حجة الأداء إلى AutomationBench، وهو معيار بنته Zapier لاختبار ما إذا كان بإمكان وكيل ذكاء اصطناعي تنفيذ سير عمل تجاري كامل باستخدام 47 أداة تغطي المبيعات والتسويق والعمليات والدعم والمالية والموارد البشرية، ويُقاس ذلك بمعدل النجاح. وسجل GPT-6 Sol عند أعلى إعداد للاستدلال 33.2% بتكلفة 0.27 دولار لكل مهمة.
أما Claude Opus 5، فعند أعلى إعداداته الخاصة، فقد سجل 26.9%، لكنه كلف أكثر من 11 ضعفًا لكل مهمة، وفقًا لأرقام OpenAI نفسها. كما تفوق GPT-6 Sol أيضًا بفارق طفيف على Claude Fable 5.1، النموذج الرائد الأعلى تكلفة لدى Anthropic، في الاختبار ذاته.
وفي اختبار Agents' Last Exam، الذي يقيّم وكلاء الذكاء الاصطناعي في أعمال طويلة وذات قيمة اقتصادية عبر 55 قطاعًا فرعيًا، ويمنح النتائج على شكل نسبة مئوية من العمل المنجز، سجل GPT-6 Sol عند أعلى مستوى جهد 56.4%. وتقول OpenAI إن ذلك يتفوق على أفضل نتيجة لـ Claude Opus 5 مع تكلفة أقل لكل مهمة بنسبة 60%.
ويُعد جهد الاستدلال إعدادًا إضافيًا قدمته OpenAI: فعند رفعه، يقضي النموذج وقتًا أكبر ويستهلك قدرة حوسبية أعلى لمراجعة نفسه مرتين قبل الإجابة، ما يؤدي عادةً إلى رفع الدقة والتكلفة معًا.
أما في استخدام الكمبيوتر، أي عندما ينقر وكيل الذكاء الاصطناعي ويكتب ويتنقل داخل البرمجيات كما يفعل الإنسان، فقد تعادل GPT-6 Sol تقريبًا على OSWorld 2.0 مع نتيجة Claude Opus 5 عند مستوى الجهد المتوسط، بواقع 60.5% مقابل 60.3%، وبتكلفة أقل بنحو 80%. ويختبر OSWorld مهامًا حاسوبية طويلة وواقعية، ويصدر درجة جزئية بناءً على مقدار العمل الذي أُنجز بشكل صحيح.
وأصبح GPT-6 Sol وLuna متاحين الآن ضمن ChatGPT Work وCodex لمشتركي Plus وPro وBusiness وEnterprise وEdu، كما وصل Luna أيضًا إلى المستخدمين المجانيين ومستخدمي Go عبر تطبيق سطح المكتب.
ولم يدخل أي من النموذجين بعد إلى تطبيق ChatGPT العادي، وتقول OpenAI إنها تطرح كليهما تدريجيًا على مدار اليوم للحفاظ على استقرار الخدمة.







