


بالنسبة إلى عدد كبير من مستخدمي وسائل التواصل الاجتماعي المذعورين الذين اكتشفوا اليوم دراسة مرتبطة بالذكاء الاصطناعي، فهذا يعني نهاية匿名ية الإنترنت كما نعرفها.
الورقة البحثية التي عادت للتداول اليوم على X وReddit تعود إلى دراسة نُشرت في فبراير، وخلاصة نتائجها تبث الرعب في نفوس المستخدمين المجهولين عبر الإنترنت في كل مكان: الذكاء الاصطناعي يستطيع معرفة هويتك الحقيقية انطلاقًا من حساب مجهول.
تحمل الورقة عنوان "إزالة الهوية على نطاق واسع عبر الإنترنت باستخدام النماذج اللغوية الكبيرة"، وهي من إعداد باحثين في ETH Zurich ومجموعة سلامة الذكاء الاصطناعي MATS، بالتعاون مع نيكولاس كارليني، الباحث في Anthropic، الشركة المطوّرة لـClaude.
ويزعم الباحثون أن النماذج اللغوية الكبيرة، وهي أنظمة الذكاء الاصطناعي التي تقف وراء Claude وChatGPT وGemini، يمكنها قراءة منشورات شخص مجهول الهوية ومعرفة من يكون في الحياة الواقعية. ليس عبر اختراق أي شيء، بل فقط من خلال القراءة والبحث والاستدلال، وهي نفس المهام التي تنفذها هذه الدردشة الآلية أصلًا يوميًا في ملايين المهام المملة.
بنى باحثون ذكاءً اصطناعيًا يمكنه كشف هوية أي حساب Reddit "مجهول" في أقل من دقيقة مقابل دولارين.
نشرت ETH Zurich وAnthropic ورقة مرعبة تثبت أن "ال匿名ية العملية" على الإنترنت قد انتهت رسميًا.
لقد بنوا خط معالجة ذاتي التشغيل بالكامل بالذكاء الاصطناعي يأخذ بياناتك... pic.twitter.com/XMeXifhDf3
— Superman (@thesupermannx) 23 سبتمبر 2026
وجاء في الورقة: "تُظهر نتائجنا أن الغموض العملي الذي كان يحمي المستخدمين ذوي الأسماء المستعارة على الإنترنت لم يعد قائمًا، وأن نماذج التهديد المتعلقة بالخصوصية على الإنترنت تحتاج إلى إعادة نظر".
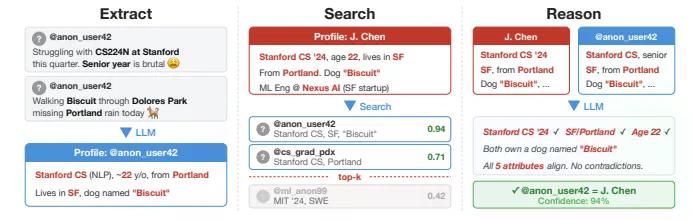
قسّم الباحثون الهجوم إلى أربع مراحل أطلقوا عليها: الاستخراج، والبحث، والاستدلال، والمعايرة.
تعني مرحلة "الاستخراج" تمرير منشورات شخص ما إلى الذكاء الاصطناعي ليُعدّ ملخصًا عنه: أين قد يعيش، وما عمله، وما هواياته، وحتى تفاصيل صغيرة مثل استخدامه للتهجئة البريطانية أو اسم كلبه الذي ورد عرضًا.
أما "البحث" فيحوّل ذلك الملخص إلى embedding، أي سلسلة من الأرقام يستطيع الكمبيوتر استخدامها للعثور فورًا على ملفات متشابهة بين آلاف المرشحين.
وتأتي مرحلة "الاستدلال" حين ينظر نموذج أكثر قوة إلى أفضل عدد قليل من التطابقات المحتملة، ويفكر في أيها يطابق الشخص فعلًا، مع التحقق المتقاطع من التفاصيل كما يفعل المحقق البشري، ولكن بسرعة أكبر بكثير.
أما "المعايرة" فتعني أن يقيّم الذكاء الاصطناعي مستوى ثقته بنفسه، بحيث لا يطلق تخمينًا إلا عندما يكون واثقًا بدرجة معقولة، ويلتزم الصمت في غير ذلك.
في أحد الاختبارات، جمع الفريق 338 مستخدمًا من منتدى Hacker News، الذي يعتمد غالبًا على الأسماء المستعارة، وكان هؤلاء قد ربطوا ملفاتهم على LinkedIn في نبذتهم التعريفية. ثم حذف الباحثون أي معلومات تعريفية، وطلبوا من وكيل ذكاء اصطناعي معرفة هوياتهم باستخدام البحث عبر الويب فقط. وتمكن من تحديد 226 منهم بشكل صحيح، أي 67%، وكان مخطئًا في نحو تخمين واحد من كل 10 تخمينات فعلية أطلقها.
وفي اختبار منفصل على نصوص مقابلات من أبحاث Anthropic الخاصة، شملت 125 عالمًا، نجح الذكاء الاصطناعي في تحديد هوية 9 أشخاص على الأقل بشكل صحيح فقط من خلال الطريقة التي وصفوا بها عملهم.
التكلفة الحقيقية للقيام بكل ذلك هي الاكتشاف الأهم هنا. فبحسب الورقة، تشغيل واحدة من هذه العمليات البحثية يكلف بين دولار واحد و4 دولارات كرسوم اشتراك في خدمات الذكاء الاصطناعي.
كما أن الأمر لا يتطلب خرق بيانات أو اختراقًا أو وصولًا من الداخل. فهو يستخدم نفس قدرات البحث عبر الويب والتلخيص المدمجة في روبوتات الدردشة العادية. ويجادل الباحثون بأن هذا تحديدًا ما يجعل من الصعب منعه: لا يوجد زر واحد يمكن تعطيله بعنوان "اكشف هوية هذا الشخص"، بل مجرد سلسلة من المهام التي تبدو غير مؤذية كلٌّ على حدة.
وليست هذه المرة الأولى التي تكشف فيها حفنة من التفاصيل هوية شخص ما. ففي عام 2008، تمكن باحثون من كسر مجموعة بيانات تقييمات الأفلام التي ادعت Netflix أنها مجهولة، وذلك عبر مطابقتها مع مراجعات IMDb العامة. والفارق الآن هو أن الذكاء الاصطناعي ينفذ هذه المطابقة على نصوص فوضوية وغير منظمة، مثل النكات والتعليقات والإشارات العابرة، بدلًا من الجداول المرتبة، ويفعل ذلك من تلقاء نفسه.
الأرقام الأكثر إثارة للخوف في الورقة تأتي مع قيد مهم يستحق التوقف عنده. فلقياس النجاح، احتاج الباحثون إلى أشخاص يعرفون هوياتهم الحقيقية مسبقًا، لذلك اختاروا حسابات كانت قد ربطت بالفعل بملفات LinkedIn، أو قاموا بتقسيم سجل منشورات شخص واحد إلى نصفين وإخفاء الرابط بينهما.
هذا إعداد مضبوط يمثل أفضل سيناريو ممكن، وليس دليلًا على أن أي حساب مستعار عشوائي يمكن كشفه اليوم.
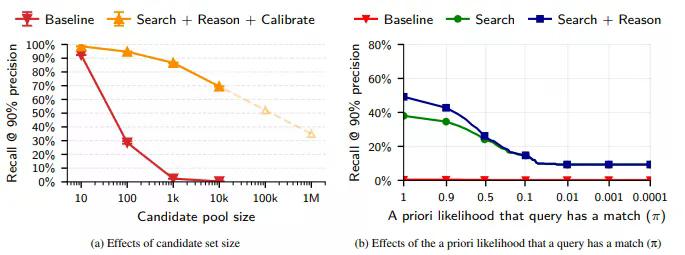
كما أن عامل الحجم يخفف أيضًا من أكثر أرقام الدراسة إثارة للقلق. فكلما كبرت كومة القش من المرشحين المحتملين، صار العثور على الإبرة أكثر صعوبة. ففي مواجهة مجموعة تضم 89,000 مرشح، لم تتمكن أقوى طريقة ذكاء اصطناعي إلا من العثور على نحو نصف التطابقات الصحيحة فقط عند دقة 90%. والمقصود بالدقة هو عدد المرات التي كانت فيها التخمينات صحيحة، بينما يشير الاسترجاع recall إلى عدد التطابقات الحقيقية التي التقطها النظام بالفعل.
كذلك لم ينشر الباحثون أدواتهم أو التعليمات الموجهة أو أيًا من الأسماء الحقيقية التي توصلوا إليها، كما خضعت الدراسة لمراجعة لجنة أخلاقيات قبل إصدارها. إنهم لا يقدمون لأحد حقيبة أدوات للتشهير وكشف الهوية. بل يوثقون قدرة يقول المؤلفون إنها موجودة بالفعل في نماذج الذكاء الاصطناعي الحالية، سواء نُشرت الورقة أم لا.
لماذا يهم هذا حتى لو لم تنشر يومًا على Reddit
يعرف مستخدمو الكريبتو هذا الخوف جيدًا. فقد أظهرت موجة من حوادث كشف الهوية ومحاولات الاختطاف التي أعقبت خرق بيانات Coinbase في 2025، إلى جانب حوادث أخرى كثيرة، مدى السرعة التي يمكن أن تتحول بها هوية مسرّبة إلى عنوان حقيقي على باب أحدهم.
إزالة الهوية المدفوعة بالذكاء الاصطناعي هي التهديد نفسه ولكن من دون خرق البيانات: فهي تعتمد فقط على ما نشرته علنًا بالفعل، ولا تحتاج إلى أي تسريب.
كما تأتي هذه الورقة بعد بضعة أشهر من كشف Anthropic أن قراصنة مدعومين من دول استخدموا Claude لتشغيل معظم حملة تجسس سيبراني بمفردهم، في تذكير بأن أبحاث إساءة استخدام الذكاء الاصطناعي ما تزال تتجاوز الضوابط المصممة لاحتوائها.
وبالنسبة إلى أي شخص ينشر تحت اسم مستعار بسبب النشاط السياسي أو الإساءة أو التوجه الجنسي أو وضع الهجرة أو وظيفة لا تتسامح مع الآراء العلنية، فهذا يعني أن المدن الأصلية وأماكن العمل وحتى اسم الحيوان الأليف، حين تكون متناثرة عبر سنوات من التعليقات القديمة، تتجمع لتكوّن بصمة تعريفية. كان ذلك ممكنًا دائمًا، لكن الذكاء الاصطناعي جعله أسرع وأرخص.
لكن إذا كان هذا النوع من كشف الهوية مصدر قلق، فالحل ليس الذعر بل العادة: تقليل التفاصيل المحددة والمعرِّفة المرتبطة بأي اسم مستعار واحد، وبالنسبة إلى أي شيء شديد الحساسية فعلًا، استخدام أدوات مصممة أصلًا بحيث لا تحتفظ ببياناتك على الإطلاق.






 COIN

